
AI モデルはセキュリティ診断やペネトレーションテストを任せられる水準に来ています。この記事では、その現在地を公開されている評価、弊社のベンチマーク、弊社の診断の実データで示したうえで、脆弱性を探す費用と得られる利益の関係(バグノミクス)がどう変わったかと、守る側に求められることを解説します。
AI モデルは脆弱性の発見も悪用もできる水準に来た
AI には以前より抽象的なゴールを任せられるようになった
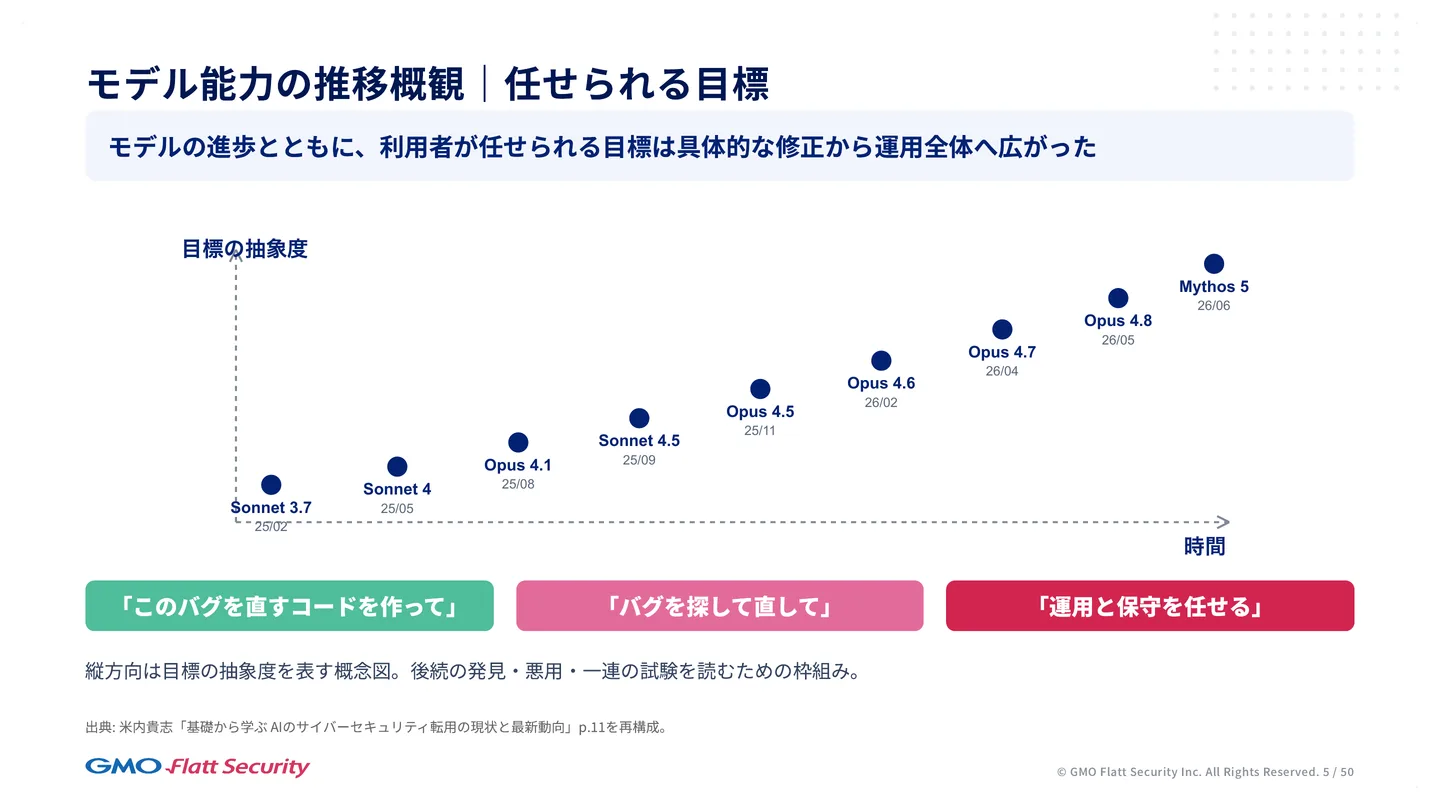
セキュリティの用途、特に脆弱性のリサーチや診断に AI モデルを使いやすくなったのは、Claude 3.7 Sonnet が出た頃です。ソースコードが与えられていれば、そこから脆弱性を探すことの難易度が格段に下がりました。ただし当時は、脆弱性のリサーチに詳しい人が「この種類の脆弱性を探したい」「この脆弱性と同じものを、別のソフトウェアでも探したい」のように、具体的なゴールを細かく与えて使うものでした。もっと広いゴールに向かって走らせることは難しかったのです。
今は、もっと抽象度の高いゴールを、自律的に任せられるようになっています。たとえば「この資産群の中から何か見つけて、データを持ち出せ」程度のゴールでも、今の AI モデルは十分に自律して進められます。最近の情報漏洩の事件も、AI モデルとハーネス(モデルにツールの呼び出しや外部との通信をさせる枠組み)を使った、手当たり次第の攻撃だと言われています。真偽は分かりませんが、そうした事件のゴールは「いろいろな所を攻撃して、何かしらのデータを抜いてこい」程度の抽象度である可能性すらあります。
この1年ほどの変化をまとめると、攻撃や診断、ペネトレーションテストに AI モデルを使うときに、モデルに与えられるゴールの抽象度が大きく上がった、ということです。以前の AI は、セキュリティの専門家の力を高める役割でしか使えず、攻撃ができる人の母集団は限られていました。今は、市販のサブスクリプションや、より安価な中国系のモデルのサブスクリプションを契約し、抽象的なゴールを渡すだけで、誰でもある程度の攻撃ができます。他人の作った道具を使うだけで攻撃する人を「スクリプトキディ」と呼びますが、いわばその強化版です。攻撃や脆弱性のリサーチができる人の母集団が大きく広がったという意味で、これは深刻な変化です。
OpenAI の Daybreak や Anthropic の CVP・Glasswing のように、セキュリティの用途に限ってモデルを提供する枠組みが広がっているのは、自然な流れです。それでも、止めきれていない悪用もあると考えられます。
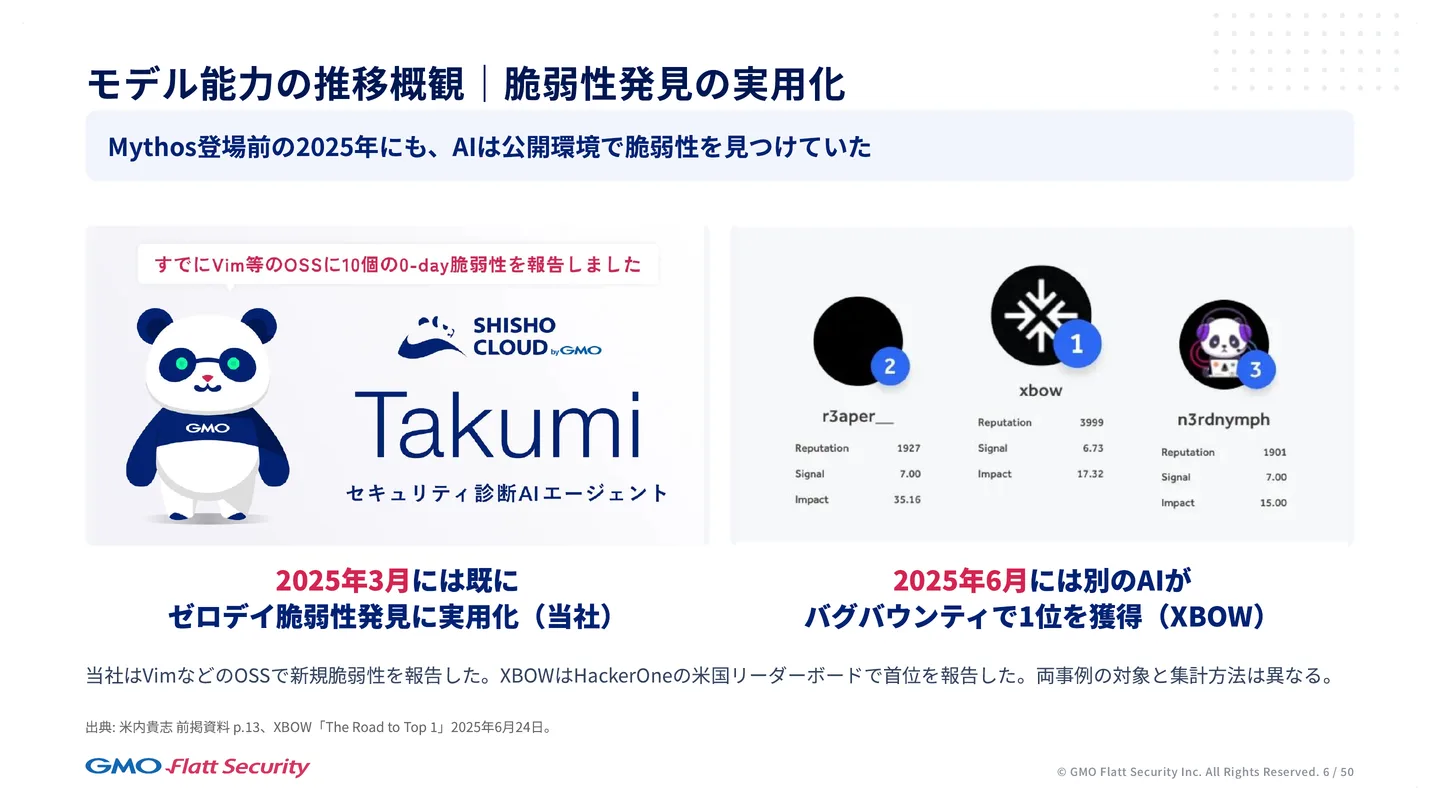
AI が脆弱性を見つける能力はもう十分に高い
AI の能力は、新しい脆弱性を見つける能力と、知られている脆弱性を悪用する能力とで、伸び方が違います。
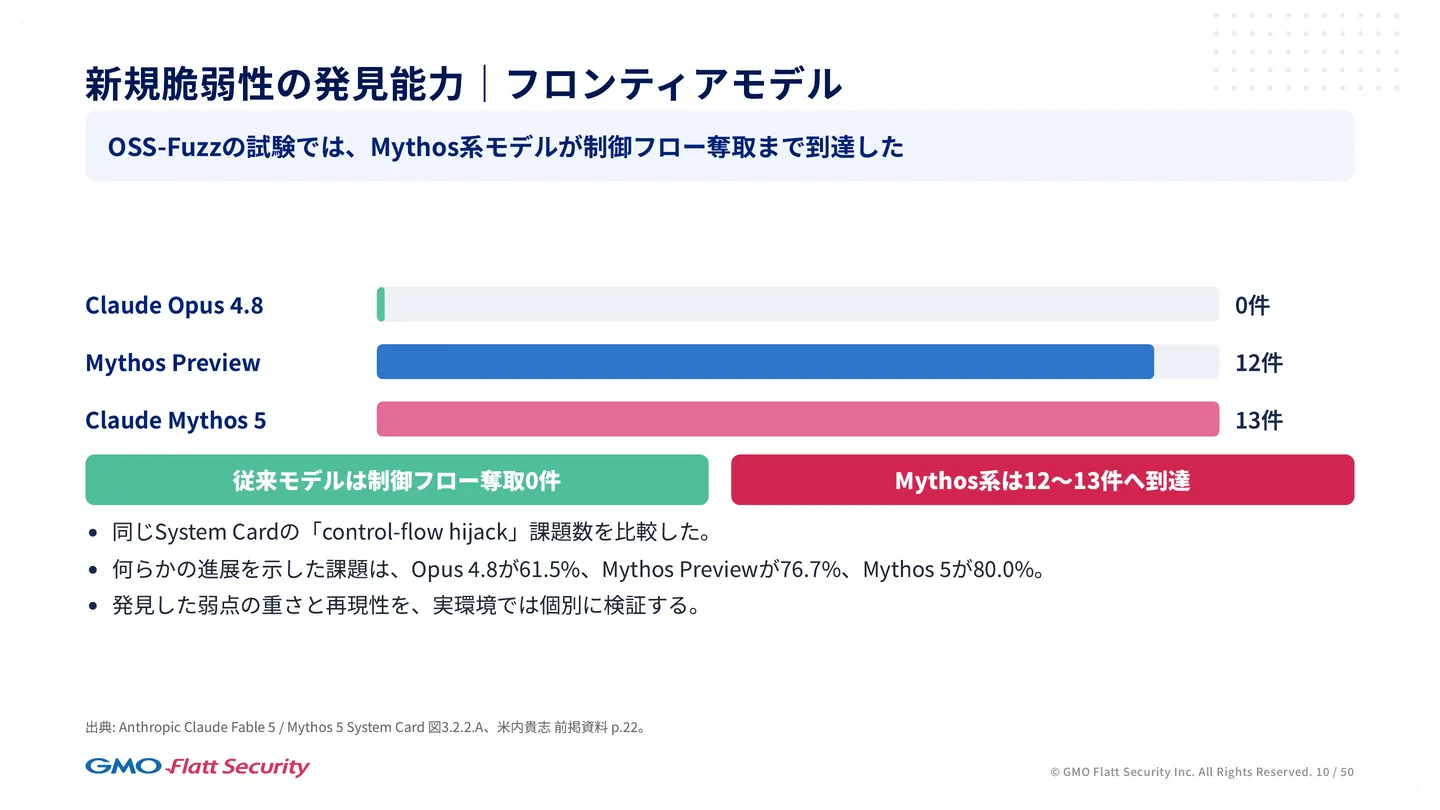
脆弱性を見つける能力は、最近のモデルで、これ以上はあまり伸びないと感じるほど高い水準にあります。Claude Opus 4.8 ほどの水準のモデルになると、コードベースに脆弱性があれば、ある程度は見つけられるようになっていました。最近、WordPress で、認証なしに遠隔からコードを実行できる大きな脆弱性 wp2shell が世の中で取り上げられましたが、これも OpenAI の GPT-5.6 Sol Ultra を使って見つけられたものです。
弊社でも、この脆弱性が公表されたときに、「このバージョンの WordPress に、認証なしで遠隔からコードを実行できる脆弱性があるらしい」という公開の情報だけを GPT 系のモデルに渡し、再現できないかを試しました。その結果、モデルは脆弱性の中身を突き止め、悪用までほとんど自力で終えました。人が行うと非常に手間のかかる調査と検証で、モデルは人間以上のリサーチャーと感じるほどの水準にあります。脆弱性を見つけることは、今の AI にとって、もう大きな壁ではなくなっています。
AI が脆弱性を悪用する能力も伸び続けている
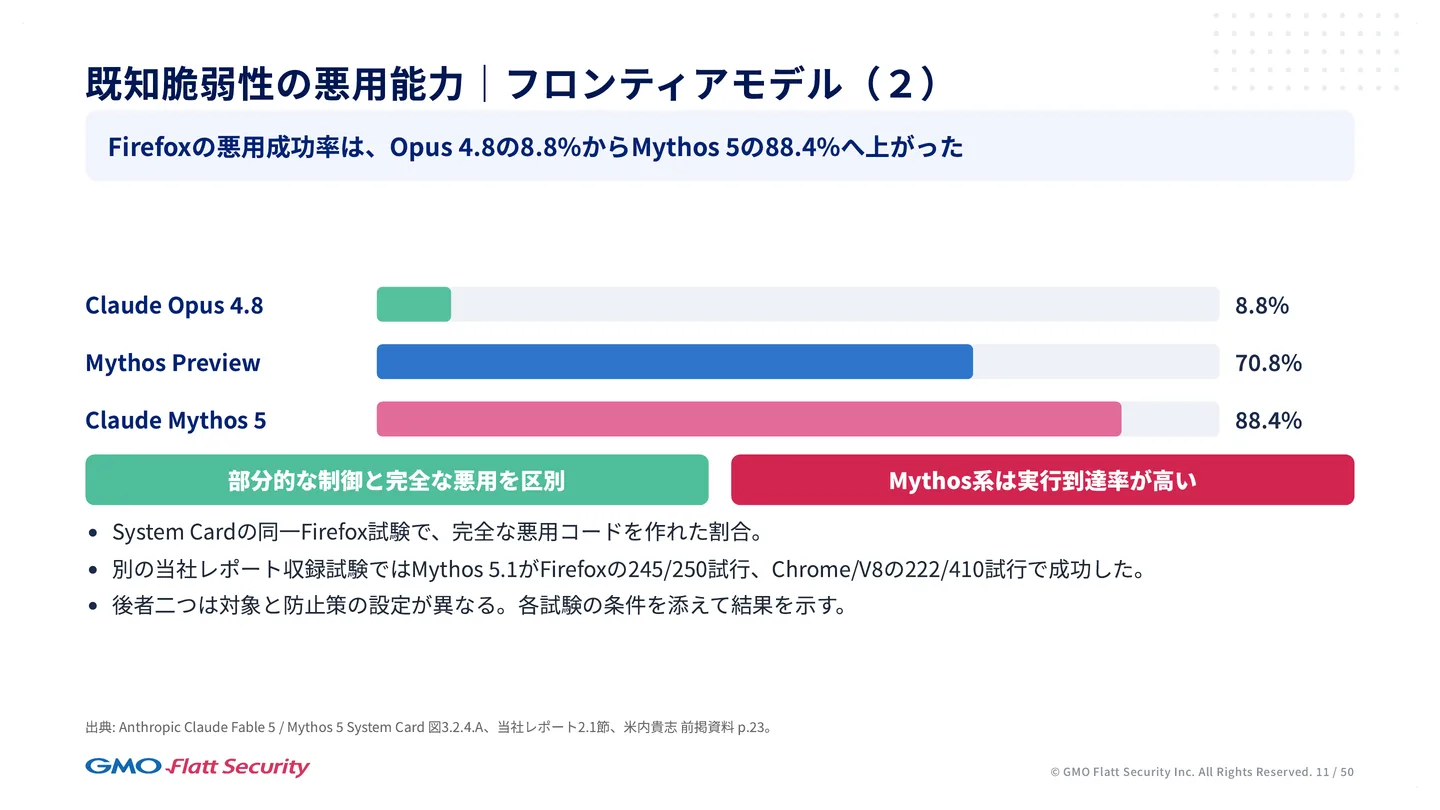
この2年ほどで大きく伸びたのは、悪用する能力のほうです。ここでいう悪用とは、脆弱性があることまで分かっている状態から、実際の被害につながる攻撃を成り立たせることです。バイナリであれば、メモリ破壊が起きると分かっている状態から、プログラムの制御を奪えるかです。Web アプリケーションであれば、たとえば認可制御の不備が1つ見つかったときに、それを使って実際にデータを持ち出せるかです。
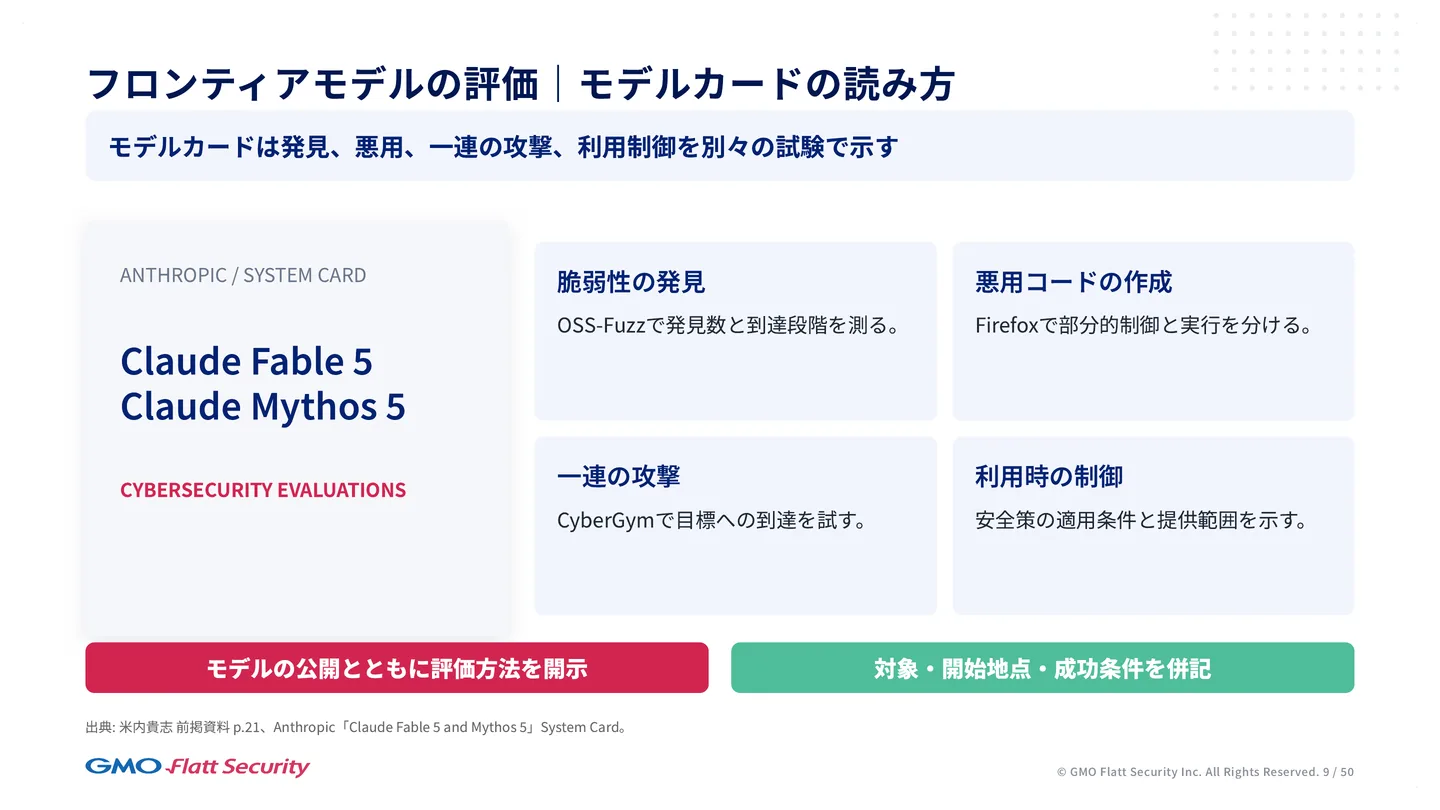
Anthropic のシステムカード(モデルの能力や安全性の評価を公開する文書)では、ブラウザの既知の脆弱性をどこまで悪用できるかを測っています。Claude Opus 4.8 ほどの水準のモデルから Claude Mythos まで、最先端のモデルになるほど、脆弱性を悪用につなげる力が大きく伸びています。Anthropic や OpenAI が出す、こうした最先端のモデルは、フロンティアモデルとも呼ばれます。以前は「バグがあるのは分かるが、悪用まではできない」ことが多かったのが、今のモデルではできるようになっています。
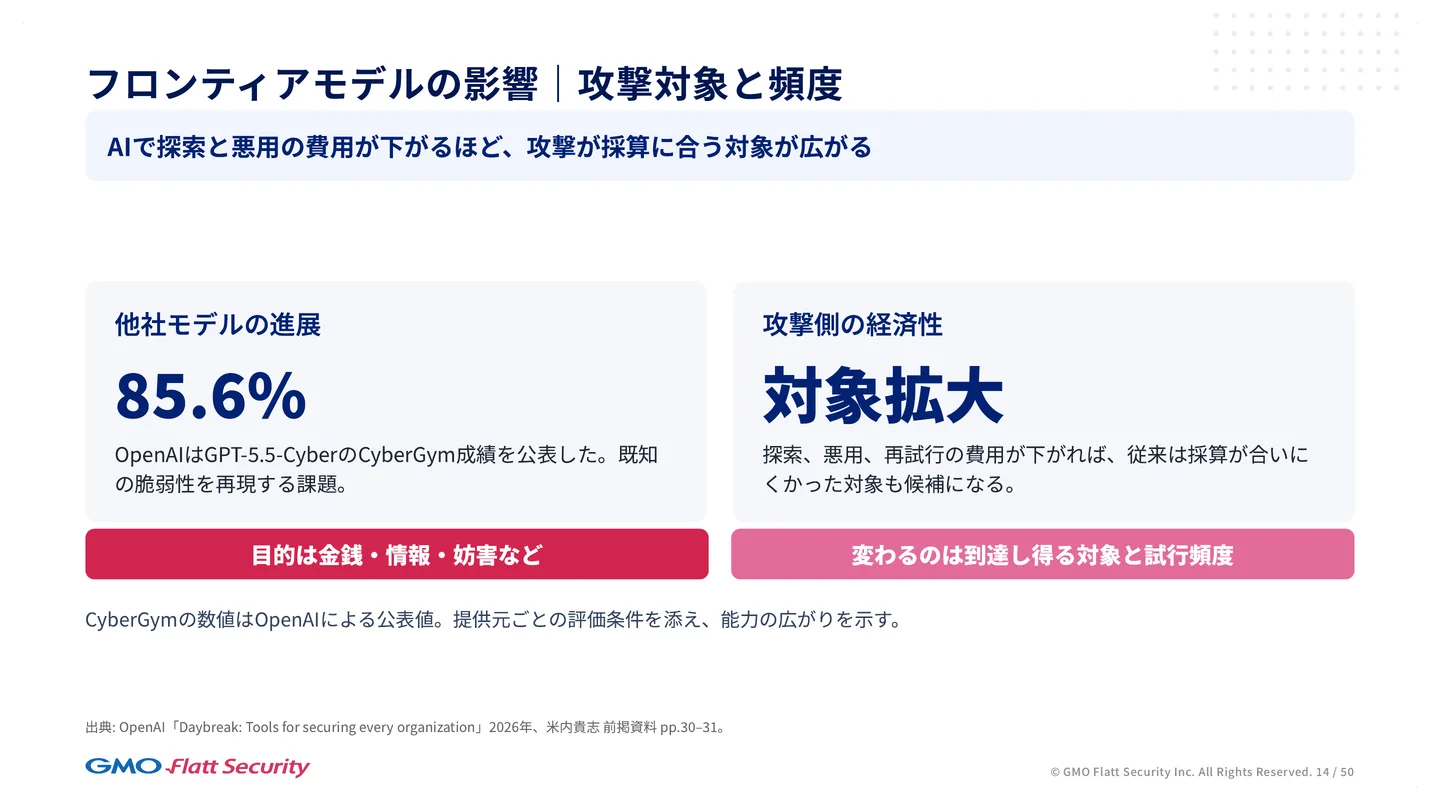
さらに、OpenAI が GPT-6 Astra を公開したときには、悪用の能力を測るベンチマーク ExploitBench で満点の100%に達し、問題が学習データに含まれていたおそれもあるため、別のベンチマークを作った、と公表しています。発見と悪用の両方で、AI は脆弱性診断やペネトレーションテストに十分使える状態になっています。
オープンウェイトモデルもフロンティアモデルに追いついている
オープンウェイトモデルとは、学習した後の成果物であるモデルの重みのデータが公開されていて、手元の GPU で動かせるモデルのことです。DeepSeek・GLM・Qwen などがよく知られています。こうしたモデルは、米国のフロンティアモデルから2〜3か月ほど遅れて、その能力に追いついていくと言われています。
オープンウェイトモデルはセーフガードの制約を外して動かせる
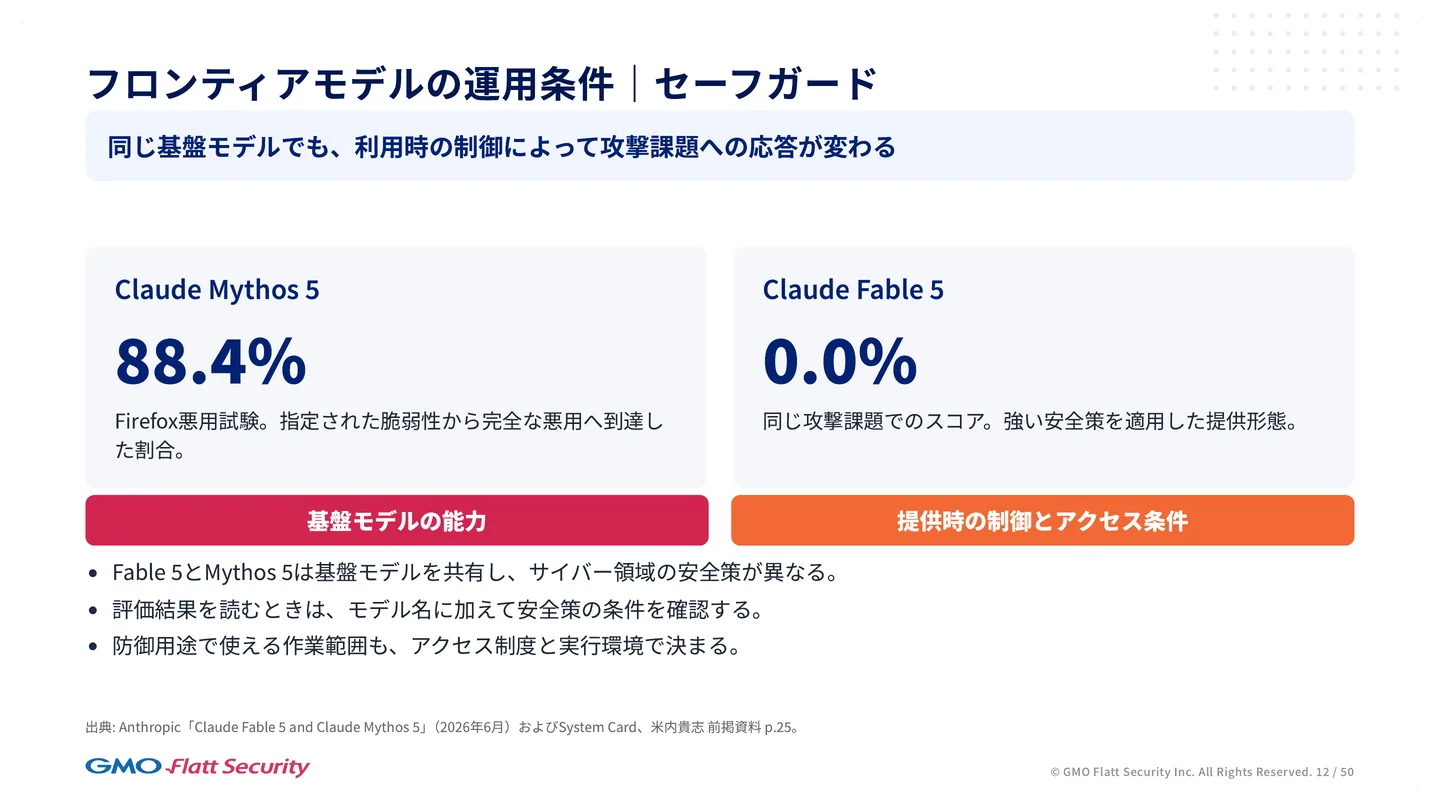
Anthropic や OpenAI のモデルには、セーフガードが設けられています。セーフガードは、サイバー攻撃につながる使い方を、安全のために止める仕組みです。システムの側とモデルの側の2つの仕組みで止めるので、セキュリティのテストや診断、ペネトレーションテストに使おうとすると、違法な活動ではないかと判断されて止められることが多くあります。弊社のようなセキュリティの事業者は、Daybreak や CVP のような枠組みを通して身元を示し、必要なセキュリティ対策をしたうえでモデルを使っています。こうした取り組みがあるので、フロンティアモデルは比較的悪用しにくくなっています。
一方、オープンウェイトモデルは、手元に落とし、モデルを動かすための計算機などの推論資源さえ用意すれば、その推論の中身を誰かに見られることはありません。モデルの調整によって悪用の依頼を断るようになっていても、「無検閲」と呼ばれる手法などで調整し直せます。そのため、このままの速さで追いつくなら、フロンティアモデルでできる最大の悪事が、2〜3か月後にはオープンウェイトモデルでもできてしまいます。それくらいのつもりで備える必要があります。AI が止めようのない形で攻撃に悪用される時期を見通すうえでも、オープンウェイトモデルが今どこまで来ているかを知っておくことが重要です。
オープンウェイトモデルもベンチマークで8〜9割の脆弱性を見つける
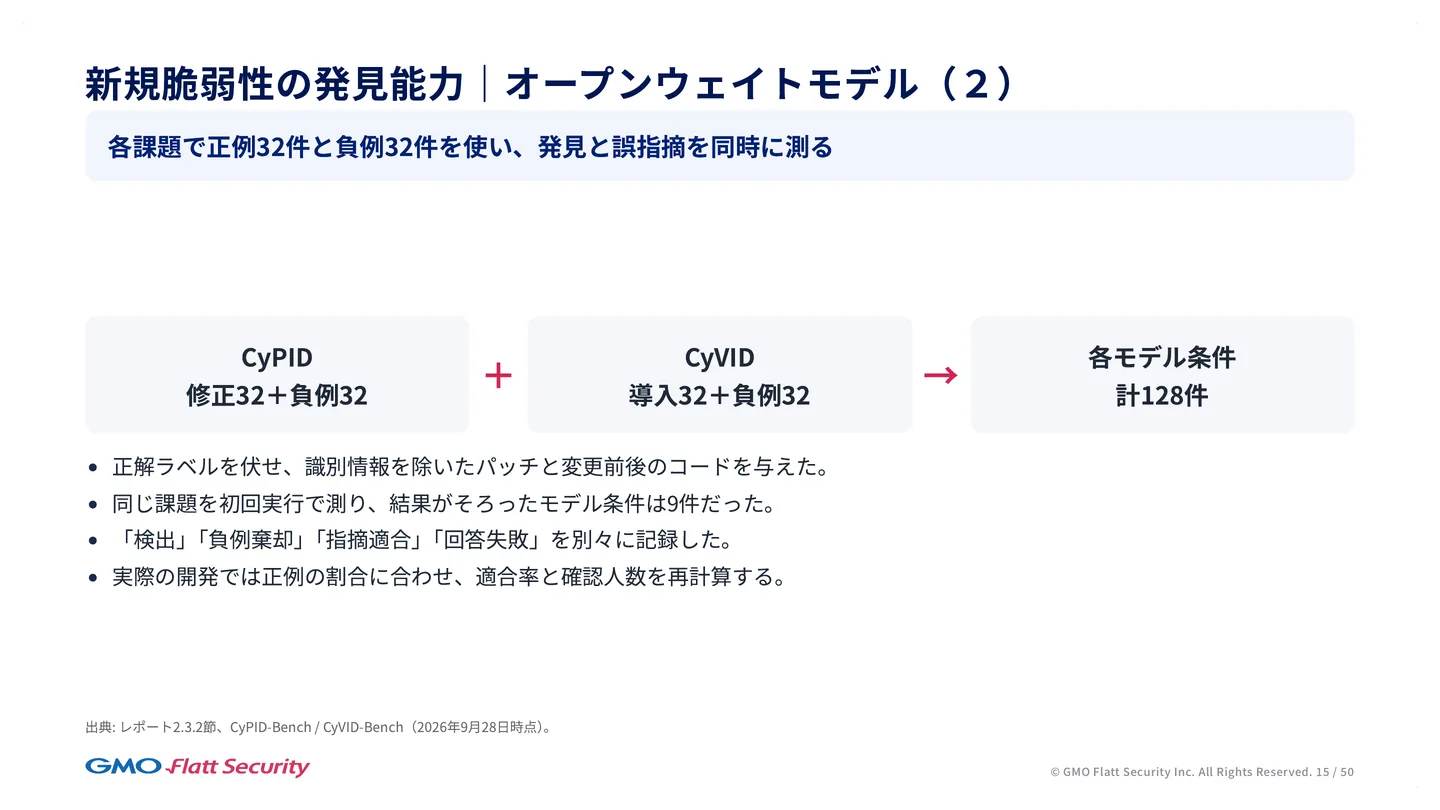
オープンウェイトモデルの能力を確かめるため、弊社は2つのベンチマークを作りました。どちらも弊社が名付けたものです。
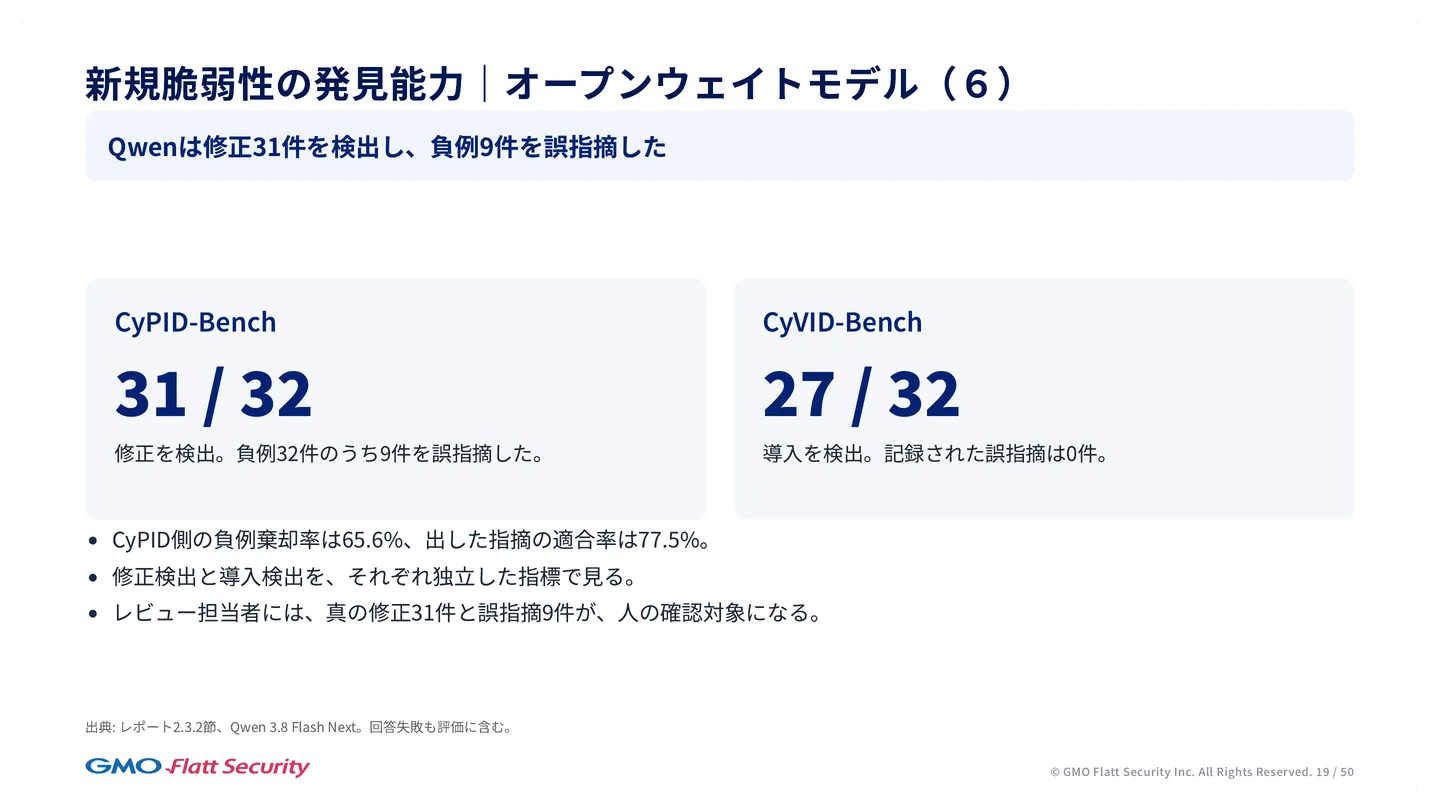
- CyPID-Bench: 与えられたパッチが、脆弱性の修正かどうかを判断できるかを測ります。WordPress のようなオープンソースの更新履歴(プルリクエストやコミット)を追い続け、その中に脆弱性の修正らしいものがあれば、それはまだ CVE の番号が付いていない新しい脆弱性かもしれません。パッチが脆弱性を修正しているかを判断することは、実質的に脆弱性のリサーチになります。
- CyVID-Bench: 新しく書かれたコードで、脆弱性が新しく生まれたかどうかを判断できるかを測ります。いわば脆弱性診断のベンチマークです。
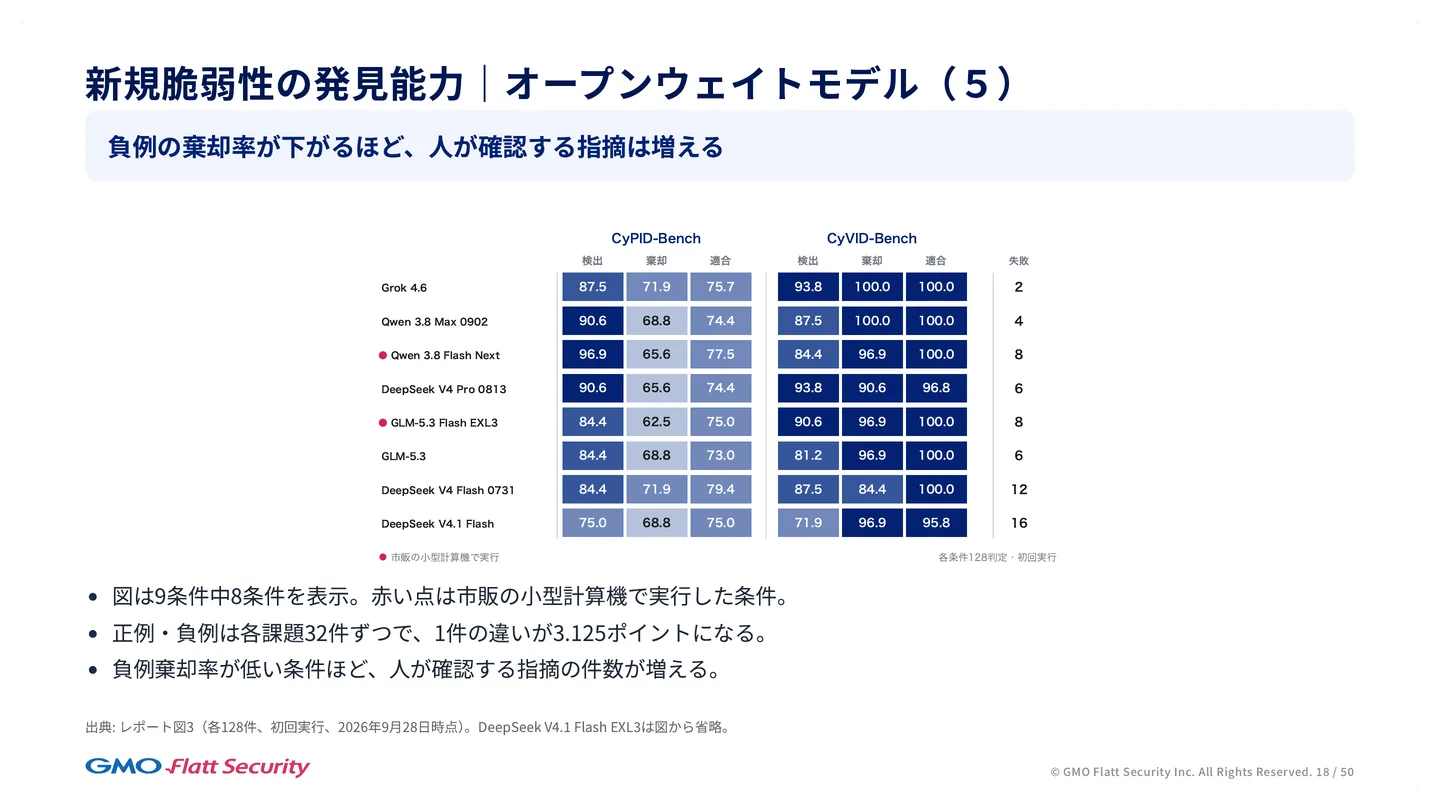
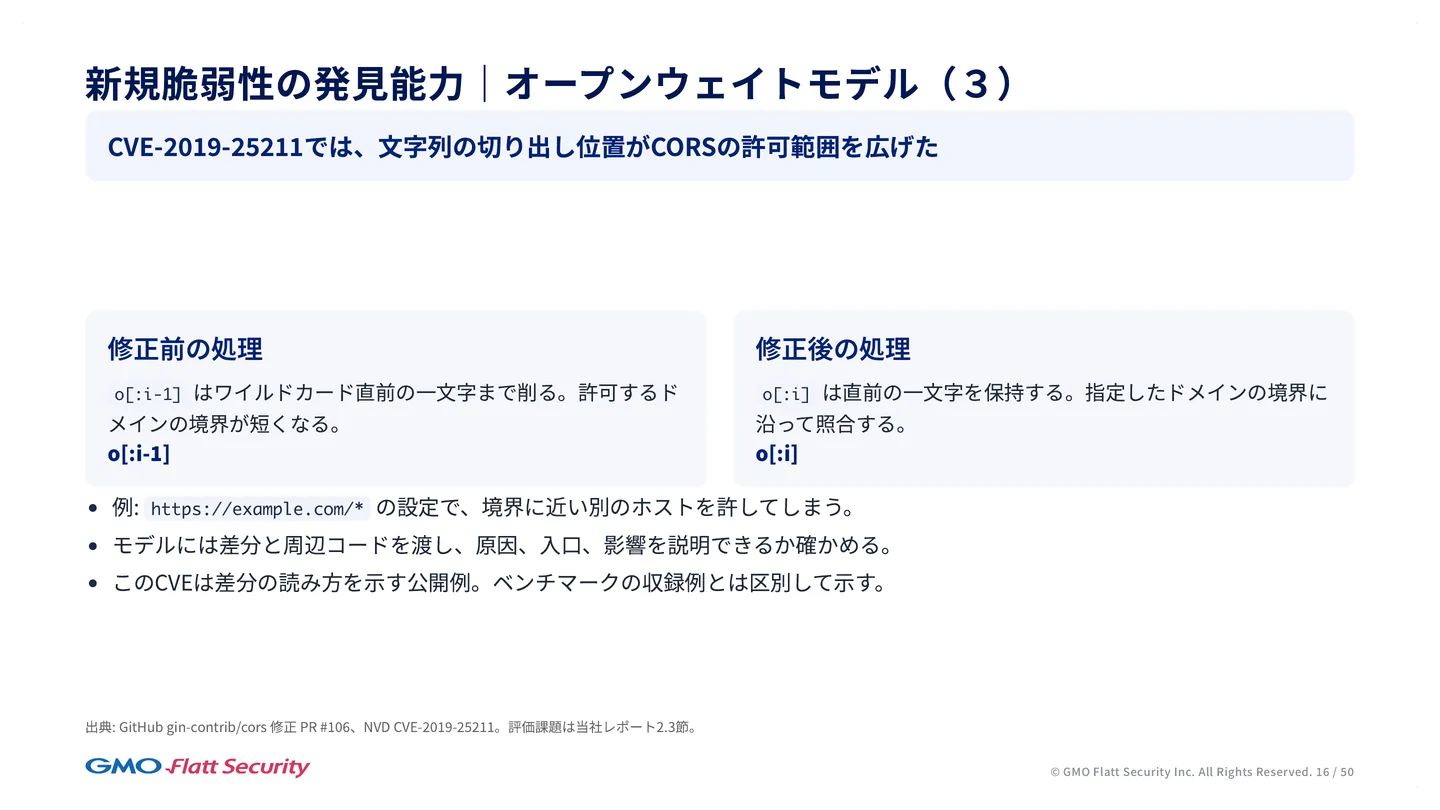
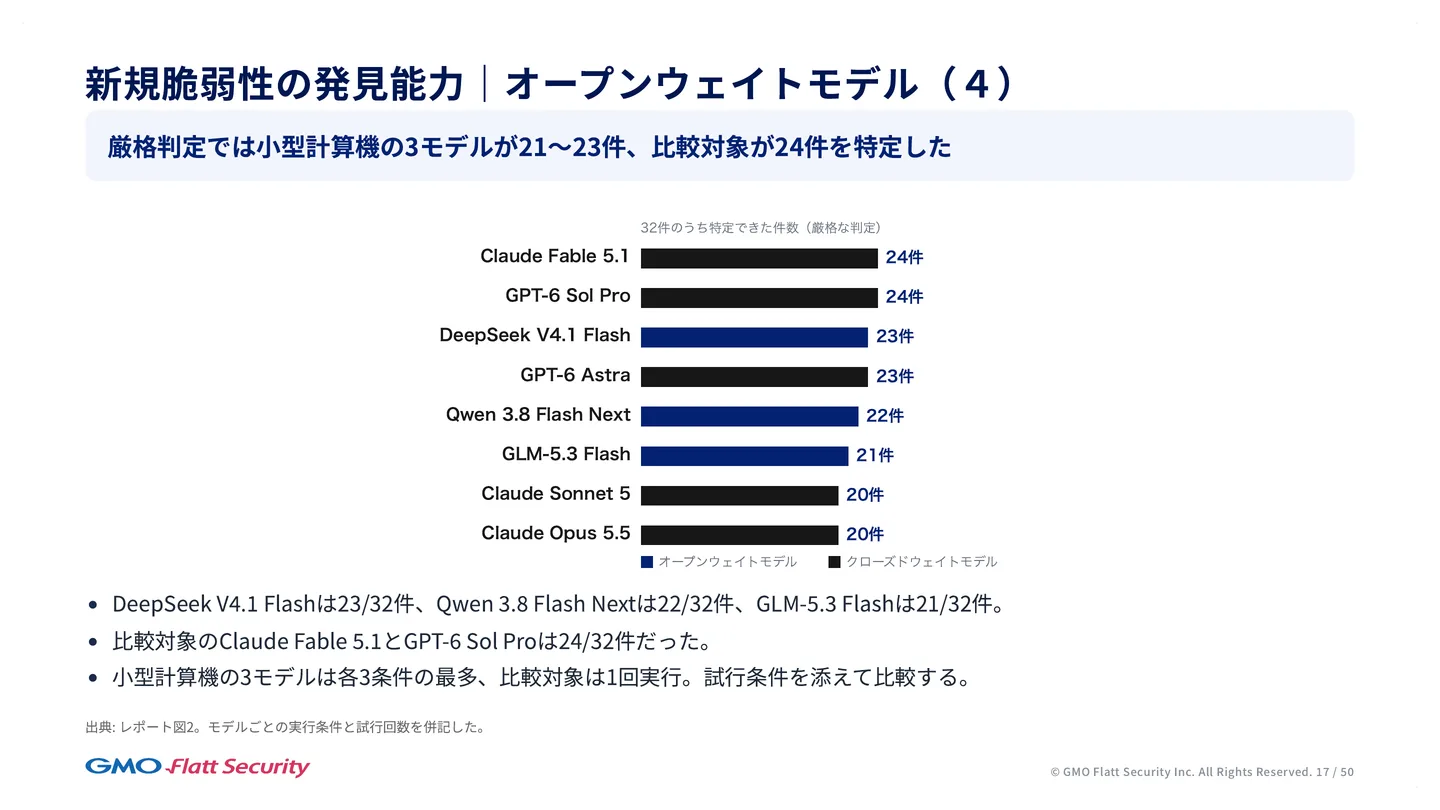
測ってみると、どちらのベンチマークでも、Qwen や GLM のモデルが高いスコアを出しました。パッチを与えて、脆弱性を修正しているか、脆弱性が入り込んでいるかを判断させると、8〜9割ほどはうまく見つけます。比較の対象として、オープンウェイトではない Grok も測りましたが、モデルの間の差は大きくありません。オープンウェイトモデルだからスコアが半分になる、ということはなく、肉薄する数字が出ています。
さらに、市販の小型の計算機を2〜3台、合わせて2〜3百万円ほどの機材をそろえ、重みの精度を落として軽くした版を動かしても、大きく見劣りしないスコアが出ます。オープンウェイトモデルでも、脆弱性の発見は少なくとも良い水準に来ていて、悪用も、ベンチマークを取り直している最中ですが、フロンティアモデルと大きな差はありません。複雑なものは悪用できないこともありますが、ある程度は悪用できる段階に入っています。
AI エージェントは侵入の目標までたどり着ける
システムの侵害には抽象的なゴールを達成する力が要る
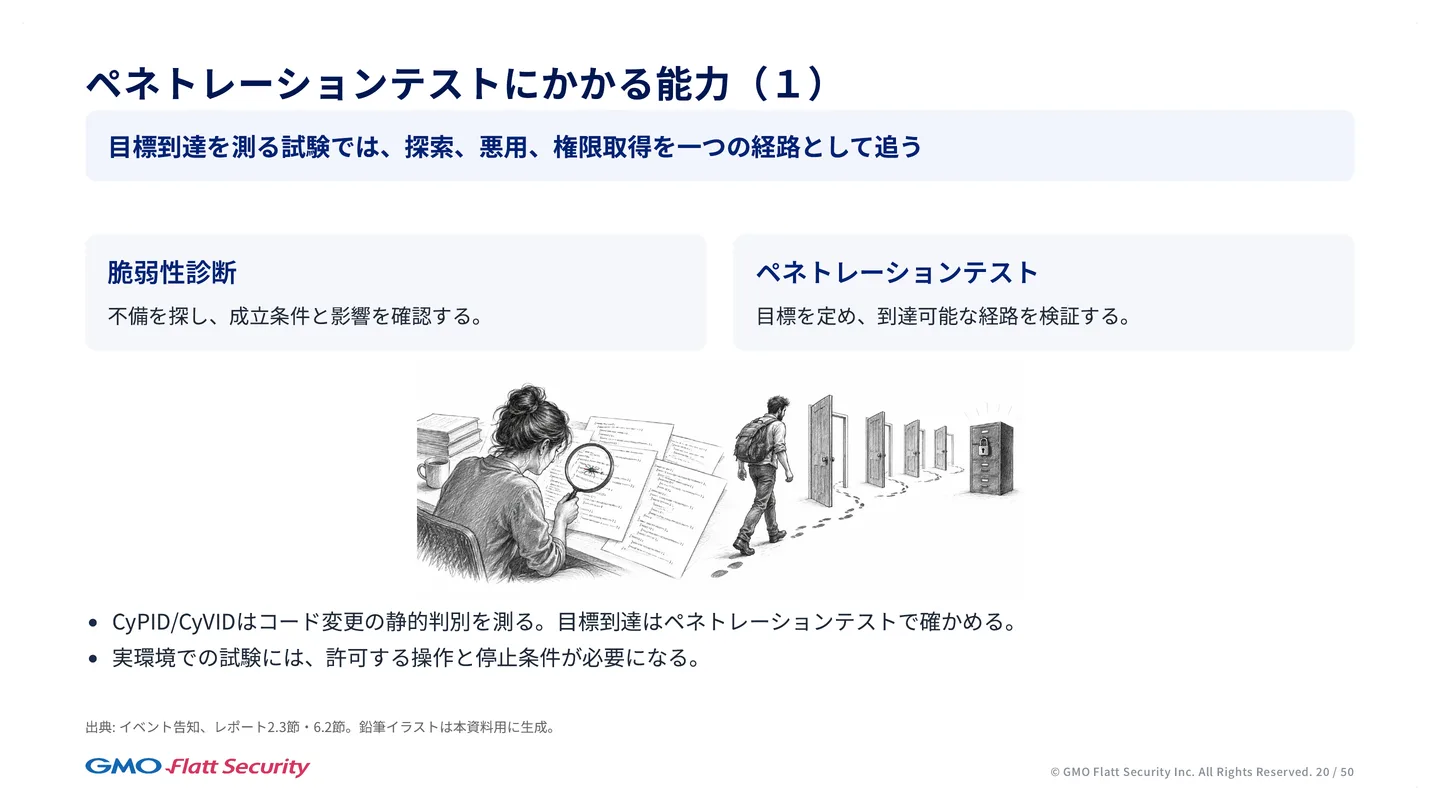
脆弱性を見つける、悪用するというのは、システムを侵害するうえでは一部分にすぎません。SQL インジェクションを見つけても、その先に大事な顧客のデータが無ければ、大きなリスクにはなりません。実際にシステムを侵害するには、脆弱性を見つけて悪用する能力から、もう一段上に進む必要があります。
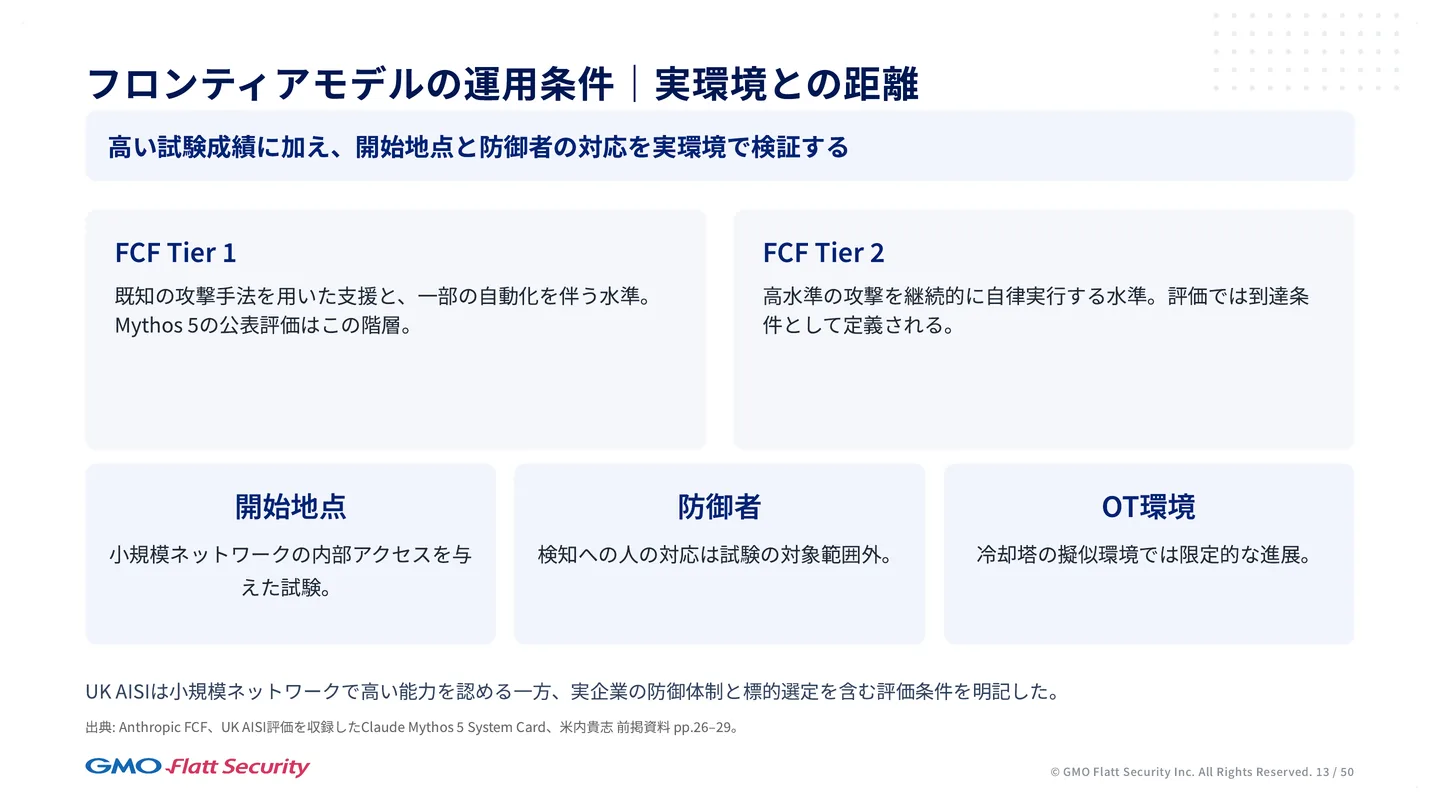
自社のシステムが守れているかを、AI でペネトレーションテストをして確かめる場合も同じです。「このシステム群から何かしらの個人情報を持ち出せ」のような、抽象度の高いゴールを渡したときに AI エージェントが動けるかどうかが問題になります。これが、ペネトレーションテストの能力です。
複雑なシステムでも十数分で目標を達成した
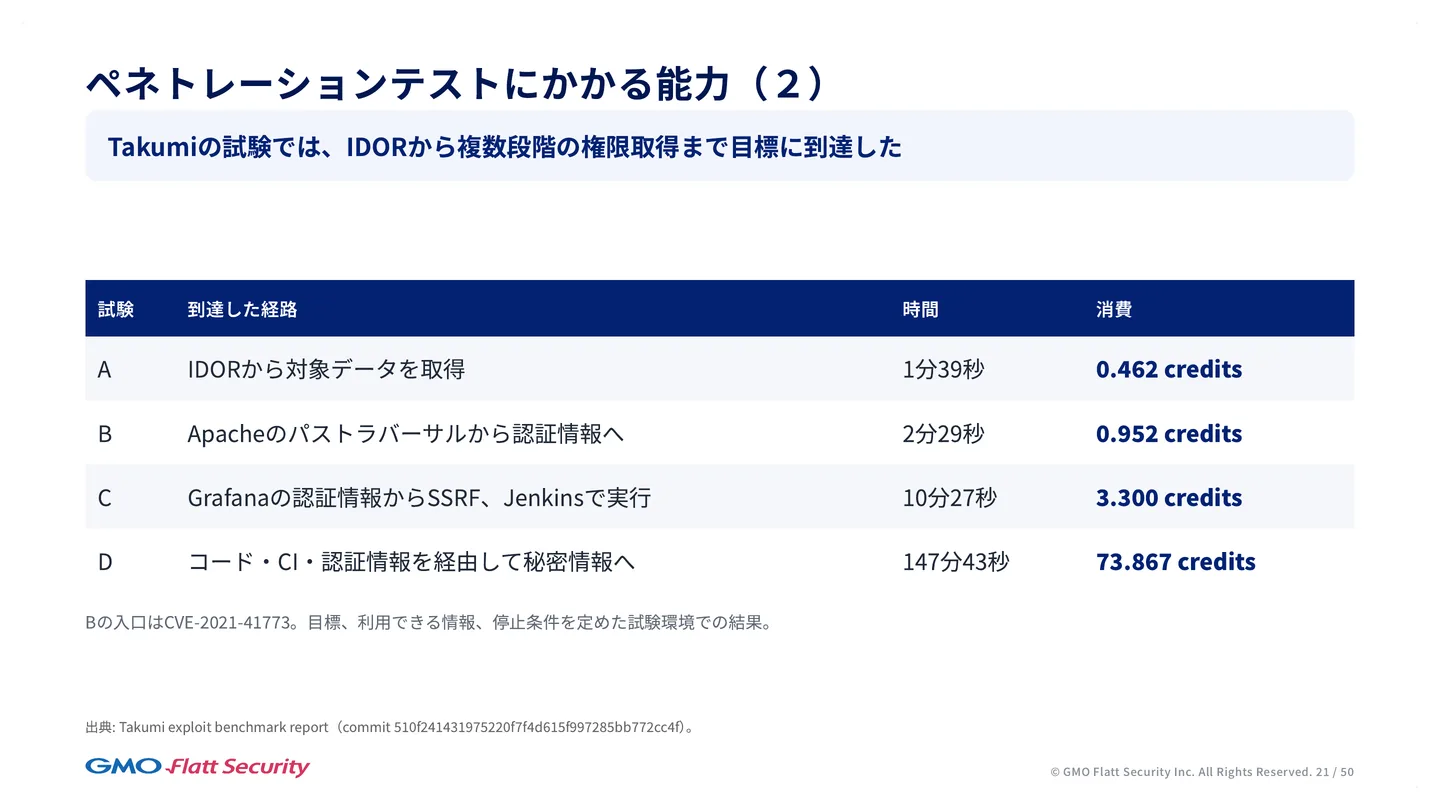
弊社は、AI エージェントでセキュリティ診断とペネトレーションテストを行う SaaS「Takumi byGMO」を提供していて、この能力を Takumi のハーネスで測りました。Takumi は、Anthropic と OpenAI の複数のモデルを組み合わせて使います。
最も単純な試験では、シンプルな Web アプリを1つ対象にして「データを持ち出せ」と指示しました。脆弱性が単純だったこともあり、数分、数百円ほどの費用で目標に到達しました。ゴールの抽象度を上げた試験では、CI/CD が動いていて、Grafana で監視していて、Web アプリもある、という古い開発環境のような広めの構成を渡し、価値のあるデータを盗むよう指示しました。あまり防御が入っていない構成だったこともあり、十数分、千円あまりの費用で目標に到達しました。
攻撃に使える脆弱性や手がかりがあれば、最も抽象度の高いゴールでも、AI エージェントは2〜3時間ほどで侵害しきれる段階に来ています。1つのシステムに閉じた話だけでなく、「弊社の開発環境は破られるのか」を確かめるような水準にも、AI エージェントの能力は十分に達しています。
実際の診断でも AI がロジックの脆弱性を見つけている
AI が3か月で593件の診断を行った
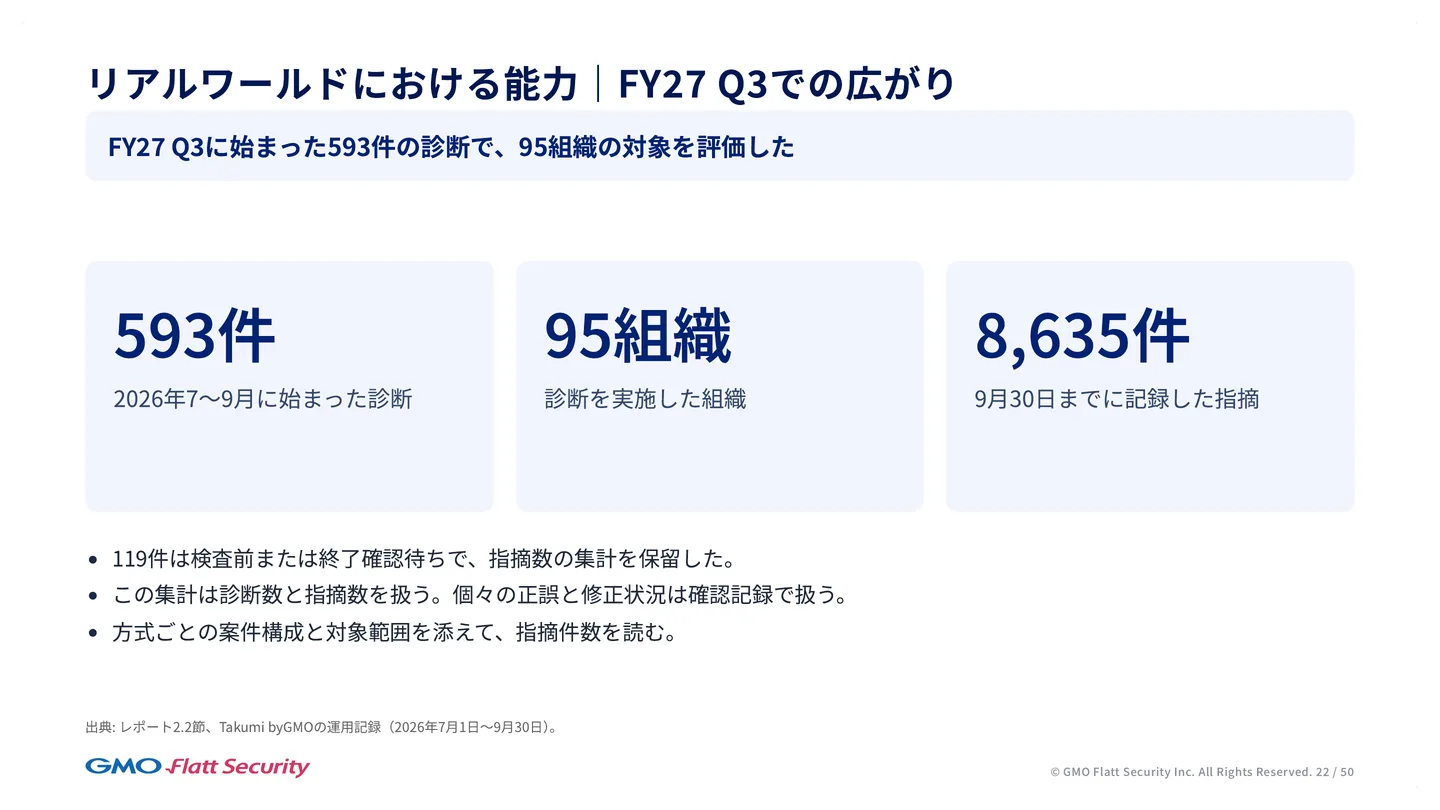
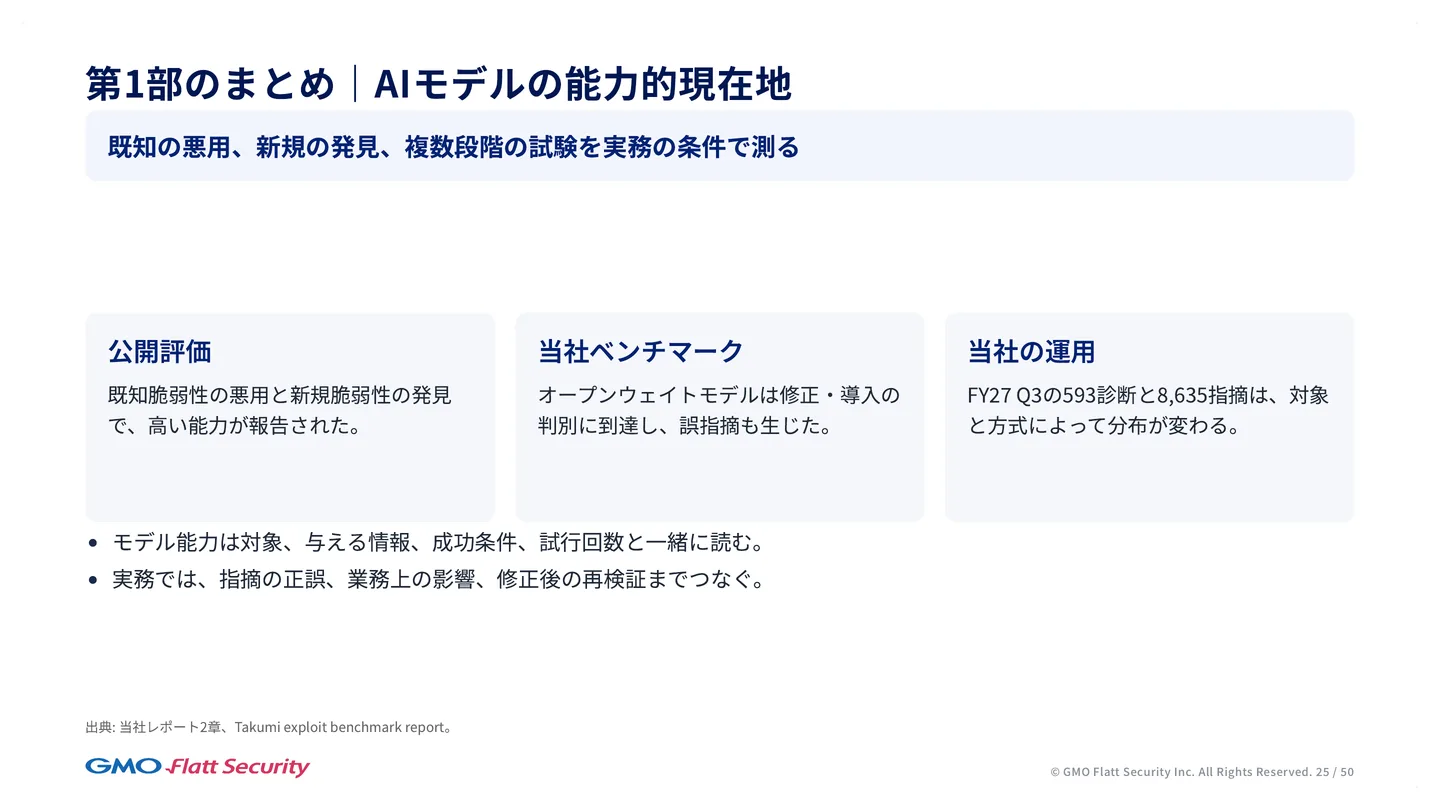
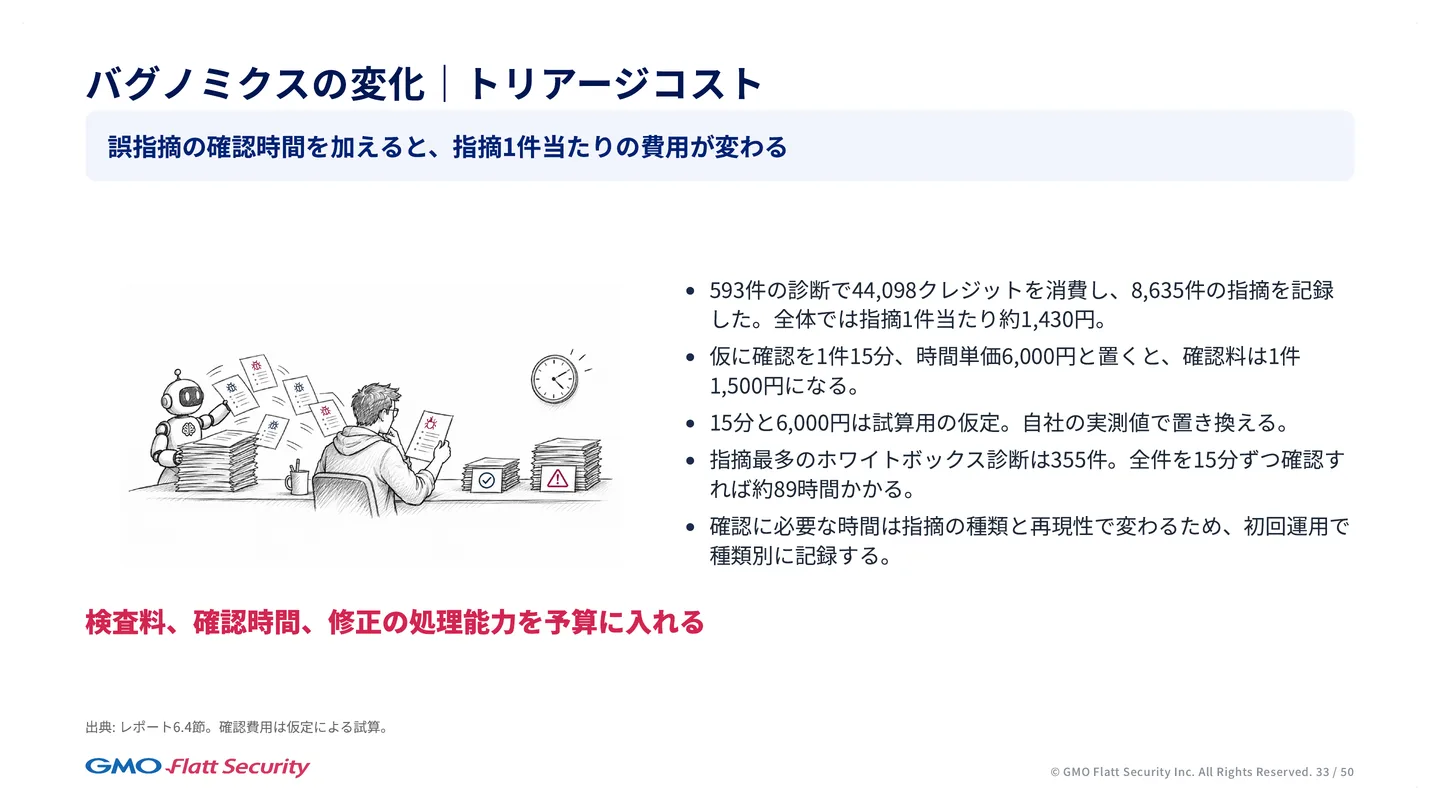
実際の診断のデータでも、AI の能力は確かめられます。弊社の Takumi byGMO では、2026年7〜9月の3か月に、AI による診断とペネトレーションテストを593件行いました。ここでいう診断1件は、プルリクエスト1つを見るような小さなものではなく、アプリケーション全体を外部のベンダーに診断してもらうのと同じ規模のものです。
脆弱性診断は1件で2〜3百万円ほどかかります。それを3か月で600件ほど行うには、大きな組織が要ります。それが今は、SaaS の形で、AI によって人の手を介さずに行われています。さらに、この593件の診断からは、8,635件の脆弱性を報告しました。この規模のシステムを AI で診断すると、1件あたり少なくとも10件から十数件の脆弱性が見つかる状態だと考えられます。
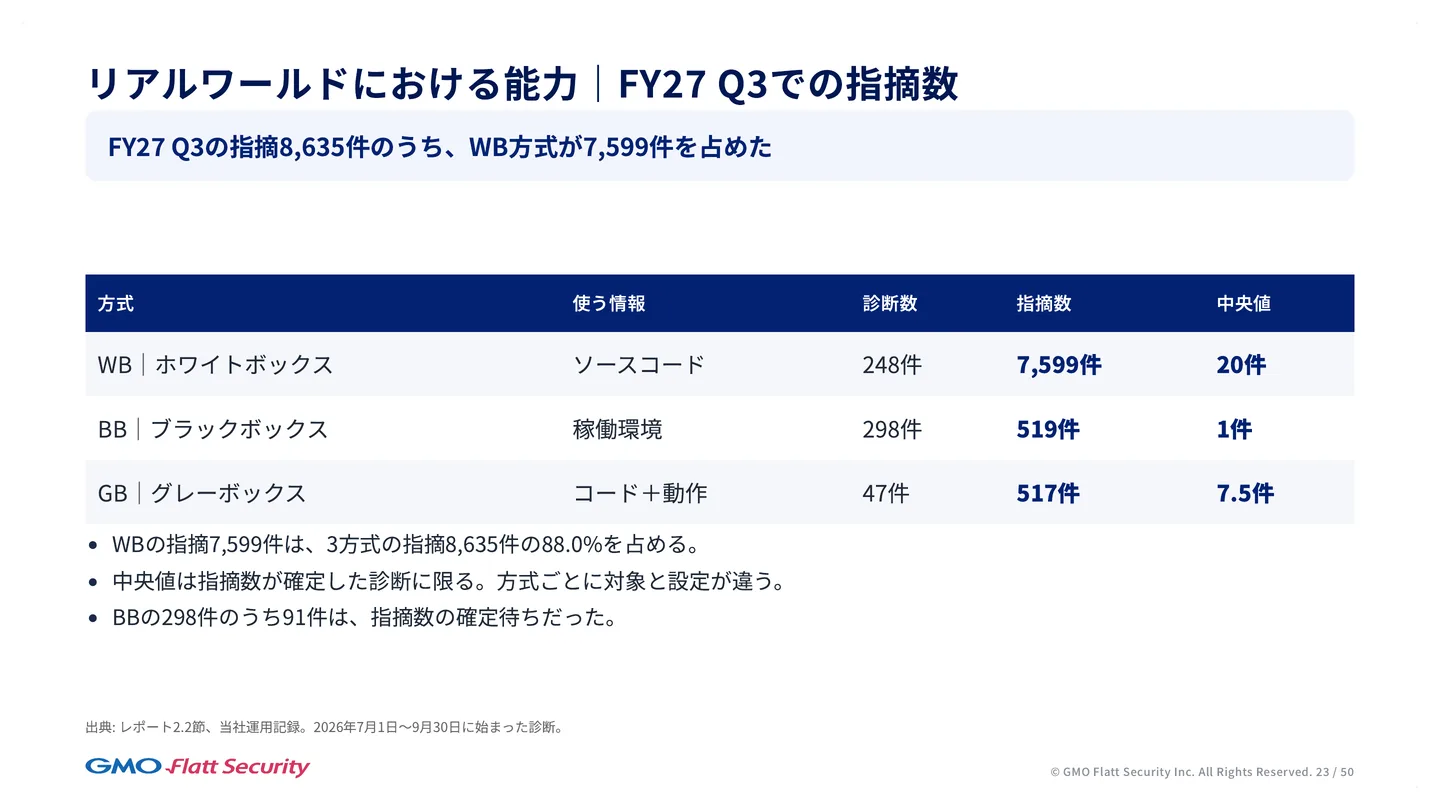
診断のやり方別に見ると、最も多くの脆弱性を報告しているのは、ソースコードを読むホワイトボックス診断です。グレーボックス診断の提供を8月ごろに始めたばかりであるため、データには偏りがあります。それでも、診断1件あたりの報告数で見ても、ホワイトボックス診断が最も多くなっています。認可制御の不備などはコードのロジックを読んだほうが細かく確かめやすく、外から到達できないエンドポイントやコードの経路の脆弱性は、ブラックボックス診断では報告しようがないためです。
ブラックボックス診断で見つかった脆弱性も6割がロジックと認可の不備
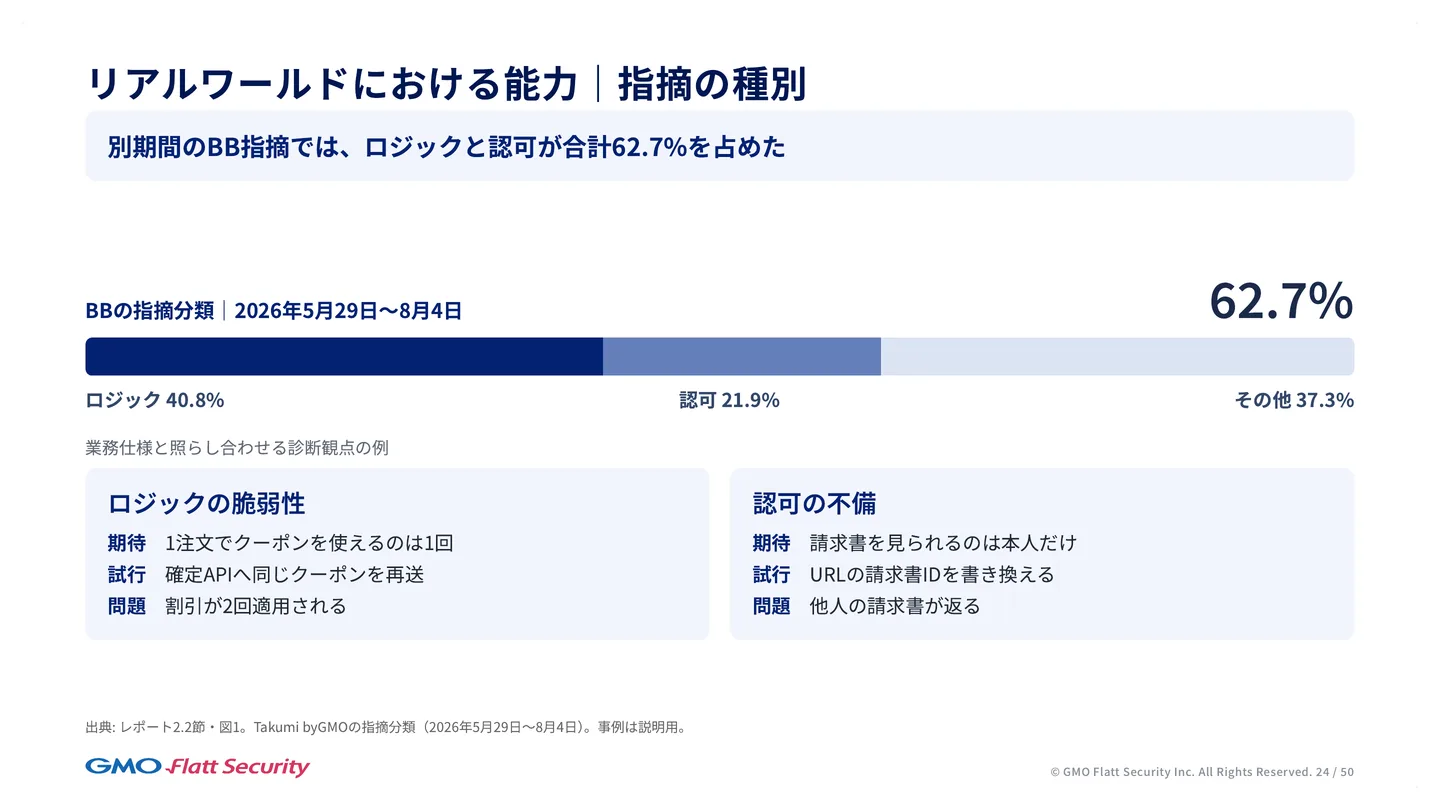
攻撃者に近く、脆弱性を探すには最も不利な条件であるブラックボックス診断で見つけた脆弱性(2026年5月29日〜8月4日)の内訳を見ると、4割はロジックの脆弱性です。ロジックの脆弱性とは、業務の仕組み(ビジネスロジック)を悪用できてしまう脆弱性のことです。たとえば EC サイトで、クーポンを不正に使えてしまう、特定のエンドポイントに外から通信を送ると、お金を払っていないのに購入が完了したことになる、といったものです。
ロジックの脆弱性に続いて2割を占めるのが、認可制御の不備です。たとえば、管理者としてログインすると、本来は見えてはいけない別のテナントの情報まで見えてしまう、といったものです。合わせて6割ほどが、従来のスキャナーでは見つけにくく、しかも「これがあったら本当に深刻だ」と言える脆弱性です。
従来の診断ツールや、ソースコードを静的に調べる SAST、動いているアプリケーションを擬似的に攻撃する DAST といった AI を使わないツールでは、セキュリティのヘッダーが付いていないことなど、実際の被害にどうつながるのかが分かりにくいものが多く見つかっていました。AI エージェントで診断すると、ロジックの脆弱性が数多く見つかります。ツールによる診断や、ロジックの脆弱性まで見ない手動の診断では洗い出されてこなかった、しかも深刻な種類の脆弱性を、AI が見つけられる段階に来ています。研究のためのデータセットで測った数字だけの話ではなく、実際の脆弱性探しでも、AI はそのまま力を発揮しています。
脆弱性を探す費用と利益の関係が変わった
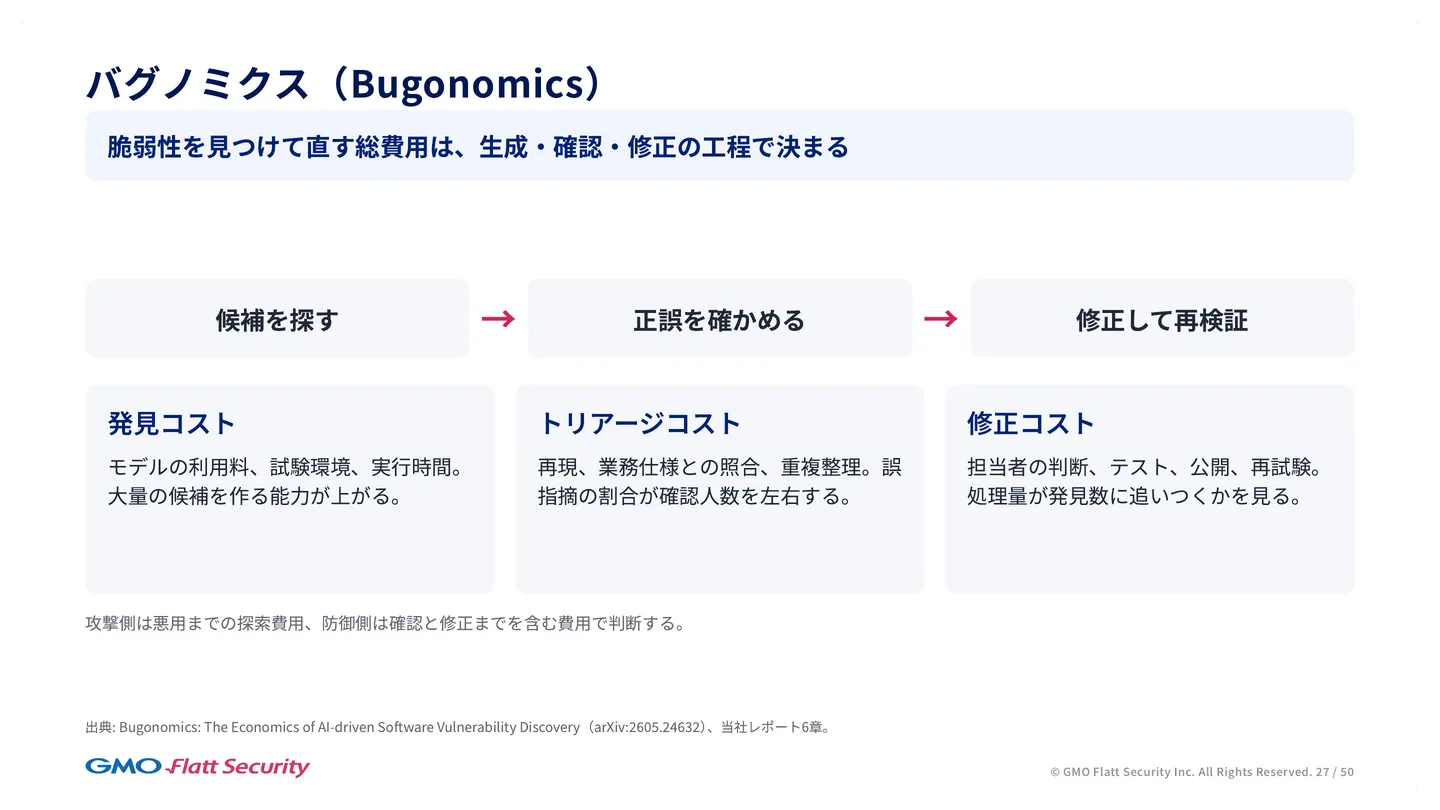
AI の能力が高まっても、守る側にも攻撃者にも便利な道具が増えただけで、攻撃者にとっては今もフィッシングメールを送るほうが得だ、という見方もありえます。しかし、AI がもたらした変化で最も大きいのは、脆弱性を探す費用が変わったことだと考えられます。その影響は、「バグノミクス」という考え方で捉えられます。
1件あたりの経済性(ユニットエコノミクス)は、多くの場面で使われる考え方です。100円の物を売るのに700円かけて客を集めていれば大赤字ですが、100万円のサービスを売るのに1社10万円で客を集められれば、差額の90万円から原価を引いても利益が残ります。どれだけの費用で、どれだけの利益が出るかは、お金を得たい人にとって重要です。
これを、脆弱性を探すことや悪用することに当てはめた言葉がバグノミクスです。ここでは、脆弱性を見つける費用に対する、脆弱性から得られる利益の大きさを指します。
- 費用: AI モデルを使うなら、API の利用料です。手元で動かすなら、電気代や推論の費用、推論に使う機材の償却費などです。
- 利益: 犯罪であれば、その犯罪で得られる利益です。バグバウンティ(脆弱性を報告すると報奨金がもらえる制度)であれば、脆弱性1件あたりの報奨金の額です。
脆弱性を探す費用は、大きく下がりました。利益は、犯罪者にとっては上がり、純粋に脆弱性を探しているリサーチャーにとっては下がっています。守る側にとっては、最も悪い組み合わせです。
AI で1つの製品を調べ続けても1か月に5〜6万円で足りる
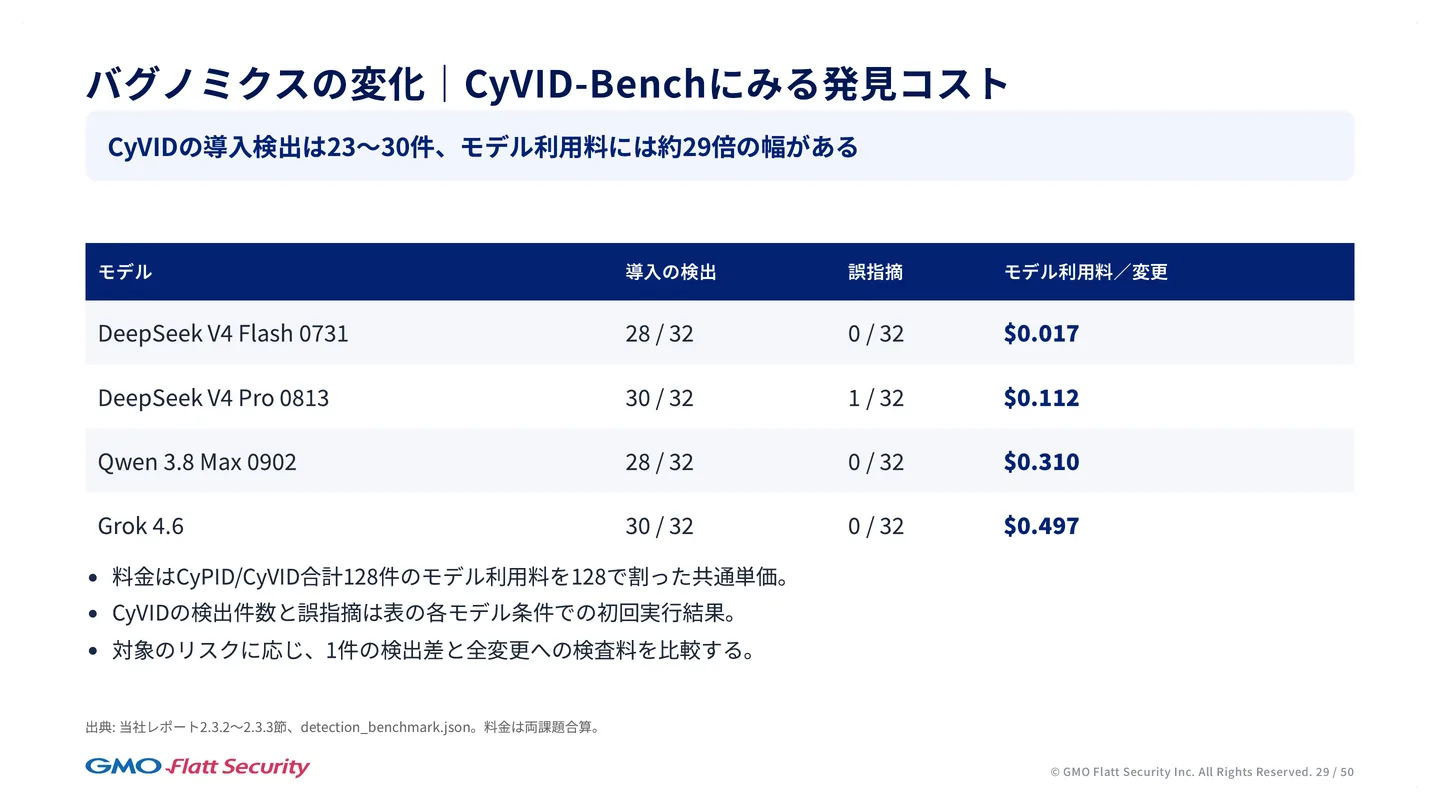
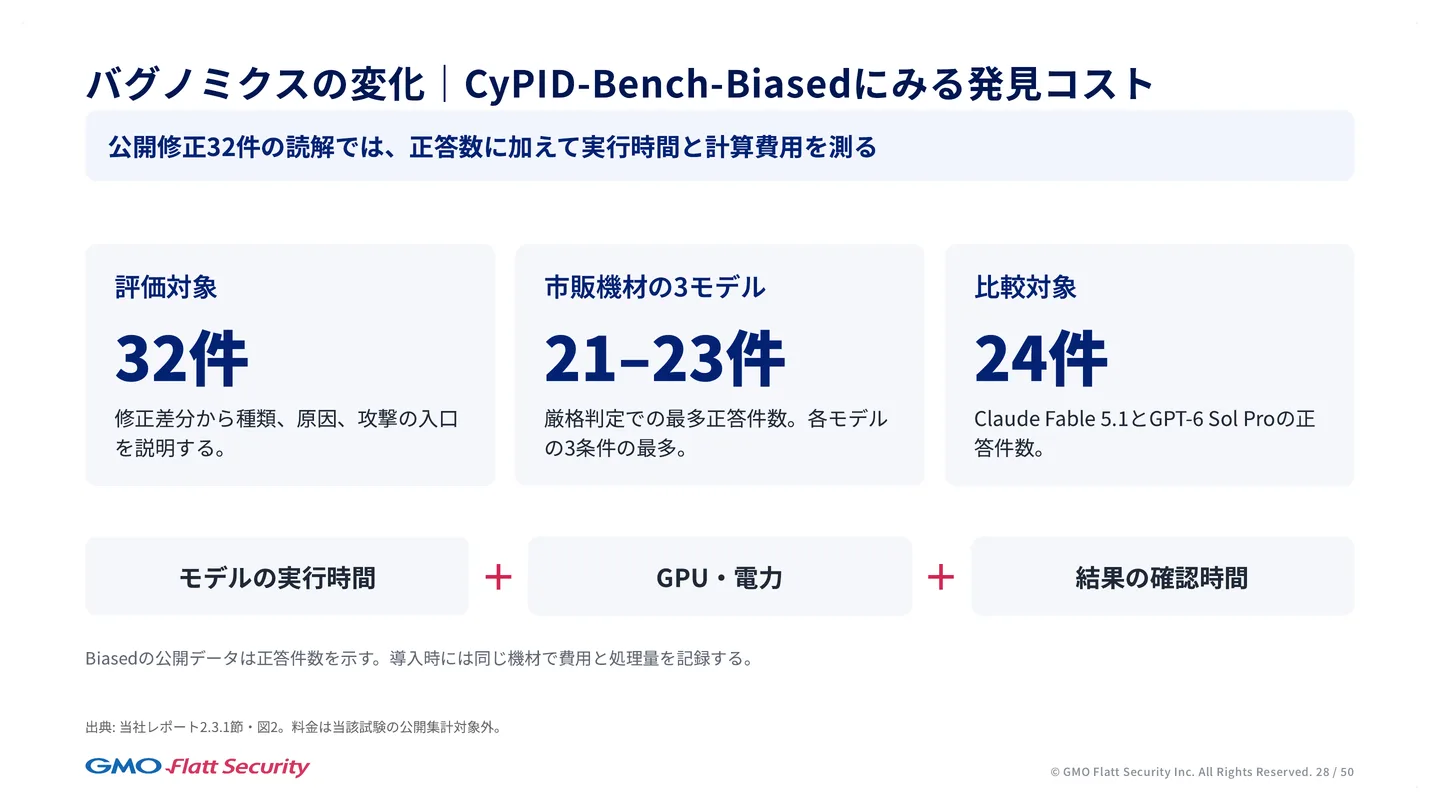
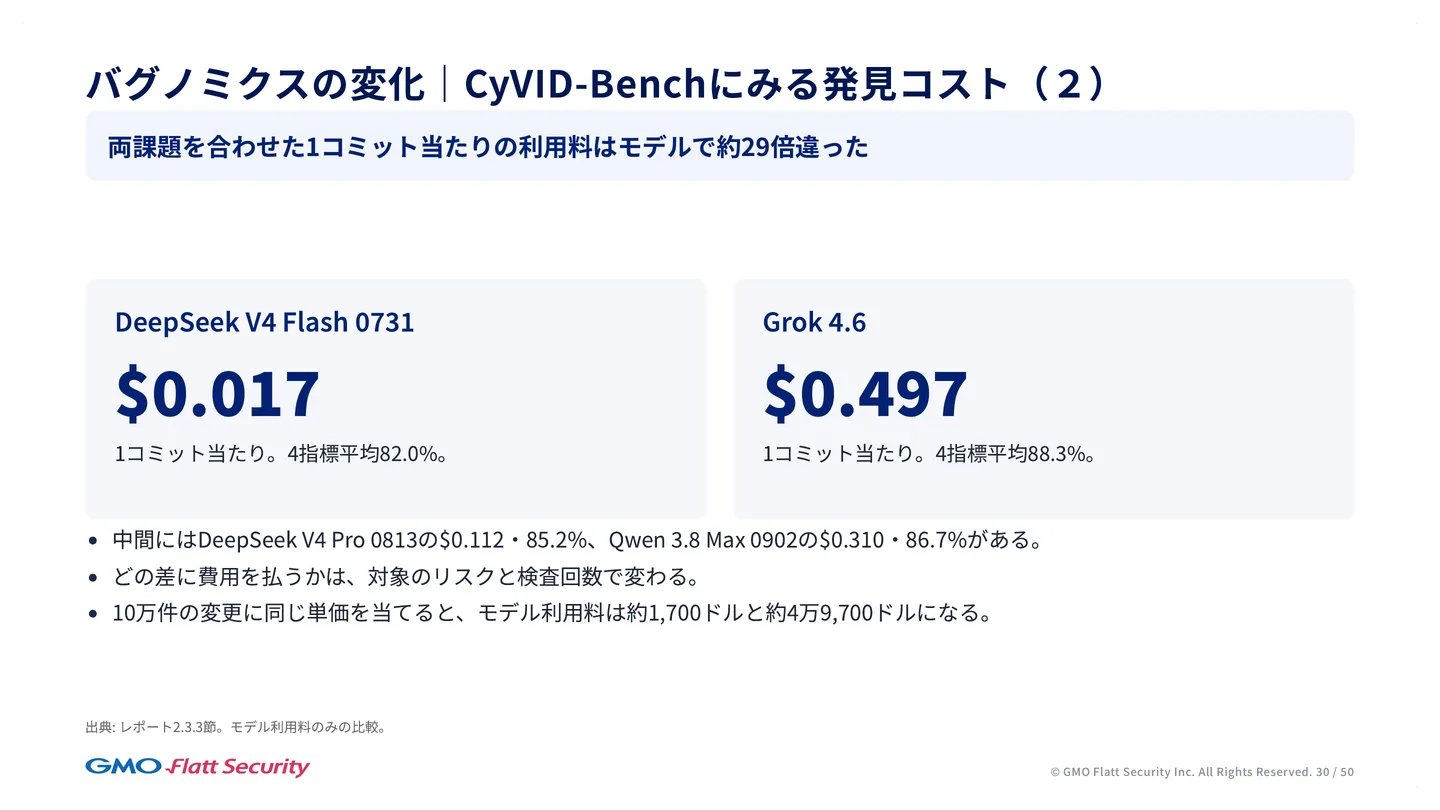
CyVID-Bench で、1つのコミットを見て脆弱性が入り込んだかを判断させると、オープンウェイトモデルでは、1コミットあたりの費用は1ドルを切り、数十円ほどです。数多くのコミットの中に、脆弱性の入り込んだコミットが32件含まれているとすると、Qwen や DeepSeek の安いモデルでも28〜30件と、ほとんどを見つけられます。脆弱性ではないものを脆弱性だと指摘することも、ほぼありませんでした。Anthropic や OpenAI のモデルに切り替えると、1コミットあたり100〜300円ほどになると考えられます。
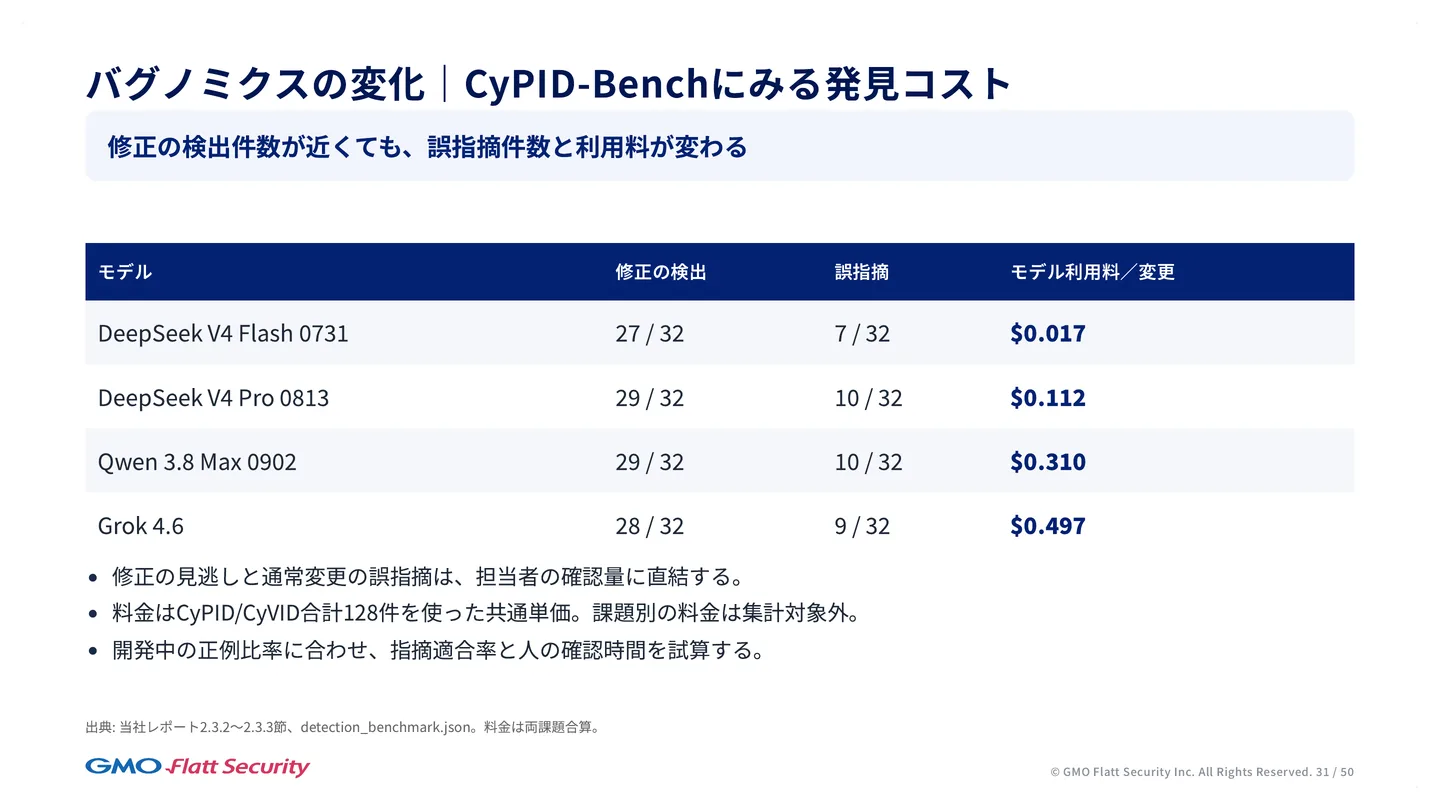
CyPID-Bench のように、修正のコミットかどうかを判断させるやり方でも、費用はほとんど変わりません。誤った指摘が少し増えるので、その分の費用は増えますが、どちらのやり方でも、1つのコミットを調べる費用は数十円ほどで済みます。
CyVID-Bench のやり方では誤った指摘がほとんど無いので、確かめる手間を含めても、脆弱性を探す費用はほぼこの額のままです。オープンソースのソフトウェアでは、1日に積まれるコミットが十数件ほどのものが多いので、1日に数百円もかからず、1か月見張り続けても1万円前後です。
脆弱性らしいものを見つけた後、悪用できるかを確かめる攻撃コードを作らせる費用も、おおむね脆弱性1件あたり数百円ほどと見ています。仮に、1か月に30〜40件ほどの脆弱性の候補が見つかり、そのうち30件を1件あたり1,000円で悪用できるかを評価させると、追加で3万円ほどです。確かめる手間と攻撃コードの作成まで含めても、1つの製品に張り付いて攻撃できるかを調べ続けるには、1か月に5〜6万円もあれば十分と考えられます。
ソースコードがあれば AI は脆弱性1件を800円ほどで見つけられる
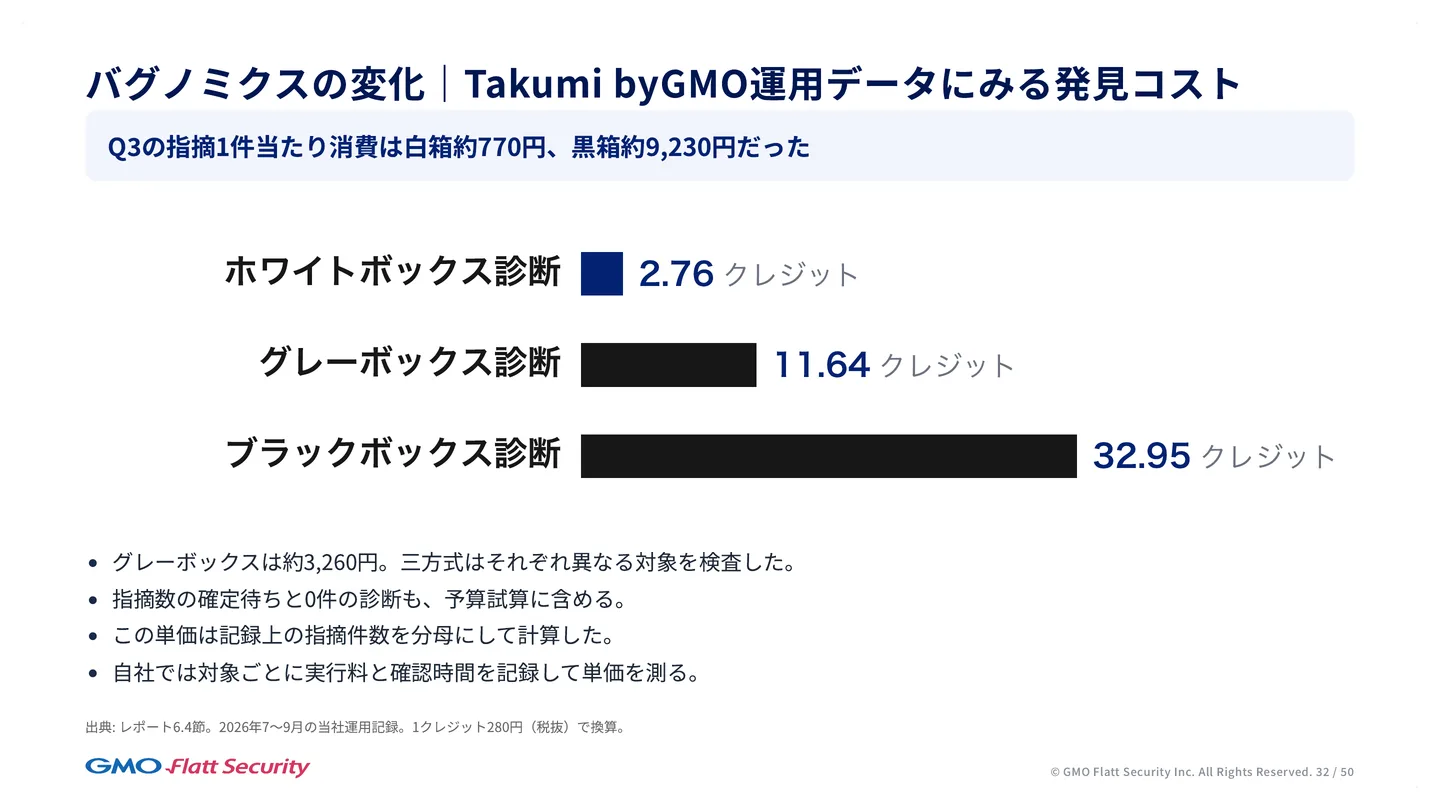
弊社の運用データでも、2026年7〜9月に報告した8,635件の脆弱性を見つけるのにかかった費用を計算しました。ソースコードを読むホワイトボックス診断で見つかる脆弱性も、4〜5割ほどがロジックの脆弱性で、認可の不備を含めると6割ほどが、従来のスキャナーでは見つけにくかった脆弱性です。それを見つけるのにかかった費用は、脆弱性1件あたり2.76クレジットでした。クレジットは Takumi の診断の課金の単位で、AI が使った量におおむね比例して消費されます。1クレジットは税抜で280円なので、600〜800円ほどです。ソースコードがあれば、こうした脆弱性を1件、800円ほど、多くても1,000円ほどで見つけられるのが現状です。
攻撃者と同じく外から調べるブラックボックス診断では、費用は十数倍ほどに上がります。それでも、1つのシステムに2〜3万円ほどをかけて AI に探させ続ければ、悪用につながる脆弱性が拾えます。その脆弱性を使った攻撃で2〜3万円以上を得られれば、攻撃者は損をしません。1つのアプリを2〜3万円で攻撃できるなら、多くの会社に同じことを繰り返し、その中から高くデータを売れそうな会社や大きな事件になりそうな会社を狙う、手当たり次第の攻撃も成り立ちそうです。
脆弱性を探す費用は人手の頃より1〜2桁下がった
人が手でセキュリティのテストや攻撃をしていた頃は、脆弱性を探す費用が、今より1〜2桁大きいものでした。年収1,000万〜1,200万円ほどが妥当なセキュリティエンジニアを雇うと、1か月に100万円ほどかかり、その分がそのまま脆弱性を探す費用になります。今は、この費用の桁が1つか2つ下がっています。
DeepSeek を含むオープンウェイトモデルの台頭もあり、フロンティアモデルも値下げを続けていて、トークンあたりの費用は下がり続けています。世の中の脆弱性の総数が大きく変わらない限り、脆弱性を探す費用は、しばらくこの調子で下がっていきます。ここからさらに1桁下がるとは考えにくいものの、2分の1から3分の1ほどにはなると考えられます。
脆弱性の調査費用が下がり、善意のリサーチャーより攻撃者が得をする
脆弱性を報告すると報奨金がもらえるバグバウンティや、重要な製品の脆弱性を悪用できることを実演すると数百万円の報奨金がもらえる Pwn2Own のようなコンテストがあります。しかし今は、善意のリサーチャーが脆弱性を探して得られる利益は、ほとんど無くなってきています。こうしたコンテストは運営が難しくなりつつあり、バグバウンティの報奨金も小さくなっています。弊社のような診断の事業者も、「AI でできるのではないか」と言われ、価格を下げる圧力を受けています。
一方、攻撃者から見ると、費用がとても小さくなったので、少しの利益でも稼げるなら、今は犯罪を繰り返すほうがおそらく得です。脆弱性を探すことが善意として世の中に良い影響を与える、という形ではなく、犯罪に流れたほうが得な経済の状況になってきているのは、社会全体にとって良くないことです。最近のさまざまな事件にもつながっているのではないかと考えています。
攻撃者は、国が背後にいるならその国の目的を持ち、そうでなくても多くはお金や名声を求めています。それを得るのにかかる費用が変わることは、とても重要です。脆弱性1件あたりや、セキュリティのテスト・診断1件あたりの費用には、今後も注目しておくことをおすすめします。
守る側は AI による評価から脆弱性の修正までつなげる
AI を使う攻撃者に時間をかけて対処できる段階はすでに過ぎた
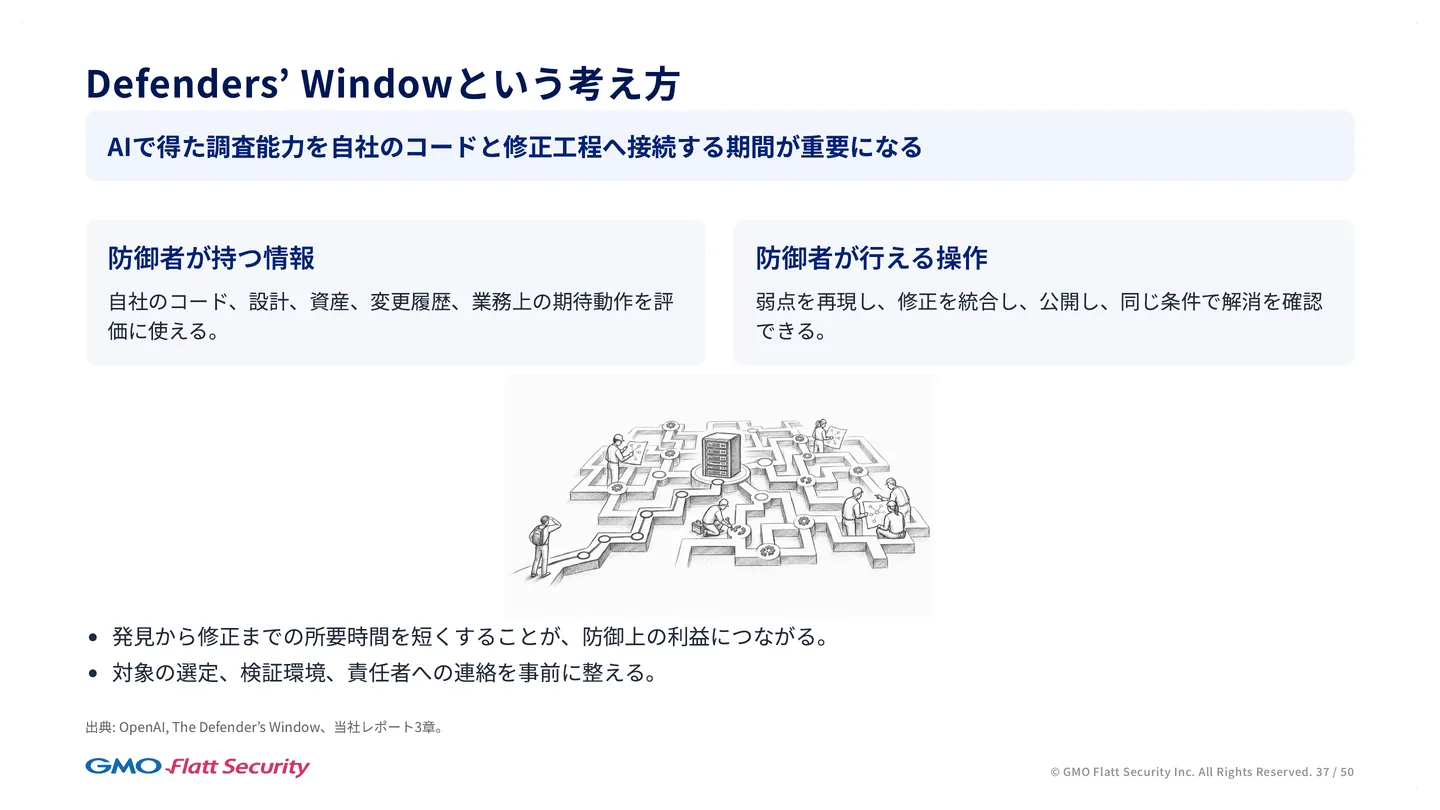
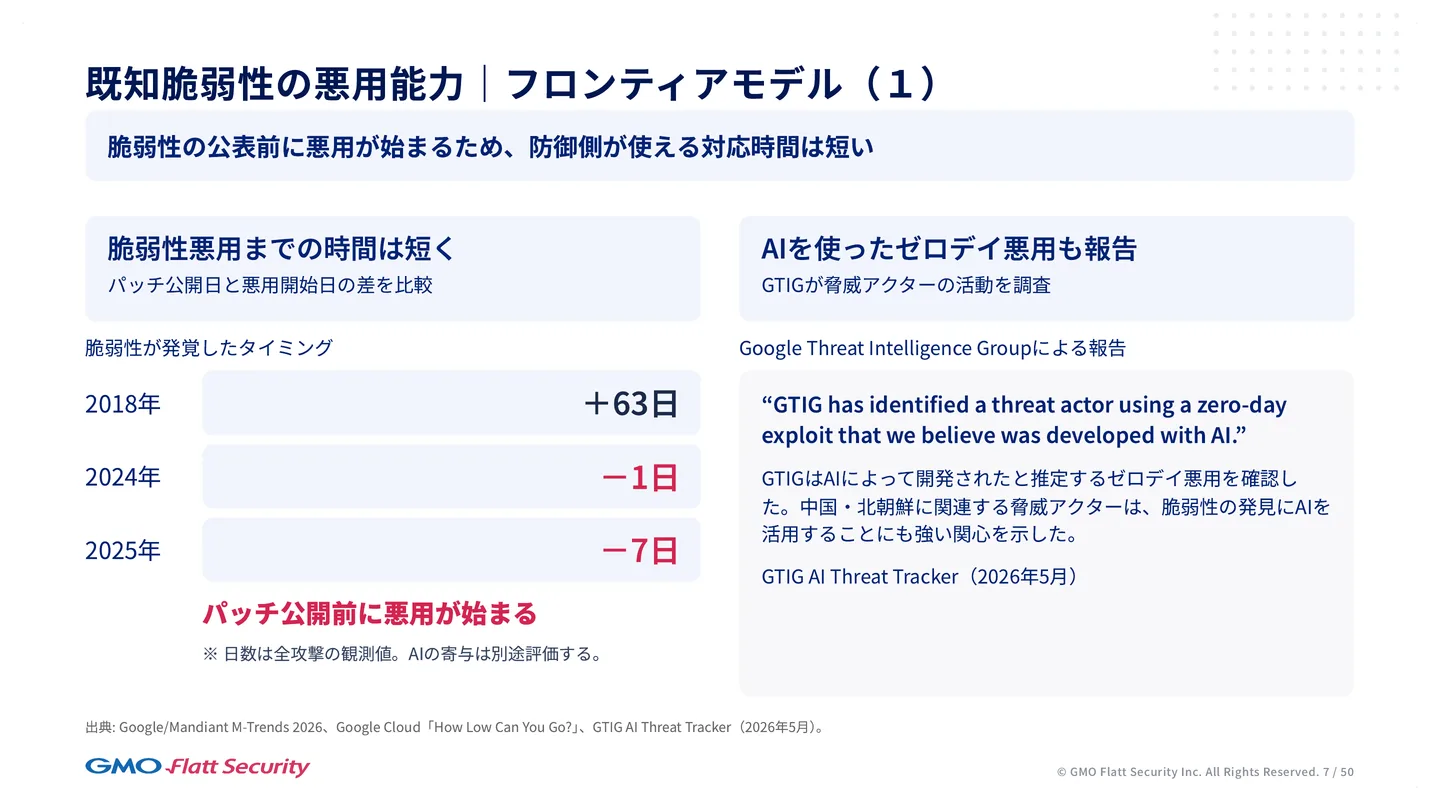
OpenAI は「Defender’s Window」を提唱しています。直訳すると「守る側に残された猶予」で、守る側が攻撃者より優位に立てている部分ではその猶予を活かそう、という考え方です。その時間の幅は、小さくなり続けています。
フロンティアモデルがオープンウェイトモデルより2〜3か月ほど先を行っている今は、守る側がフロンティアモデルを活用して、自社のコードや自社が依存しているオープンソースの脆弱性を探して潰し、守りを固められます。人に関わる観点はこれでは守れませんが、システムの観点では、フロンティアモデルで対処できるところが多くあります。オープンウェイトモデルの能力がまだ追いついていない間に、それを済ませておくべきだ、というのが要点です。
この猶予には、2つの段階があると考えられます。
- 攻撃者が、AI で割に合う形で攻撃を自動化できるようになる前: 守る側は時間をかけて調べ、フロンティアモデルを活用して直していけます。
- 攻撃者が、AI で割に合う形で攻撃を自動化できるようになった後: バグノミクスが崩れ、攻撃を繰り返したほうが得な状態になります。善意のリサーチャーにとっても、善意を捨てたほうが得な瞬間が訪れます。フロンティアモデルで全領域を守れるわけではないので、モデルの性能では守る側が優位でも、経済的には攻撃者が優位になります。
1つ目の段階は、すでに過ぎたと考えられます。オープンウェイトモデルでも、脆弱性の発見と悪用が十分にできるようになったからです。半年前のベンチマークの結果ではそうは考えませんでしたが、今は2つ目の段階に入ったと感じています。フロンティアモデルを含め、AI に限らず今使える最も強い手段を使って脆弱性を潰していかなければ、経済的に得をする攻撃者が優位な状態になります。
その先には、さらに厳しい状況が待っています。数学や製薬のように、能力が天井知らずに伸びてほしい分野と違い、システムへのサイバー攻撃は、システムのコードと動いている実装が与えられた、比較的閉じた問題です。完全なテストをするのは、難しい数学の問題を解くより簡単です。そのため、サイバーセキュリティの能力は、オープンウェイトモデルとフロンティアモデルで、いずれ近づいていくと考えられます。そうなると、攻撃者は今より強い能力を持つことになります。ゆっくり対処できる時間はすでに終わり、これからさらに厳しくなっていくと考えて備えるしかありません。
脆弱性情報・脅威情報・推論資源の3つを調達する
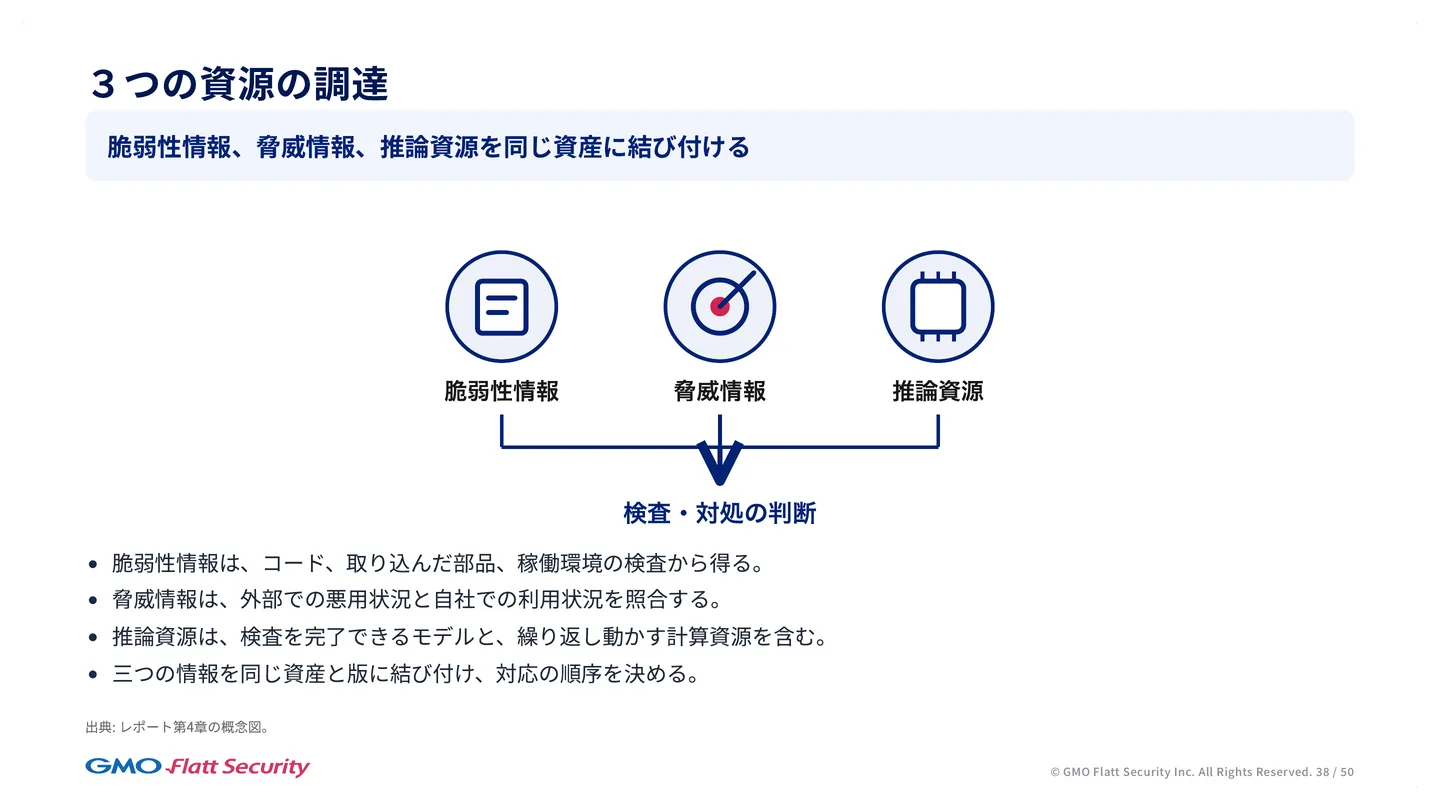
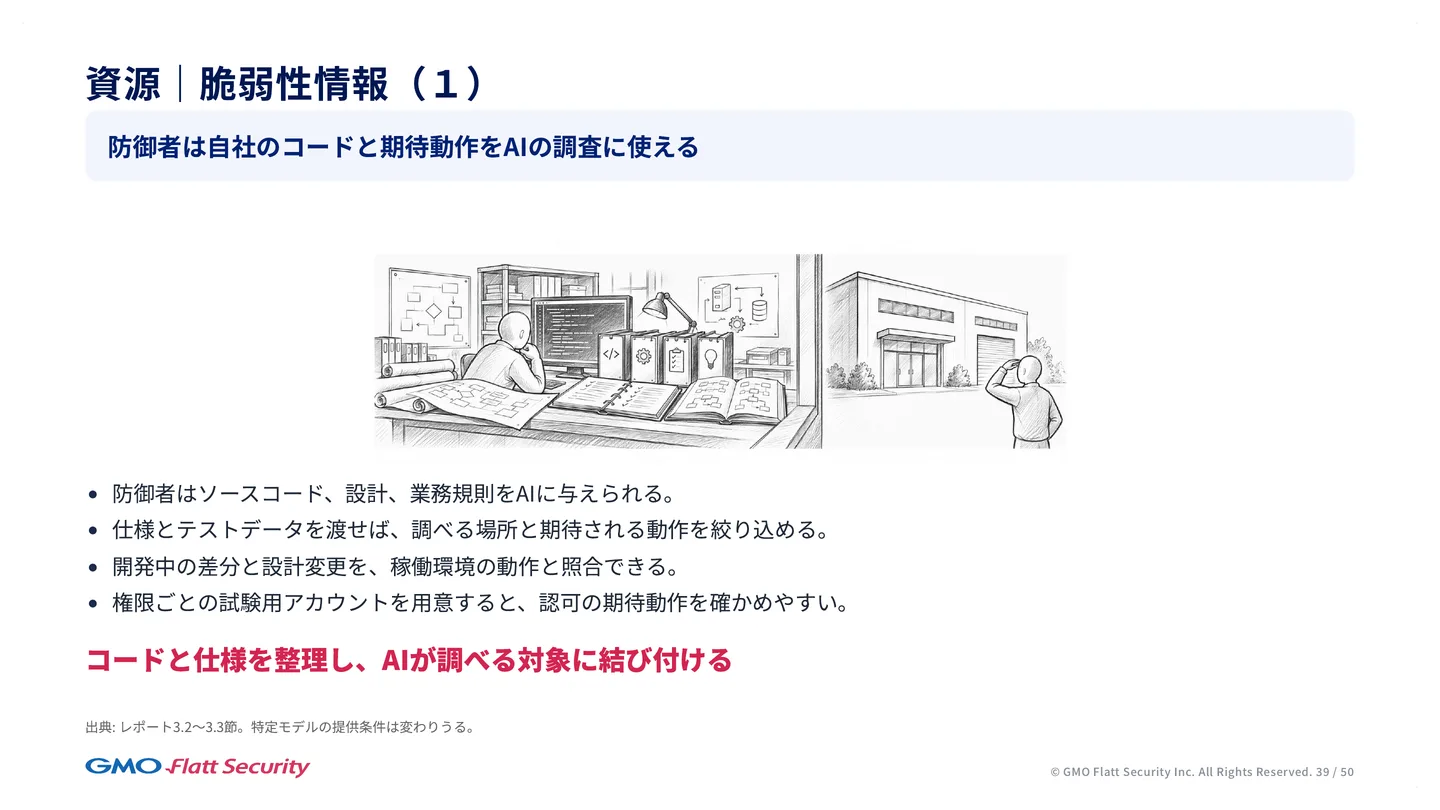
守る側が AI を活かすには、AI に渡す情報と、AI を動かす資源の両方をそろえる必要があります。調達すべき資源は、次の3つです。
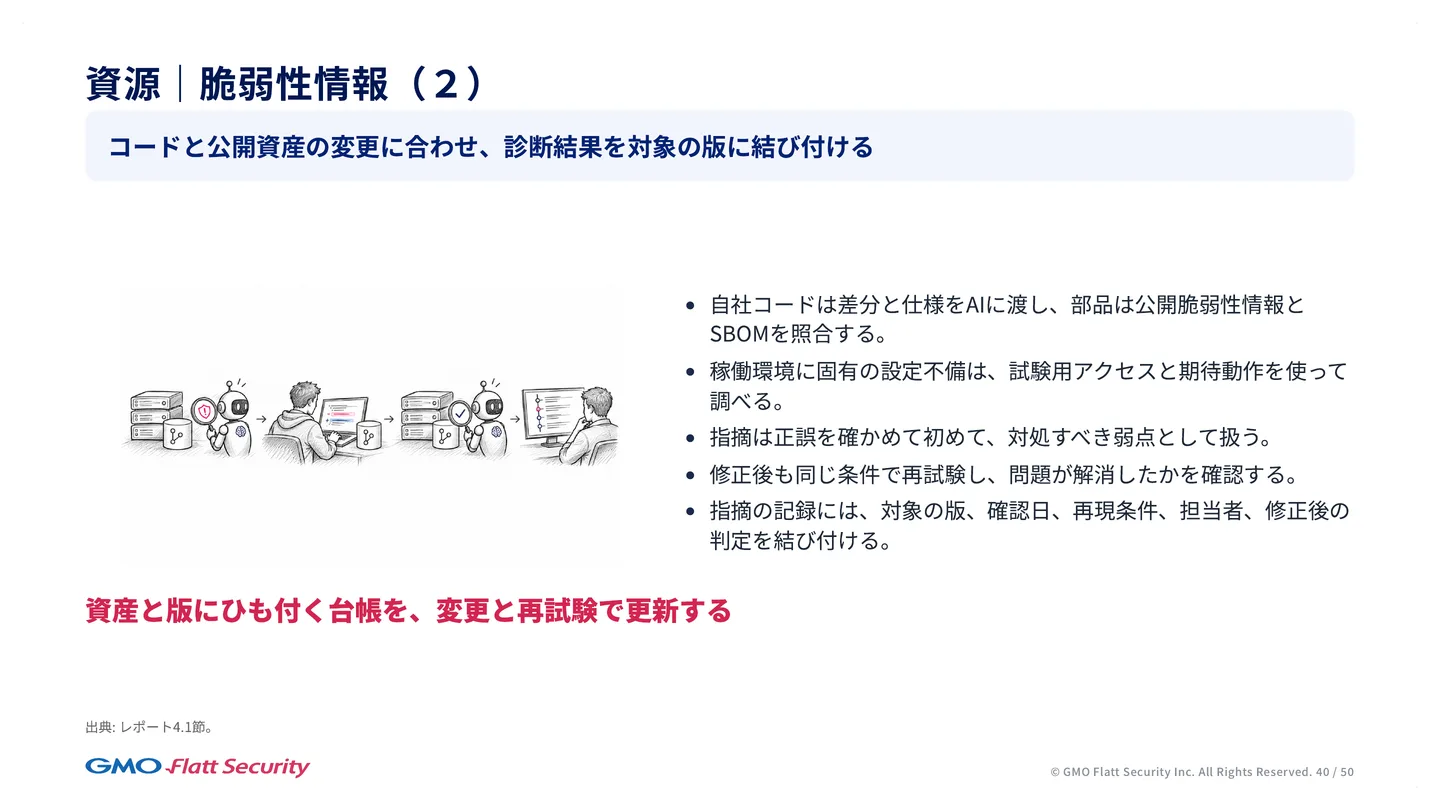
- 脆弱性情報: 今は脆弱性の情報が大量に出ていて、処理しきれない状態です。自社が使っているオープンソースでも、メンテナーの態度によっては脆弱性が直らないことが多くあります。CVE を見ているだけでは足りず、自社が使っているものが今どのようなセキュリティの状態にあるかを示す情報を、自社にうまく取り込めているかが課題になっています。
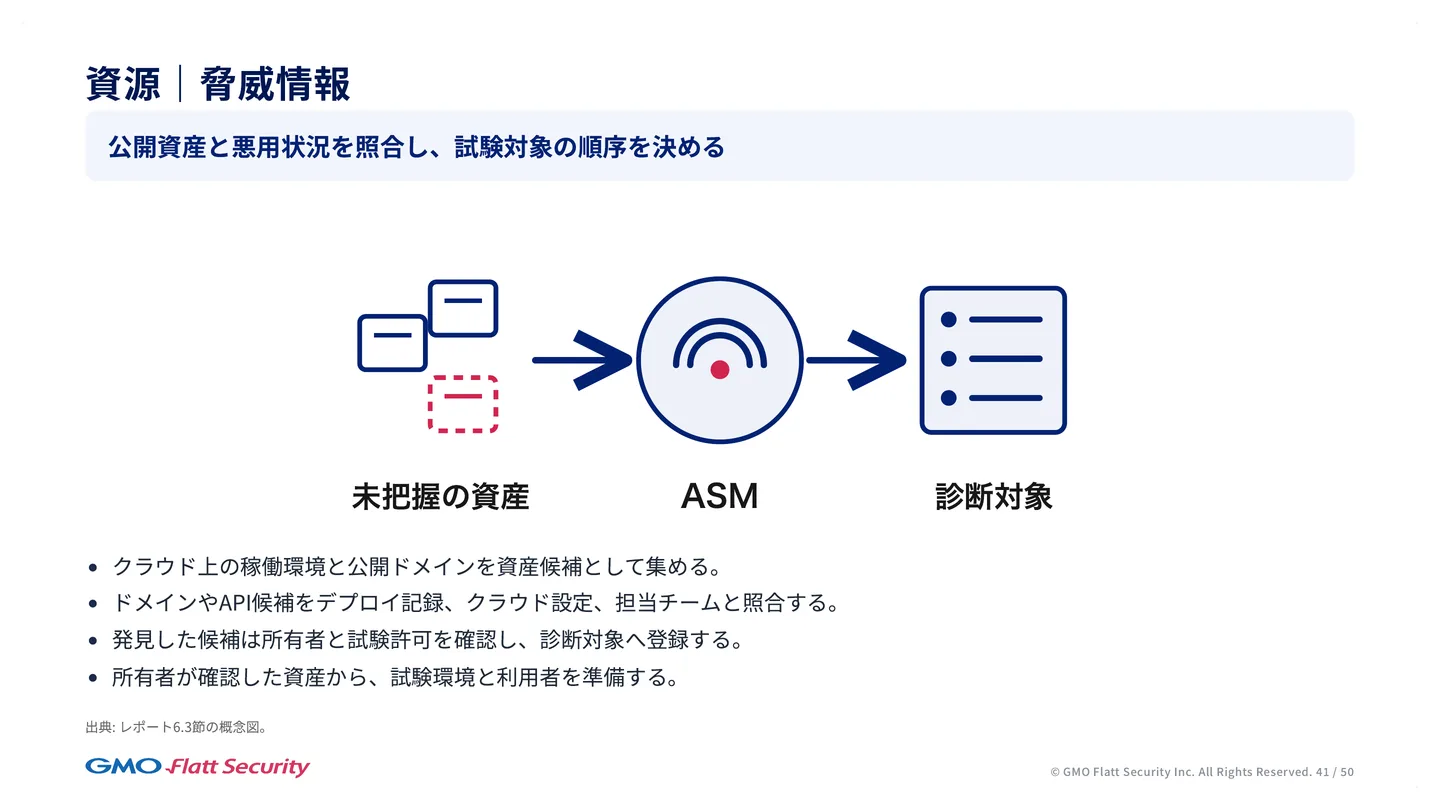
- 脅威情報: これまでと同じく、誰が自社を狙っているのか、攻撃者の目線が今どこにあるのかを示す情報です。最近はソフトウェアサプライチェーンも狙われるようになりました。攻撃者がどこに向かっているのかという情報を取り込めることが重要です。
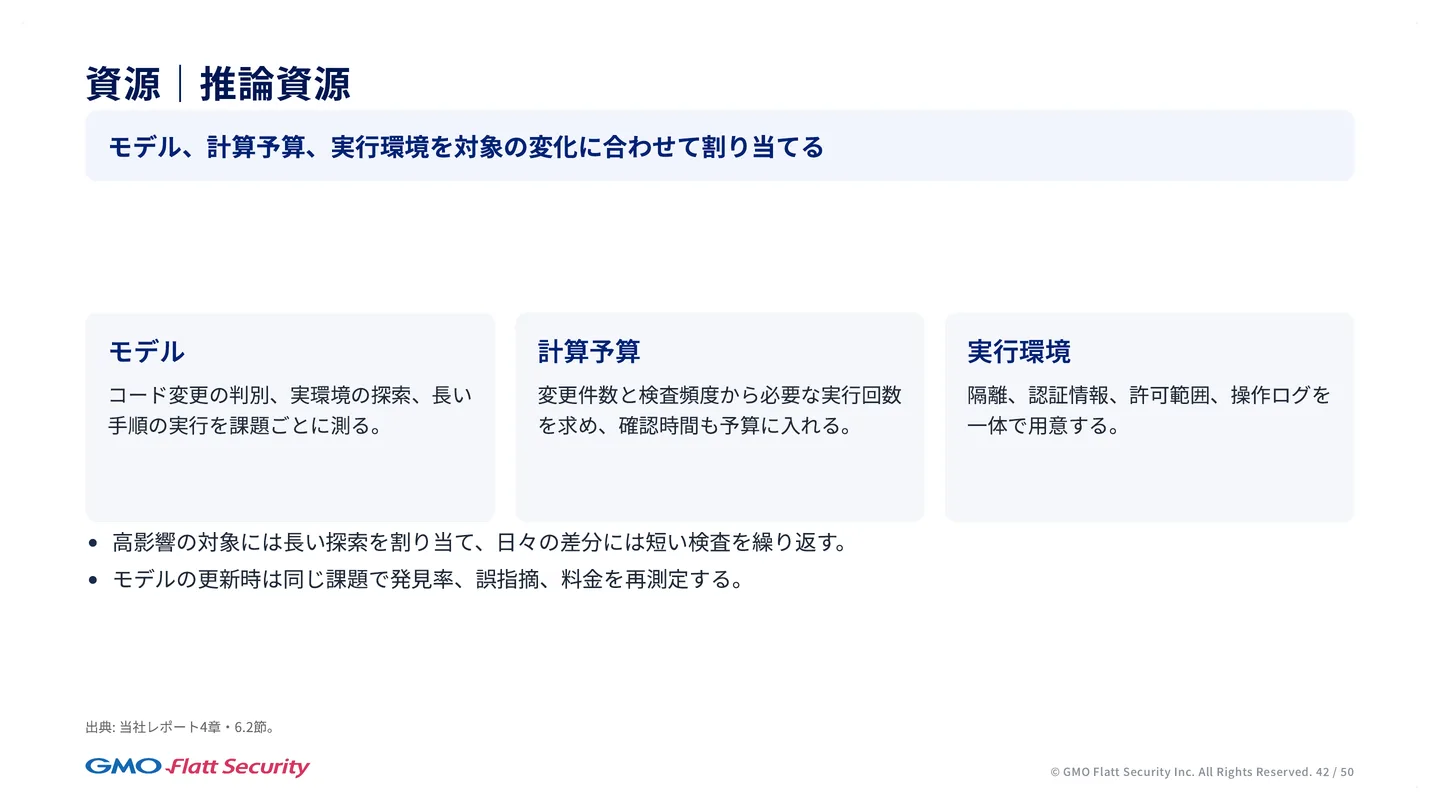
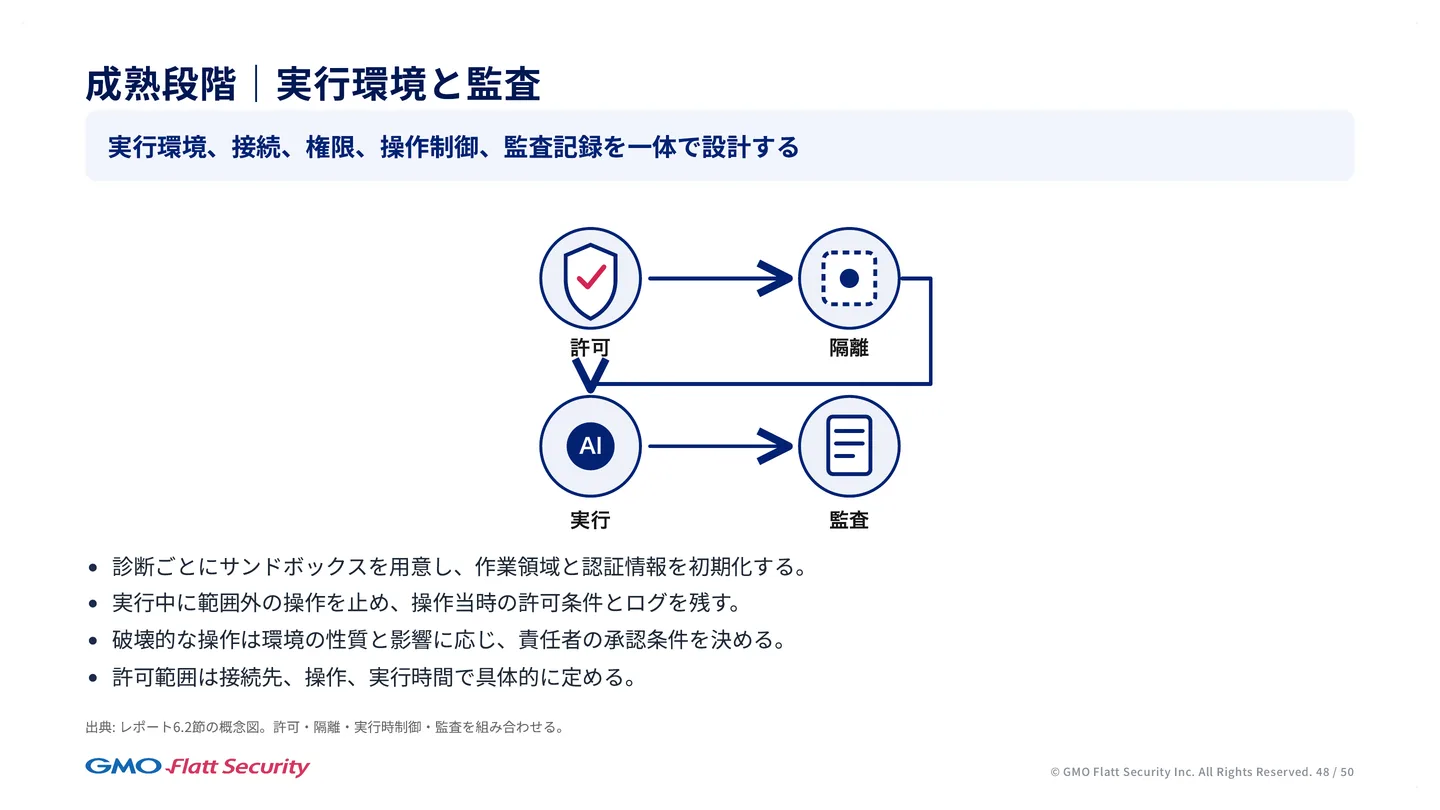
- 推論資源: 自社を守るのに足りるモデルと、それを動かす推論資源があることです。人を採用するのと同じように、組織として計画して確保する必要があります。セーフガードのせいで、セキュリティの業務にモデルを使おうとしてもできないことは多くあります。それが続くと、攻撃者の優位が続いてしまいます。守るために AI を支障なく使える状態になっているかは、経営やマネジメントにとっても重要な調達の問題です。
AI による評価を単発から継続へ、さらに自動修復へ進める
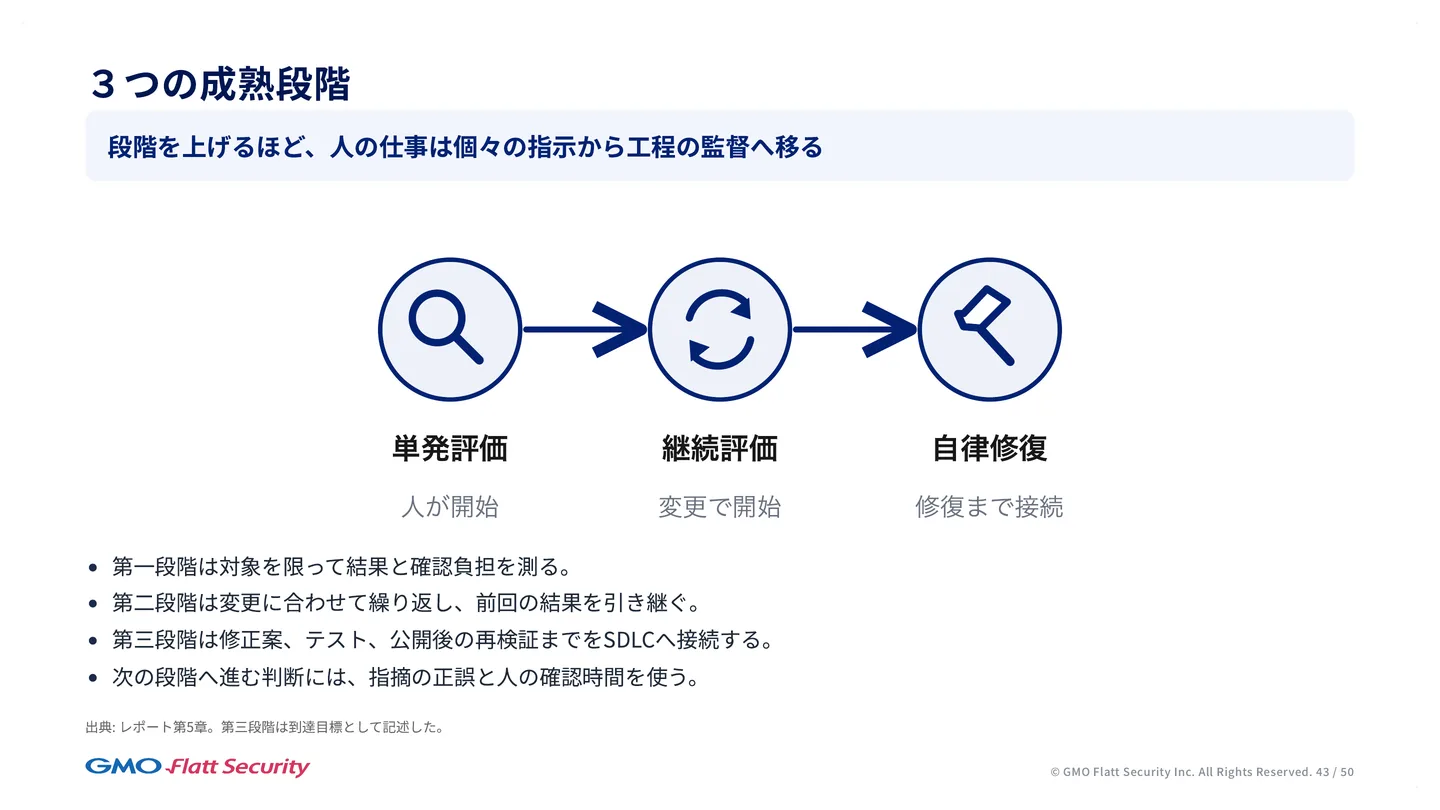
調達した資源を使って、次の3つの段階で進めることをおすすめします。
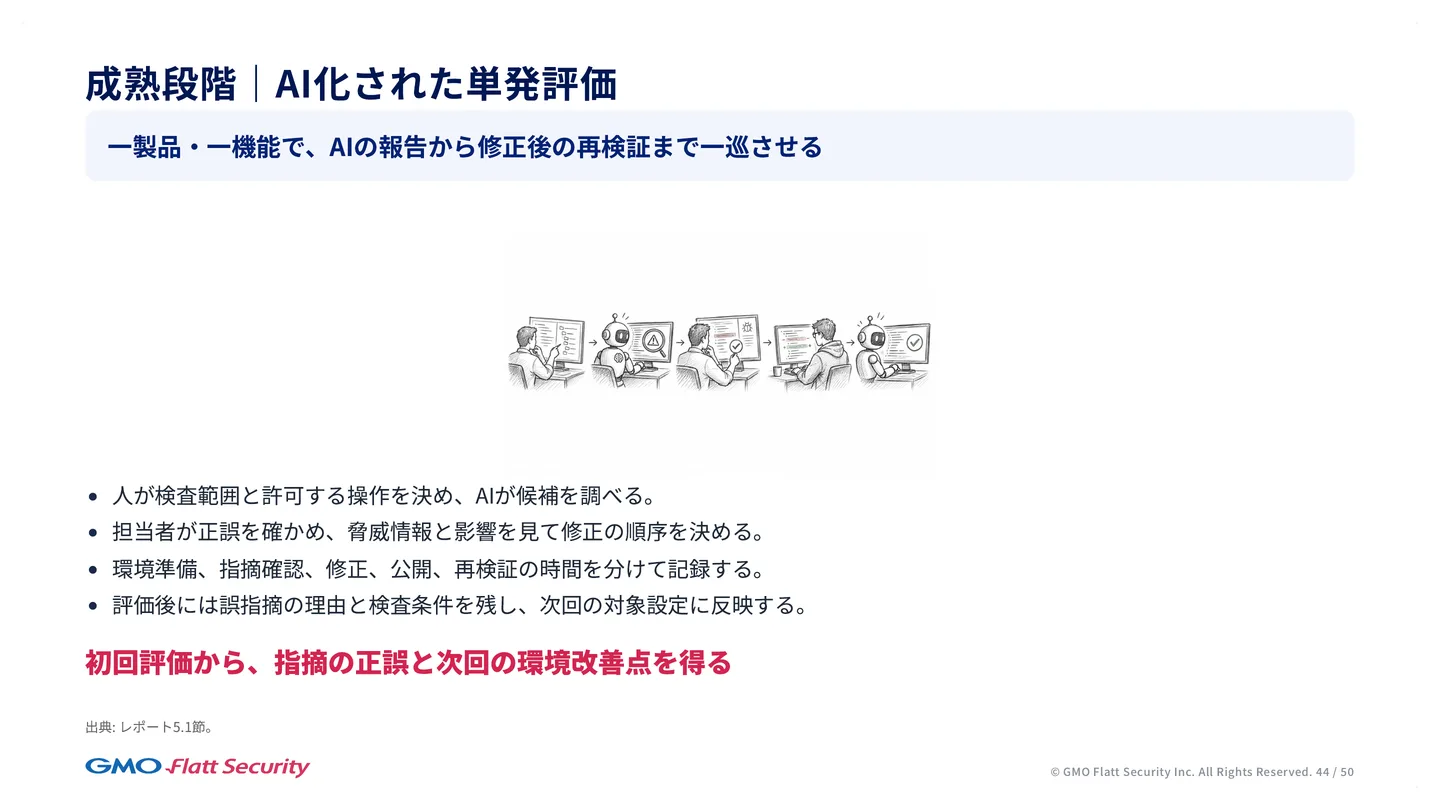
- AI による単発の評価: 今は外部のベンダーに頼んでいる診断や、自社へのペネトレーションテストを、AI で行う形に変えます。最初は年1回でも構いません。診断を事業にしている弊社にとっては不利に聞こえるかもしれませんが、世の中はこの方向に向かうべきだと考えています。
- AI による継続的な評価: AI で軽く行えるようになった評価を、毎月、毎週、毎日と、頻度を上げていきます。
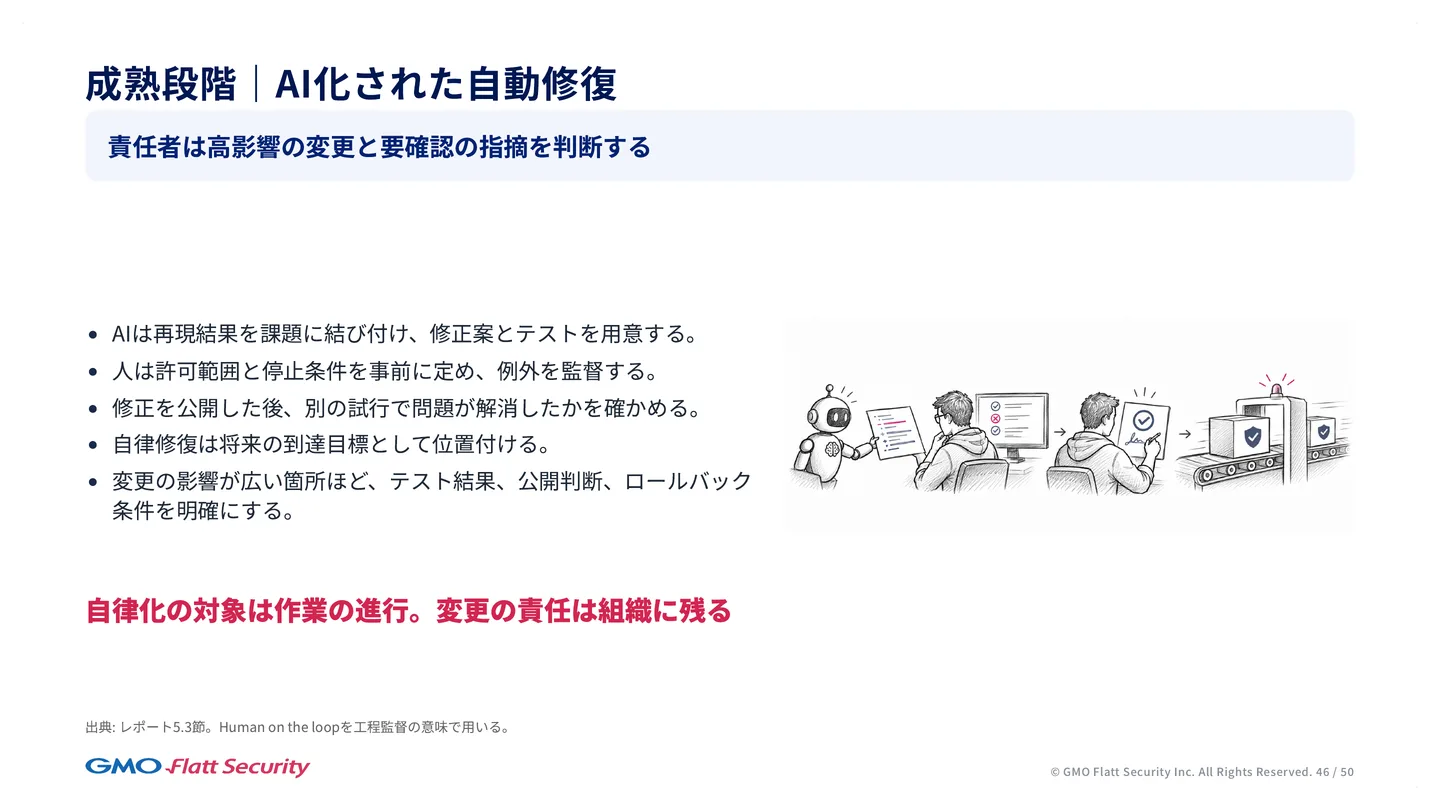
- 自動修復: 継続的に評価すると、脆弱性が数多く見つかります。弊社でも、人が行っていた頃に比べて、報告する脆弱性の数が5〜6倍の規模になりました。優先順位を付けて対応する、というやり方では、おそらくほとんど間に合いません。最終的には、見つかったものを一通り自動で直すところまで進めなければなりません。
3つ目は大きな飛躍に聞こえるかもしれません。しかし、人が処理するやり方のままでは、人がボトルネックになるので、避けては通れない段階です。
最大の課題はセキュリティと開発の分断
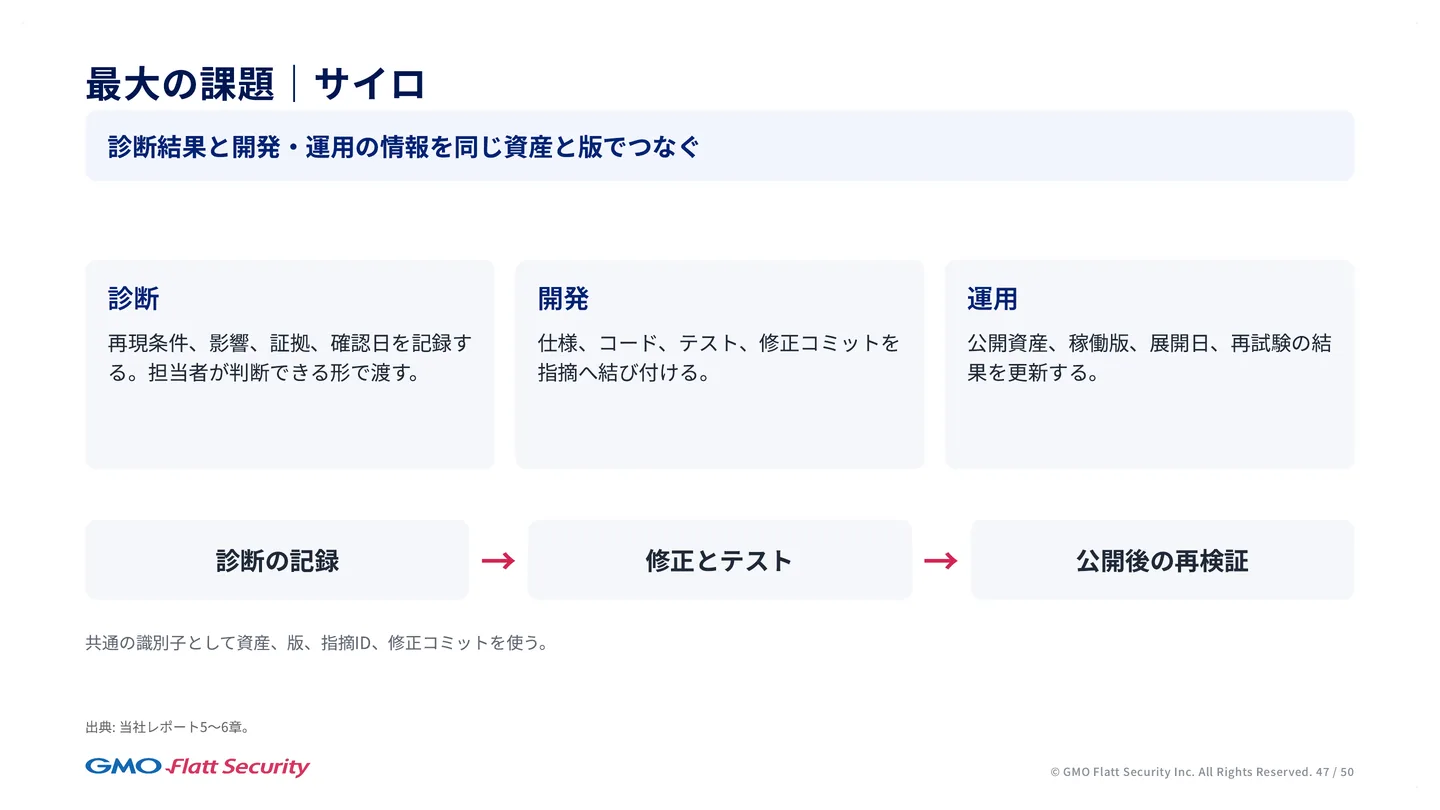
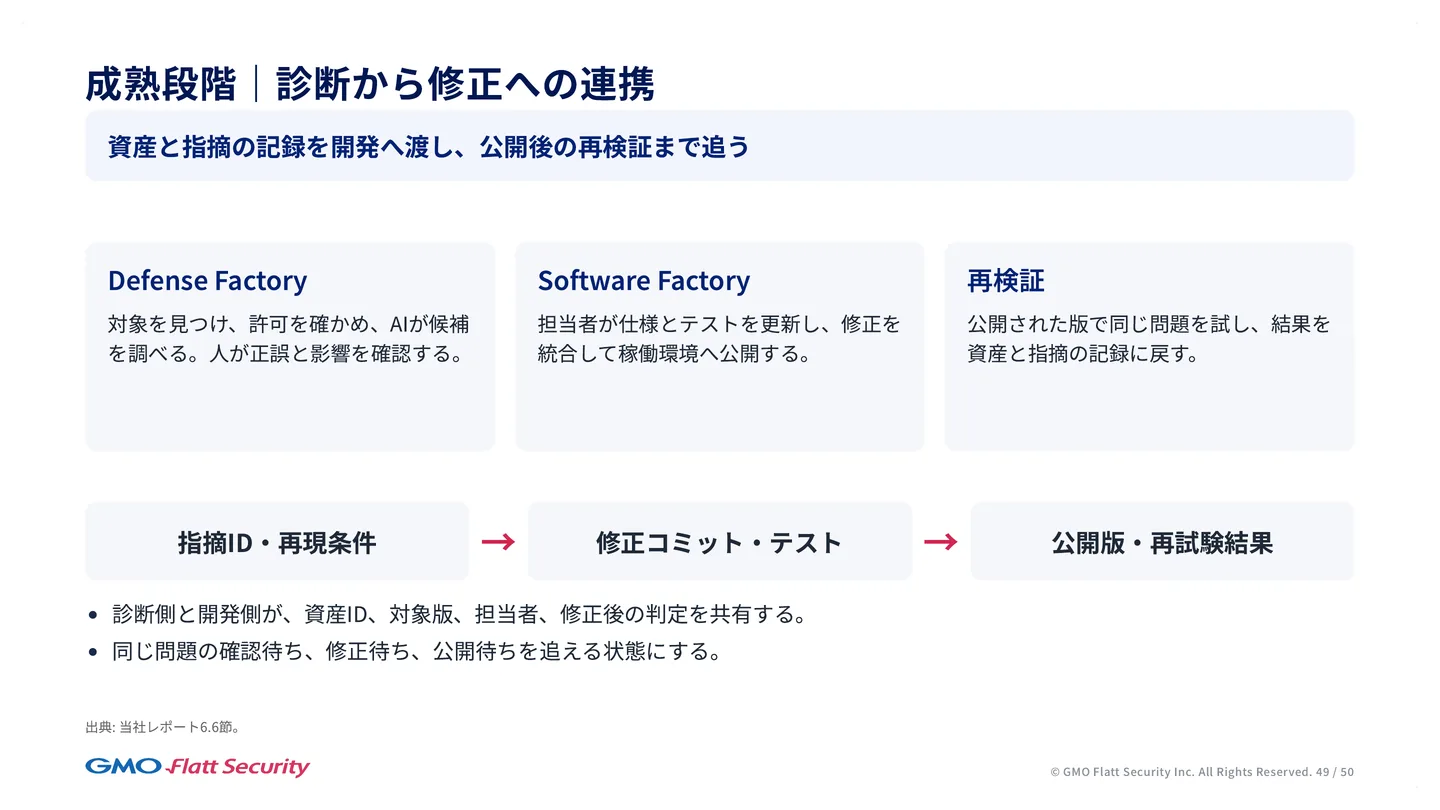
ソフトウェアやシステムのセキュリティを突き詰めると、最後は「自社のソフトウェアを、頻繁に変更・改善できる環境になっているか」という問題に行き着きます。企画の段階でセキュリティに取り組む、パッチをセキュリティの観点でレビューする、シフトレフトを進める、あちこちにスキャナーを入れる、といったことをしても、ここが整っていなければ、いずれ先に進めなくなります。脆弱性の数や攻撃の速さが大きく変わった今、パッチを当てなければならないときに当てられる体制になっているかは、なおさら重要です。
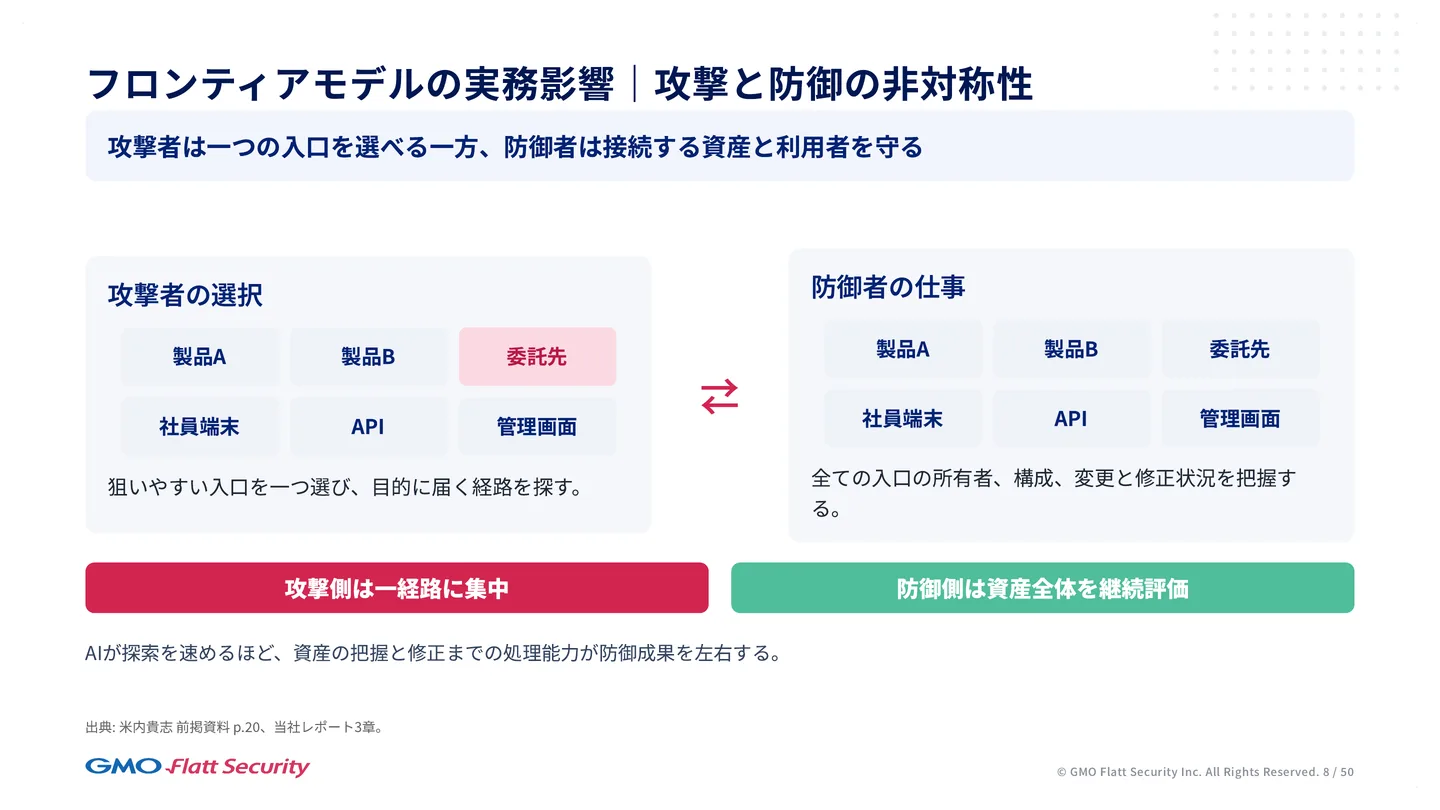
技術の面では、デプロイの仕組みやシステムの頑強さ、CI/CD のような仕組み、ソフトウェアの開発そのものがどれだけ AI を取り入れているかの問題になります。組織の面では、最大の問題は、担当ごとに仕事が分かれて互いの領域に手を出せない、組織のサイロです。「セキュリティの担当なので、システムに変更は加えられません」という時点で、対応が遅れます。今の攻撃の速さや、公開された脆弱性がすぐに悪用される速さ、AI がロジックの脆弱性を自律的に数多く見つける状況では、セキュリティの担当がその役割の線を守るほど、対応が難しくなります。「ソフトウェアエンジニアはセキュリティの責任を持たない」というのも、正しくなくなっていきます。
このサイロを壊せるかどうかが、これから多くの組織に求められる変革になると考えられます。サイロをどう解くかに、決まった答えはありません。弊社も、まずは自社のエンジニアリングの体制で、さまざまな試みをしている段階です。サイロの問題をどう解くかは、セキュリティの業界全体、そしてソフトウェアを開発しているすべての組織の課題になっていくと考えられます。解き方は1通りではないので、それぞれの組織で検討する必要があります。