
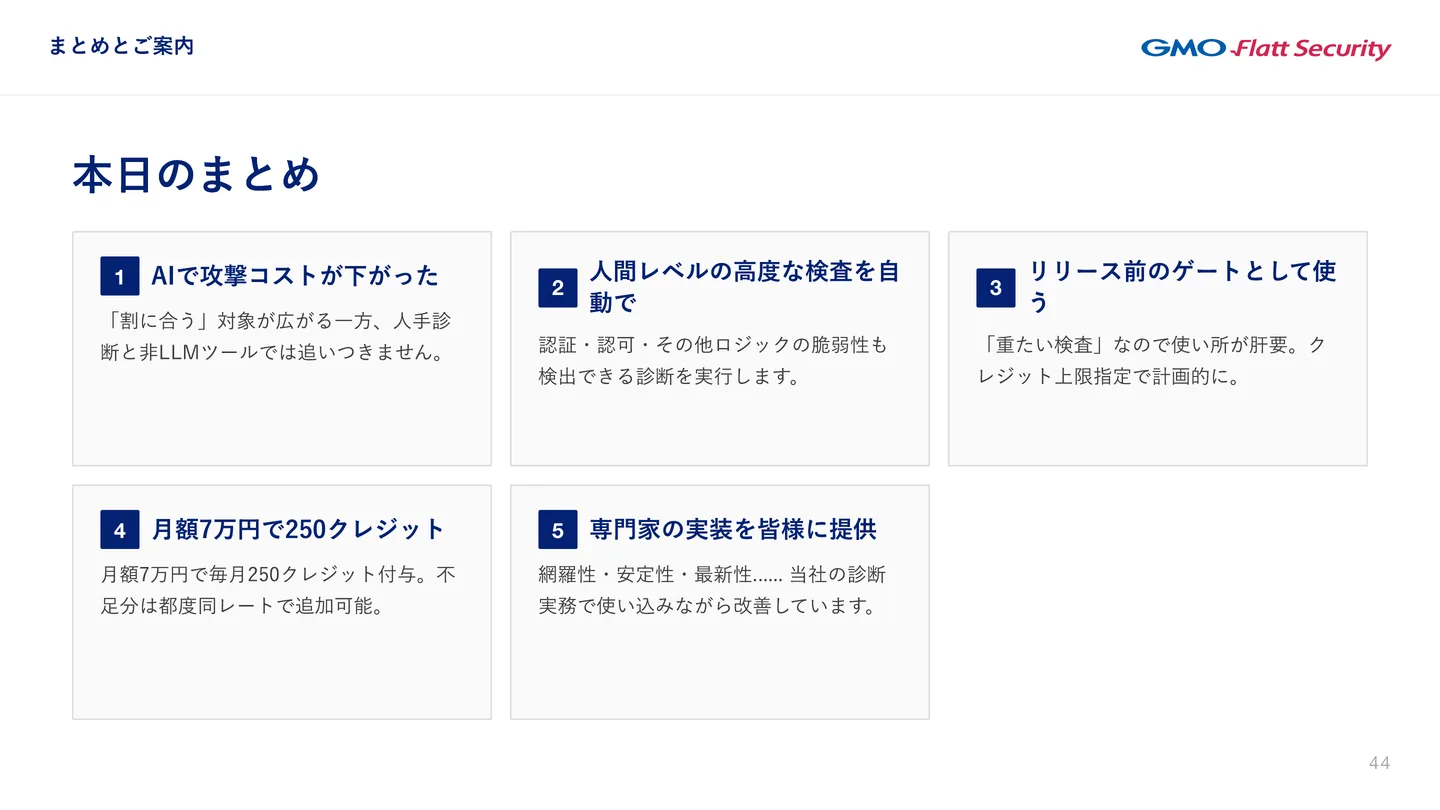
AI の登場で、攻撃に要る費用とスキルの下限が下がり、所要時間も短くなって、攻撃が「割に合う」対象が広がっています。守る側も、年に1回の人手の診断と AI を使わないツールだけでは追いつきません。この記事では、AI で攻撃と守りの前提がどう変わったのかを押さえたうえで、弊社のセキュリティ AI エージェント Takumi byGMO の脆弱性診断とペネトレーションテストの機能、実際の運用の型と開発の流れの中での位置づけ、料金とクレジットの見積もり方、コーディングエージェントとの違いを紹介します。
AI の進化が攻撃と防御の前提を変えている
AI を使った攻撃はすでに現実に起きている
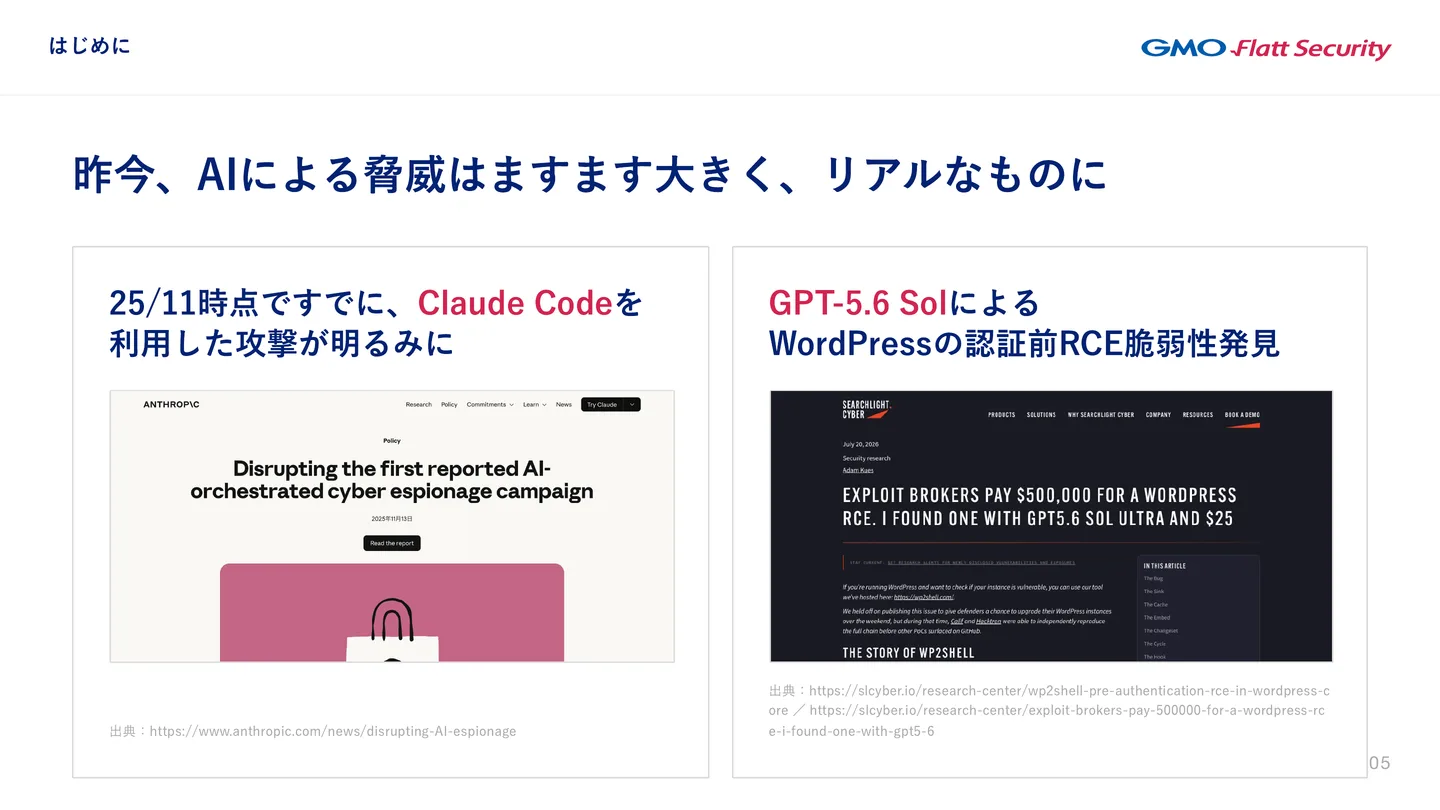
AI による脅威は、ますます大きく、現実のものになっています。2025年11月の時点で、Claude Code を利用した中国系の攻撃者による大規模な攻撃が Anthropic の報告で明らかになり、大きな話題になりました。AI が攻撃に使えるというだけでなく、実際に使っている攻撃者がいます。Claude Mythos の実力も広く報じられ、Anthropic のモデルに限らず GPT-5.6 Sol のようなモデルも非常に高い能力を持つことは、セキュリティエンジニアの間でも話題です。
最近では、WordPress に、認証なしで外からコードを実行できる脆弱性が見つかりました。発見者のブログによると、この脆弱性は基本的に GPT-5.6 Sol に任せて自律的に見つかったものです。世界中に影響を与える脆弱性が AI で自律的に見つかる時代、極端に言えば、AI に課金すれば誰でも見つけられる時代が訪れています。
AI で攻撃に要る費用・時間・スキルが減り、割に合う対象が増えた
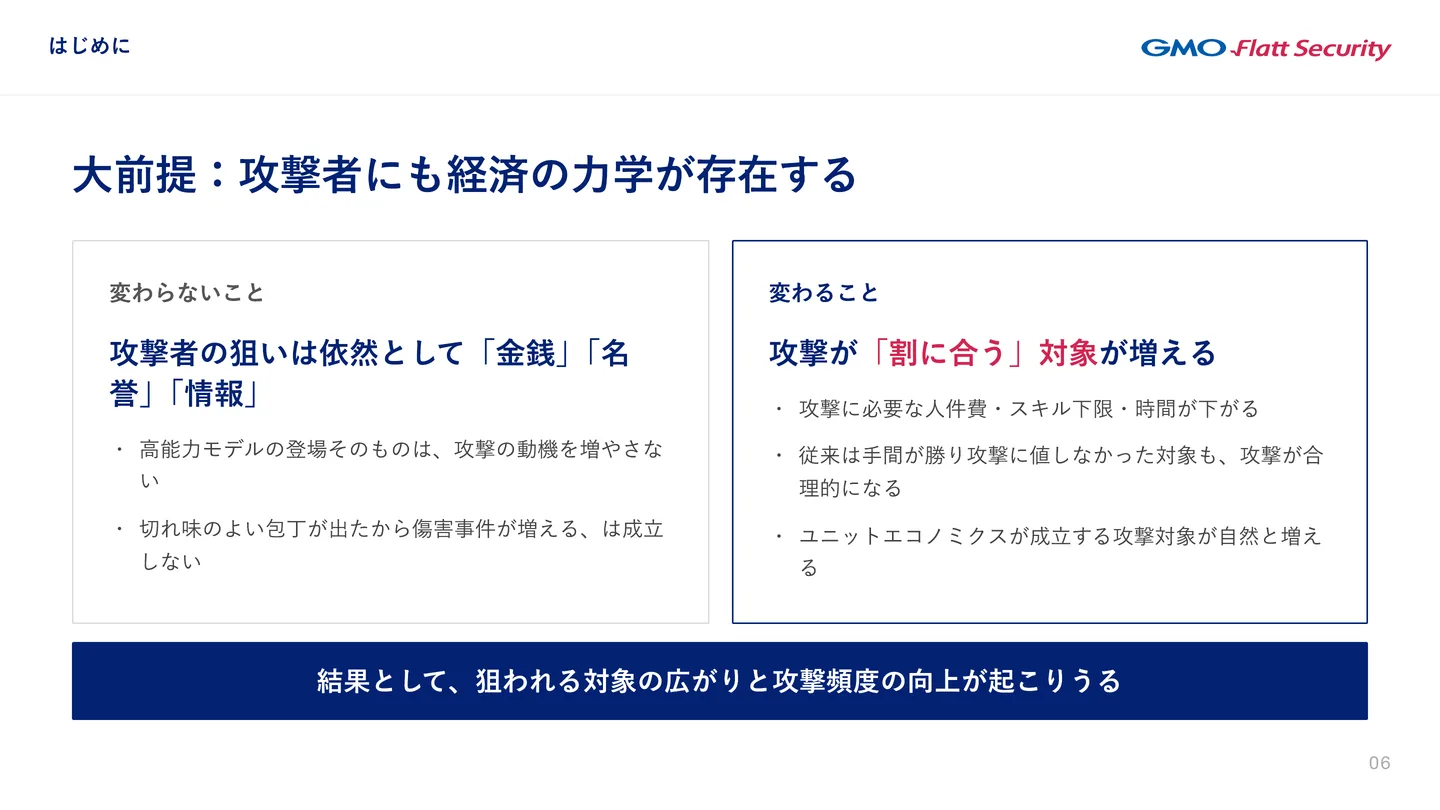
AI がこうしたことをできるようになった、というセンセーショナルな面だけを見るのではなく、攻撃者にも経済の力学があるという大前提を見つめ直す必要があります。攻撃者は、割に合わないこと、儲からないことはしません。
変わらないのは、攻撃者の狙いです。金銭、名誉、情報といった目的は、AI によって変わったわけではありません。切れ味のよい包丁が出たからといって傷害事件が増える、という理屈が成り立たないのと同じで、能力の高いモデルが出たこと自体は、攻撃の動機を増やしません。
変わったのは、攻撃が「割に合う」対象が増えたことです。AI は人に比べて安く、スキルも要らず、速いので、攻撃に要る人件費とスキルの下限が下がり、所要時間も短くなりました。これまで手間が勝って攻撃に値しなかった対象でも、攻撃が合理的になります。結果として、狙われる対象が広がり、攻撃の頻度が上がることが起こりえます。
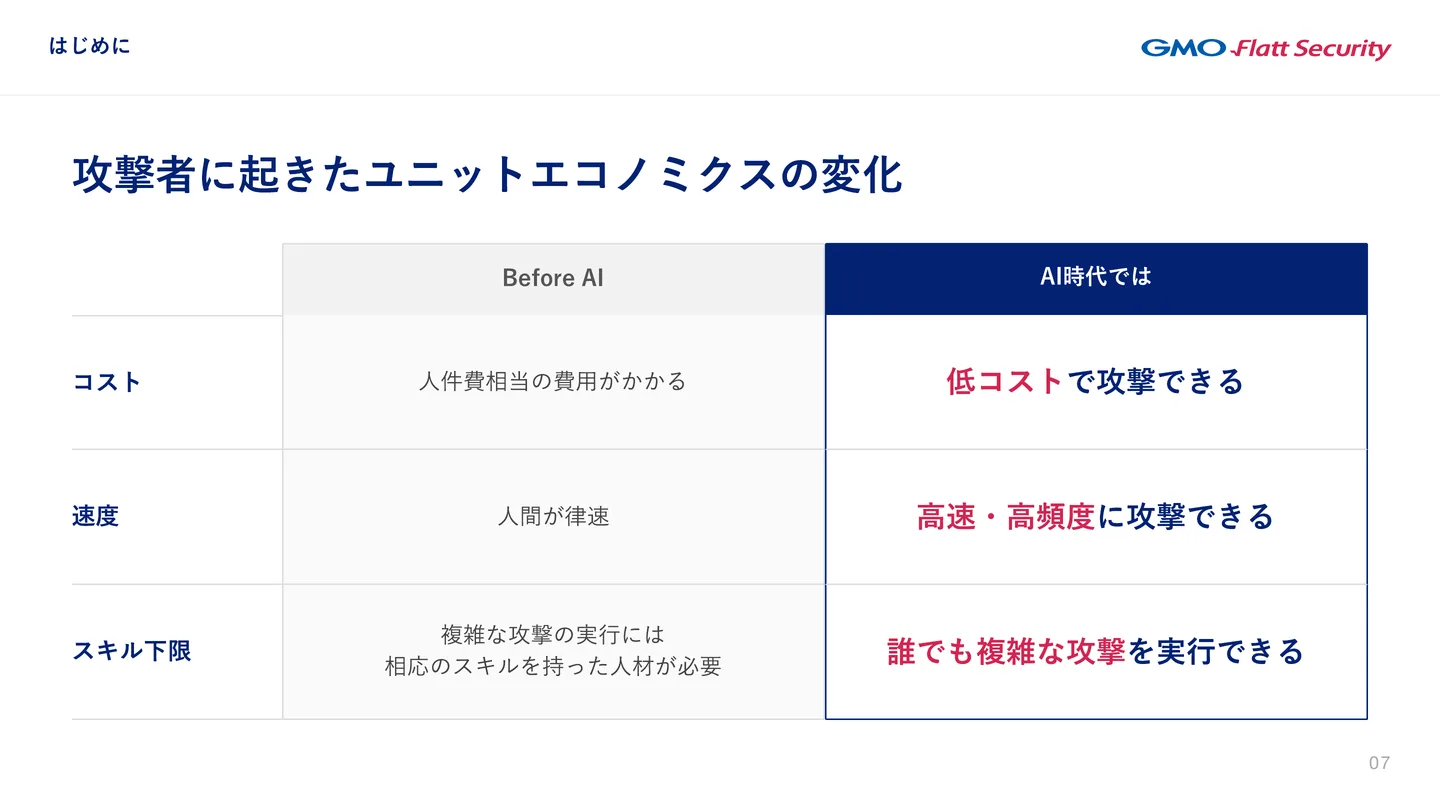
- コスト: AI の前は、セキュリティエンジニアに相当する専門の知識を持つ攻撃者が動く必要があり、人件費に相当する費用がかかりました。AI の時代には、数万円、場合によっては数千円の水準まで下がっています。
- 速度: 高度な攻撃は人にしかできず、人には睡眠が要り、手の速さにも限りがあるので、人の速さが攻撃の速さの上限でした。AI が自律的に行えば、人が何日もかけていたことが数時間で終わり、高い頻度で攻撃を仕掛けることもできます。
- スキルの下限: 複雑な攻撃には、相応のスキルを持った人が必要でした。今は、誰でも複雑な攻撃を実行できます。
攻撃側が AI で加速し、拡大する以上、守る側も対策の速度と質を高めることが必須です。複雑な攻撃が仕掛けられてくるためです。
人手の診断と AI を使わないツールでは AI 時代の攻撃に対処しきれない
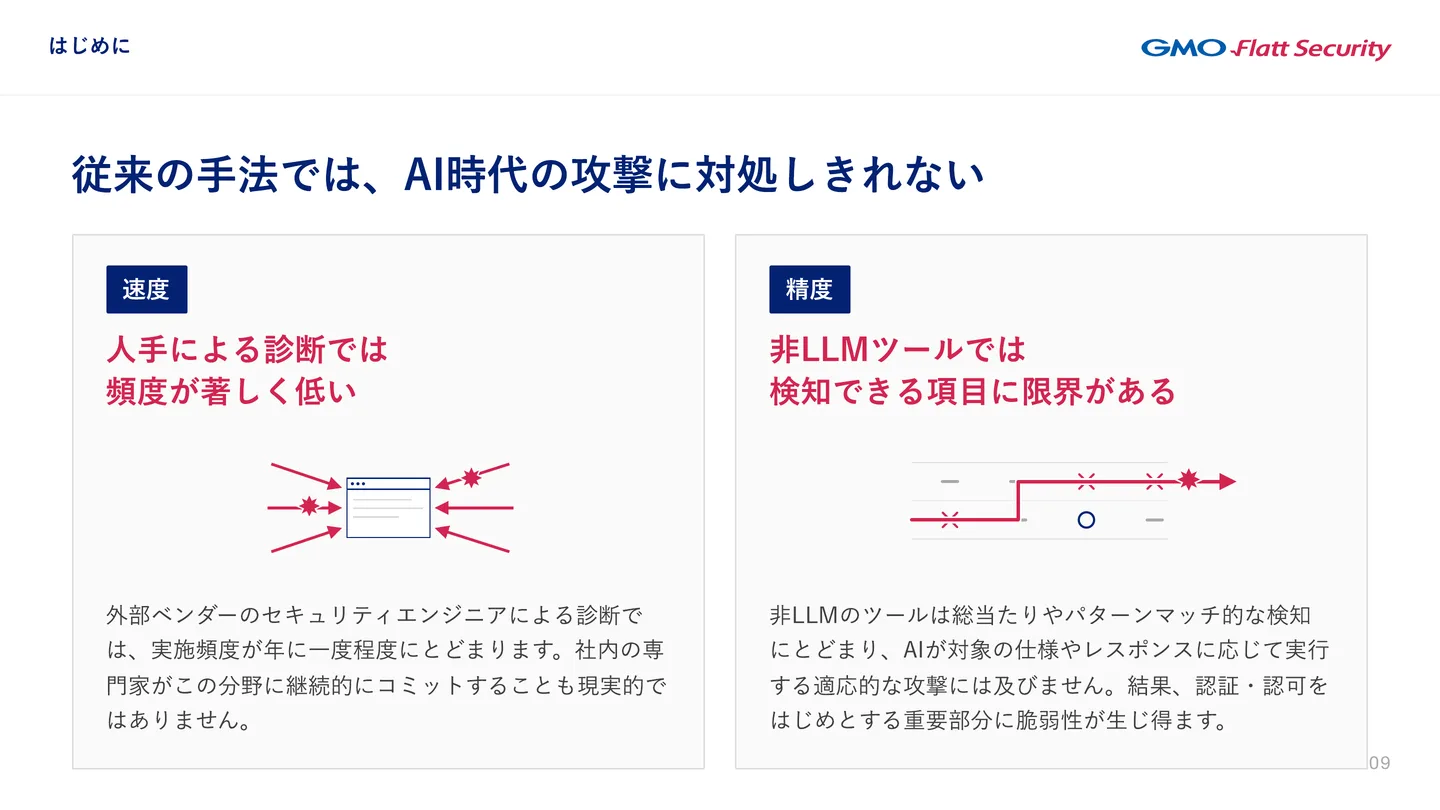
守る側で使われてきた従来の手法は、AI の時代の攻撃に対処しきれません。観点は、速度と精度の2つです。
速度: 人手による診断は、頻度が著しく低い。 複雑な脆弱性を検出するためには、人が行う脆弱性診断やペネトレーションテストが必須でした。弊社もその事業を行っているのでよく分かりますが、外部のベンダーに発注すると、費用も手間もかかるので、頻度はせいぜい年に1回です。それ以上の頻度で行う会社はほとんどありません。社内にその能力を持つセキュリティエンジニアがいればもう少し頻度を上げられますが、社内のセキュリティエンジニアの業務は多岐にわたり、脆弱性診断のような攻撃側の業務だけに専念する余裕はないので、高い頻度で対応するのは難しいのが実情です。
精度: AI を使わないツールは、検知できる項目に限界がある。 ツールを使えば、速度と頻度はこれまでも上げられました。DAST(動的なセキュリティ検証)や SAST(静的なセキュリティ検証)と呼ばれるもので、それなりに広く使われています。しかし、こうした AI を使わないツールは、速度は速くても、検知できる項目に限界があります。それも「あと一歩で完璧」という水準ではなく、検知できる項目はかなり限られていると弊社は捉えています。動的な検証では攻撃が効きそうな値を総当たりで投げ込む、静的な検証では事前に定義したルールにパターンマッチで合致するものだけを検知する、といったことしかできないためです。AI であれば、レスポンスを見たり、アプリケーションの仕様を考えたりしながら、適応的な攻撃を実践できます。この点で、両者の差は大きいものです。
人が行うか、AI を使わないツールで行うかの2つの手法には、どちらにも明確に欠ける部分があります。このボトルネックを解消するには、AI を使うしかありません。攻撃者が AI によって速く、高い品質の攻撃を手に入れている以上、守りも AI を使わなければ、速度か精度のどちらかが明らかに不足します。AI の時代にもプロダクトを守り抜くには、AI を使って、セキュリティ対策を外部に頼らず自社で回せるようにすべきです。
脆弱性診断とペネトレーションテストの違い
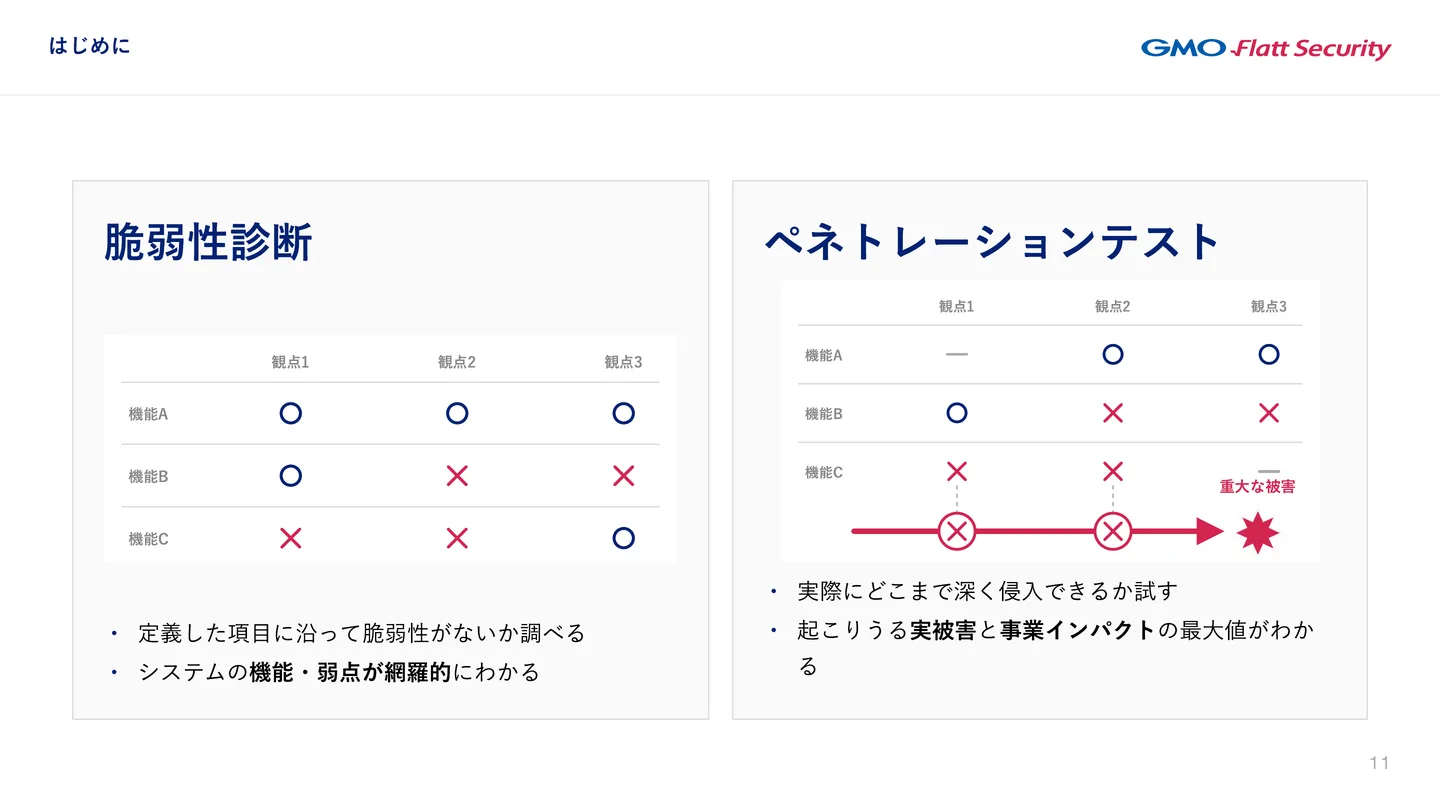
攻撃者からの守りを考えるときの手段には、主に脆弱性診断とペネトレーションテストがあります。人によって定義が揺れるので、弊社の定義を示します。Takumi は両方を行えます。
- 脆弱性診断: 機能(A・B・C)と観点(XSS があるか、SQL インジェクションがあるか、認可制御不備があるかなど)を掛け合わせたマトリックスを作り、定義した項目に沿って、すべてのマスに脆弱性がないかを調べます。機能が3つ、観点が3つなら9マスで、そのすべてを確かめて○のマスと×のマスを出し、×のマスを直していきます。システムの機能と弱点が網羅的に分かります。
- ペネトレーションテスト: 網羅性を担保することは目標とせず、「この情報を奪取されたら困る」といった抽象的なゴールを先に決め、そのゴールに近づくために使えそうな脆弱性を適宜組み合わせ、実際にどこまで侵入できるかを試します。ゴールに関係のないマスは確かめず、複数の脆弱性を組み合わせてゴールへ向かいます。起こりうる実際の被害と、事業への影響の最大値が分かります。
使い分けは場合によります。ペネトレーションテストを先に試したいという方も多いのですが、弊社はこれまで、まず診断で全体のリスクを一通り洗い出し、次の段階として深いテストであるペネトレーションテストを行うよう、お伝えすることが多くありました。この順番は、AI の時代に少し変わりつつある部分があるかもしれません。
AI で脆弱性診断とペネトレーションテストを安く速く高精度に行う
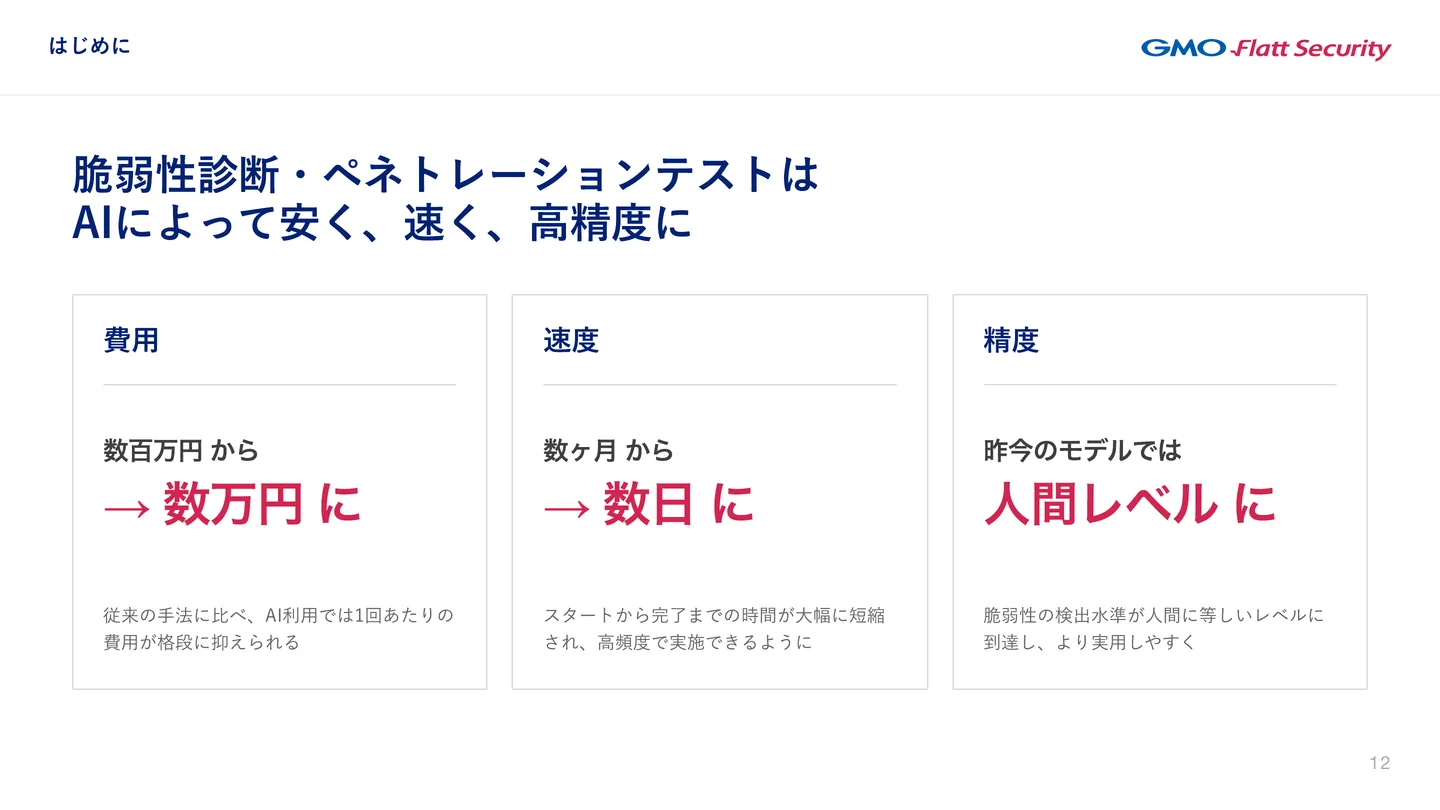
脆弱性診断とペネトレーションテストに AI を活用すると、攻撃者の側と同じような変化が起きます。
- 費用: 数百万円から、数万円に。 外部のベンダーに委託すると、数百万円かかるのが相場です。弊社がベンダーとして行う場合も平均は200万〜300万円ほどで、大きなプロジェクトでは500万円や1,000万円になります。AI に行わせると、1回あたり数万円の水準に落ち着きます。
- 速度: 数か月から、数日に。 外部のベンダーに診断やペネトレーションテストを頼むと、まず見積もりだけで2か月ほどかかることがあります。ベンダーを決めた後も、セキュリティエンジニアの空きの都合で開始は1か月後と言われ、そこから検査の期間が1か月あり、最初に連絡してから報告書を受け取るまでに5か月ほどかかる、ということが起こりえます。人が行うと、複数の段階で月の単位の時間がかかります。AI では数日になり、高い頻度で実施できます。
- 精度: 昨今のモデルでは、人間レベルに。 脆弱性の検出の水準は人間レベルに迫っていて、すでに達していると言える面もあります。
「人間レベルの精度」とは仕様を理解してロジックの脆弱性を見つけられること
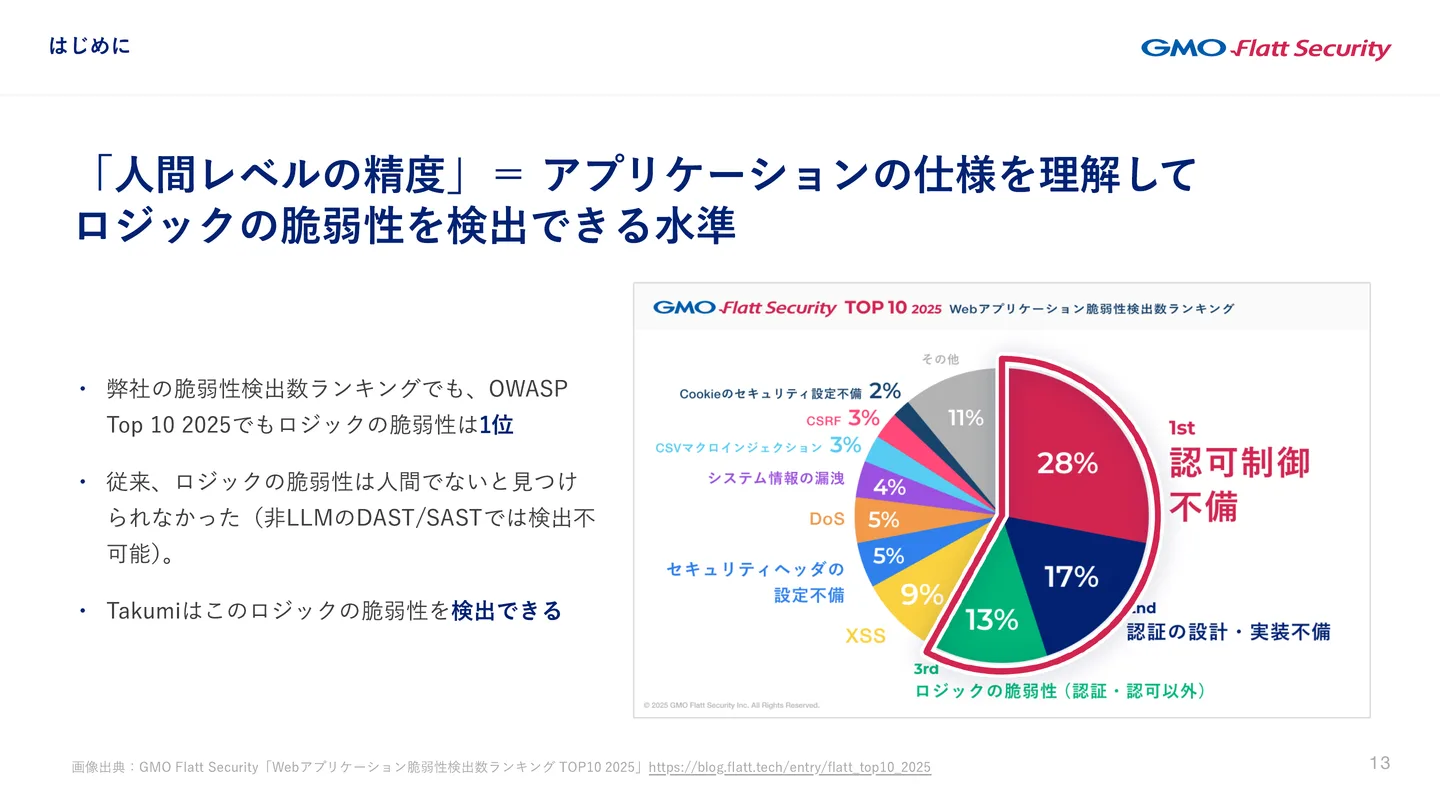
「人間レベルの精度」とは、アプリケーションの仕様を理解して、ロジックの脆弱性を検出できる水準のことです。ロジックの脆弱性は、アプリケーションごとに固有のロジック、つまり仕様によって、リスクになったりならなかったりする脆弱性です。仕様を考えないとリスクを判断できず、見つけることも難しい脆弱性で、認可制御不備もこの中に含まれます。
たとえば、SNS で他のユーザーの情報が見えるのは、ごく自然で正常な動きで、脆弱性でもバグでもありません。ところが、企業向けの SaaS で別のテナント、つまり別の企業の情報が見えたとしたら、本来見えるべきでないものが見えている、かなり深刻な認可制御不備です。起きている現象は同じでも、アプリケーションの仕様によってリスクの有無が変わります。ただし、こうした脆弱性は AI の登場以前は見つけるのが難しく、アプリケーションの仕様を理解した人が判断しなければならない分野でした。AI を使わない DAST・SAST では検出できませんでした。AI は、これを見つけられるようになりました。
これが重要なのは、ロジックの脆弱性が、実際に見つかる脆弱性の多くを占めるからです。弊社が診断で検出した脆弱性をまとめた「Webアプリケーション脆弱性検出数ランキング TOP10 2025」では、1位が認可制御不備で、28%を占めます。認可制御不備、認証の不備、その他のロジックの脆弱性の3つを合わせると、6割ほどになります。つまり、こうした脆弱性を潰せれば、大まかに言えばリスクの6割を潰せます。特に認可制御不備をいかに潰すかは、現代のアプリケーションで非常に重要な点です。
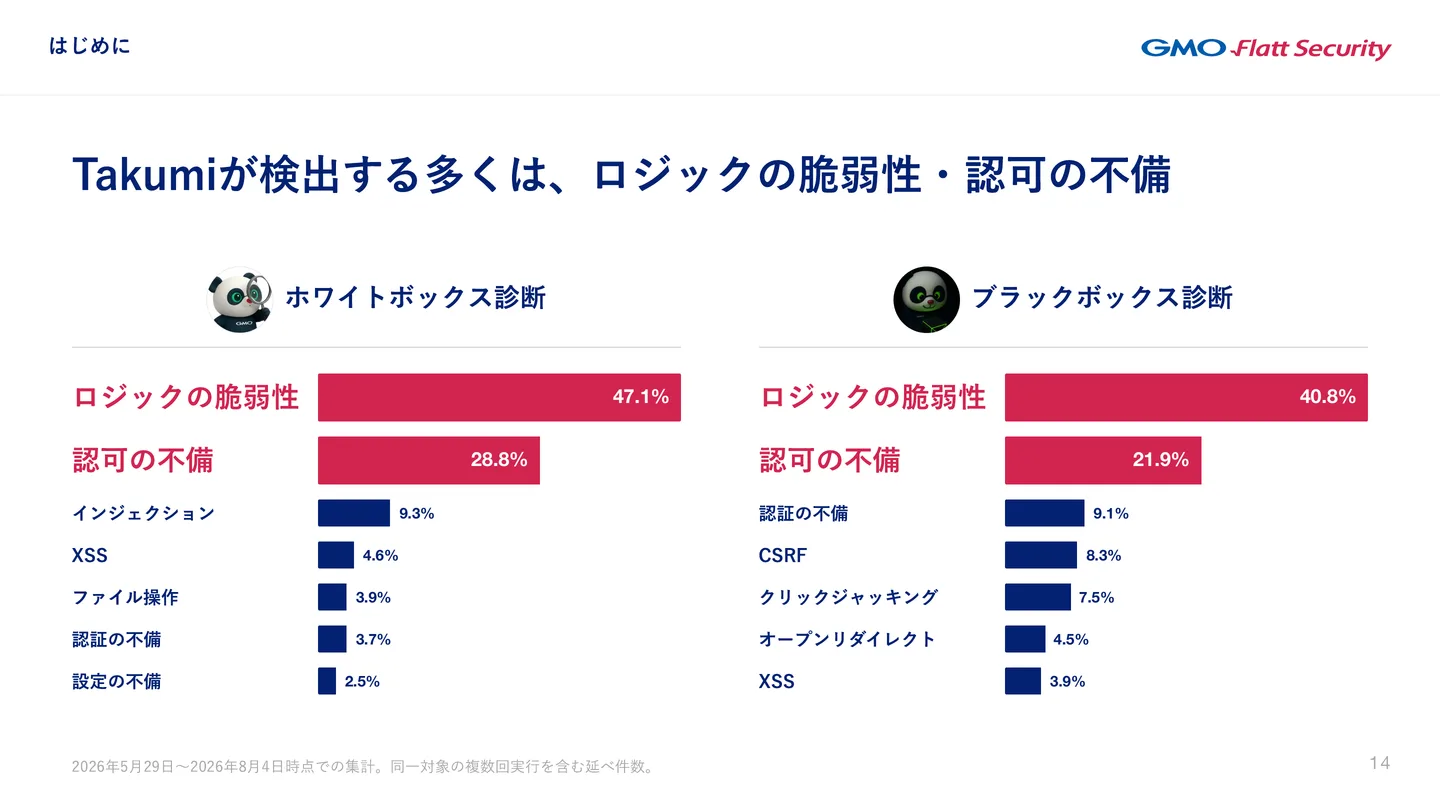
Takumi は、このロジックの脆弱性を見つけられます。Takumi が検出した脆弱性の内訳では、ホワイトボックス診断では認可制御不備を除くロジックの脆弱性が47.1%、認可制御不備が28.8%、ブラックボックス診断では同じく40.8%と21.9%で、どちらの手法でも、この2つが1位と2位を占めています(2026年5月29日〜8月4日の集計。同じ対象の複数回の実行を含む延べ件数)。AI がロジックの脆弱性を見つけられることは、数字で見ても、かなり現実的な話です。
Takumi の主な機能
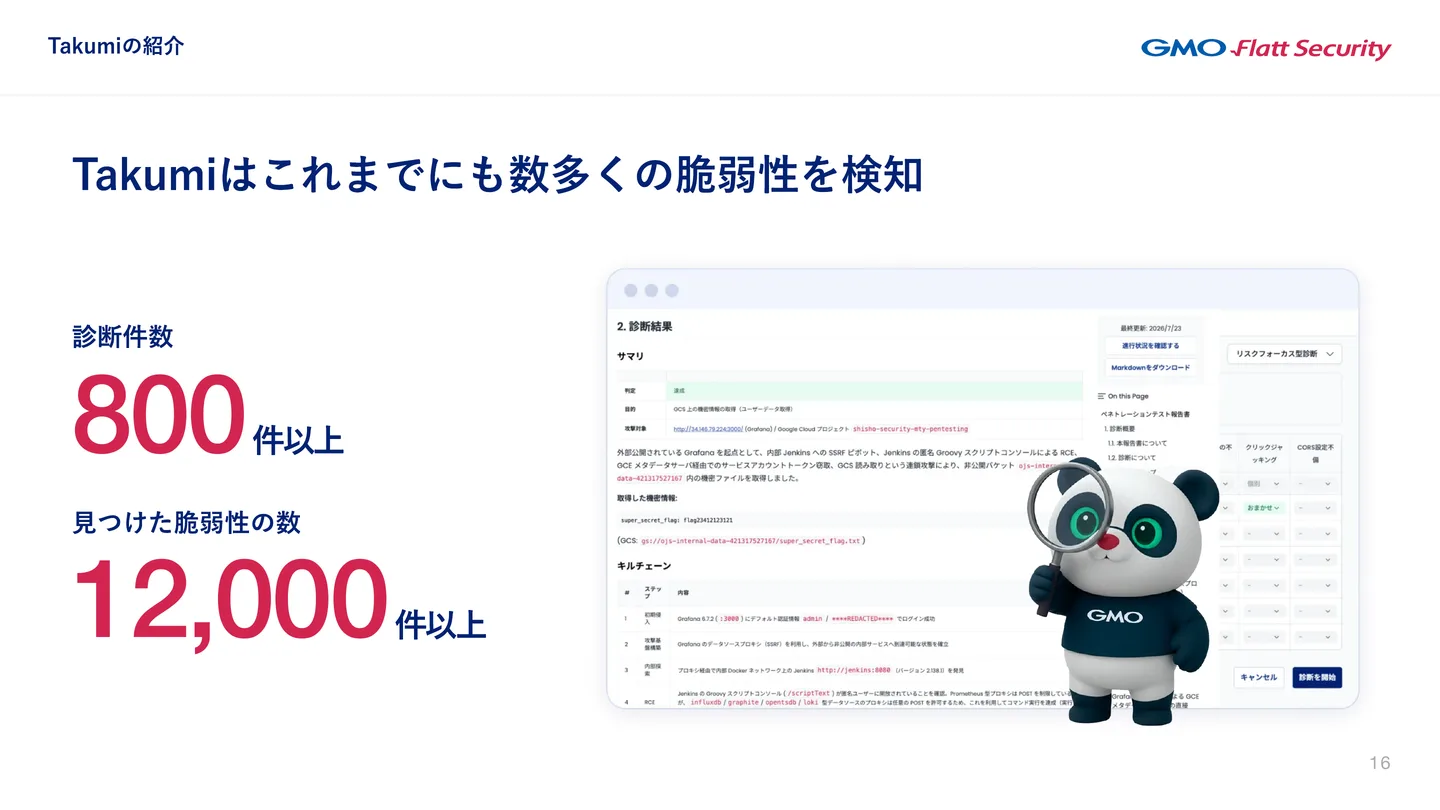
Takumi は、2025年3月から脆弱性診断の機能を提供しています。2025年2月ごろに Claude 3.7 Sonnet が出たとき、AI のモデルが脆弱性を見つける能力がここまで進化したのかと衝撃を受けて開発を始め、翌月にリリースしました。以来1年半ほどのサービス提供の蓄積があり、診断の件数は800件以上、見つけた脆弱性は12,000件以上です。
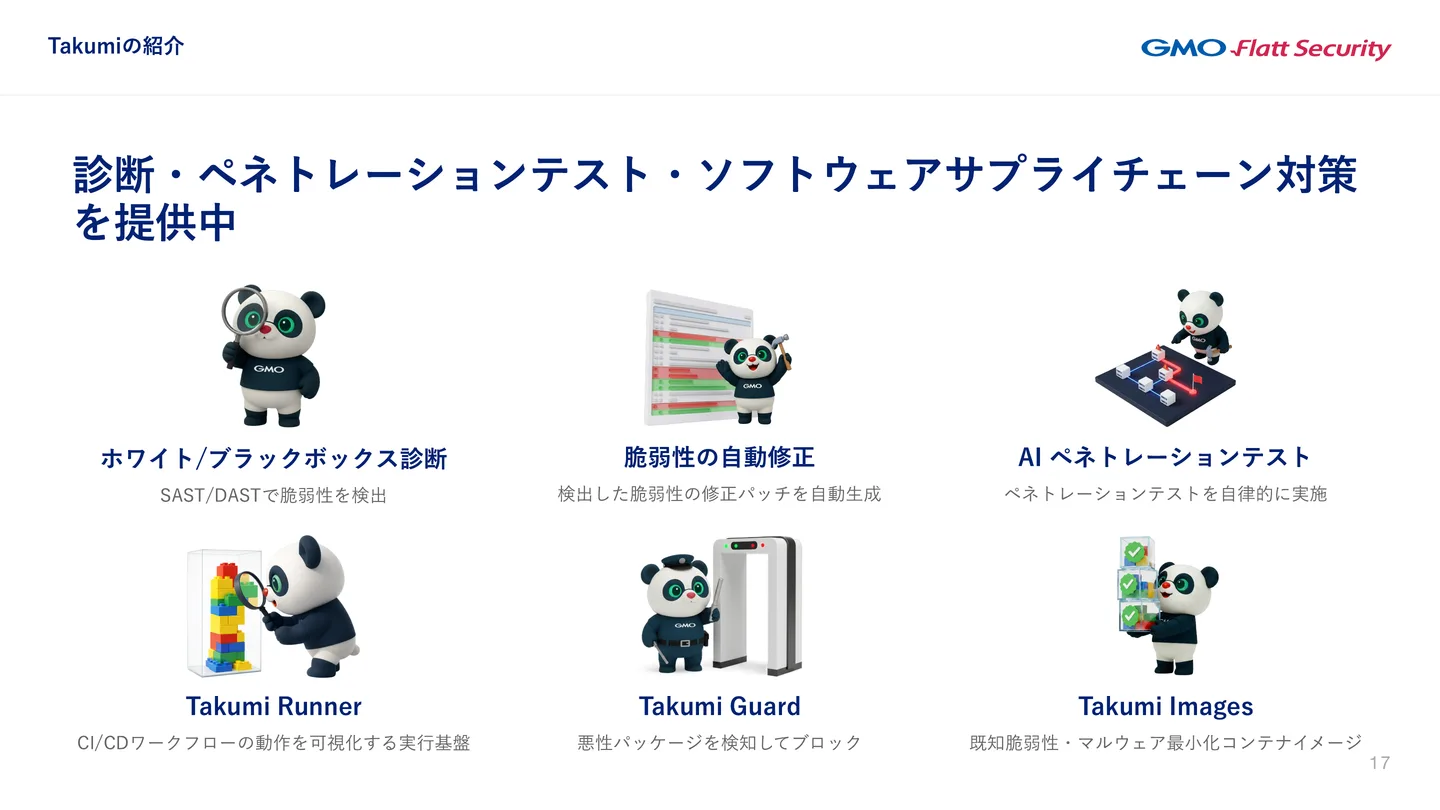
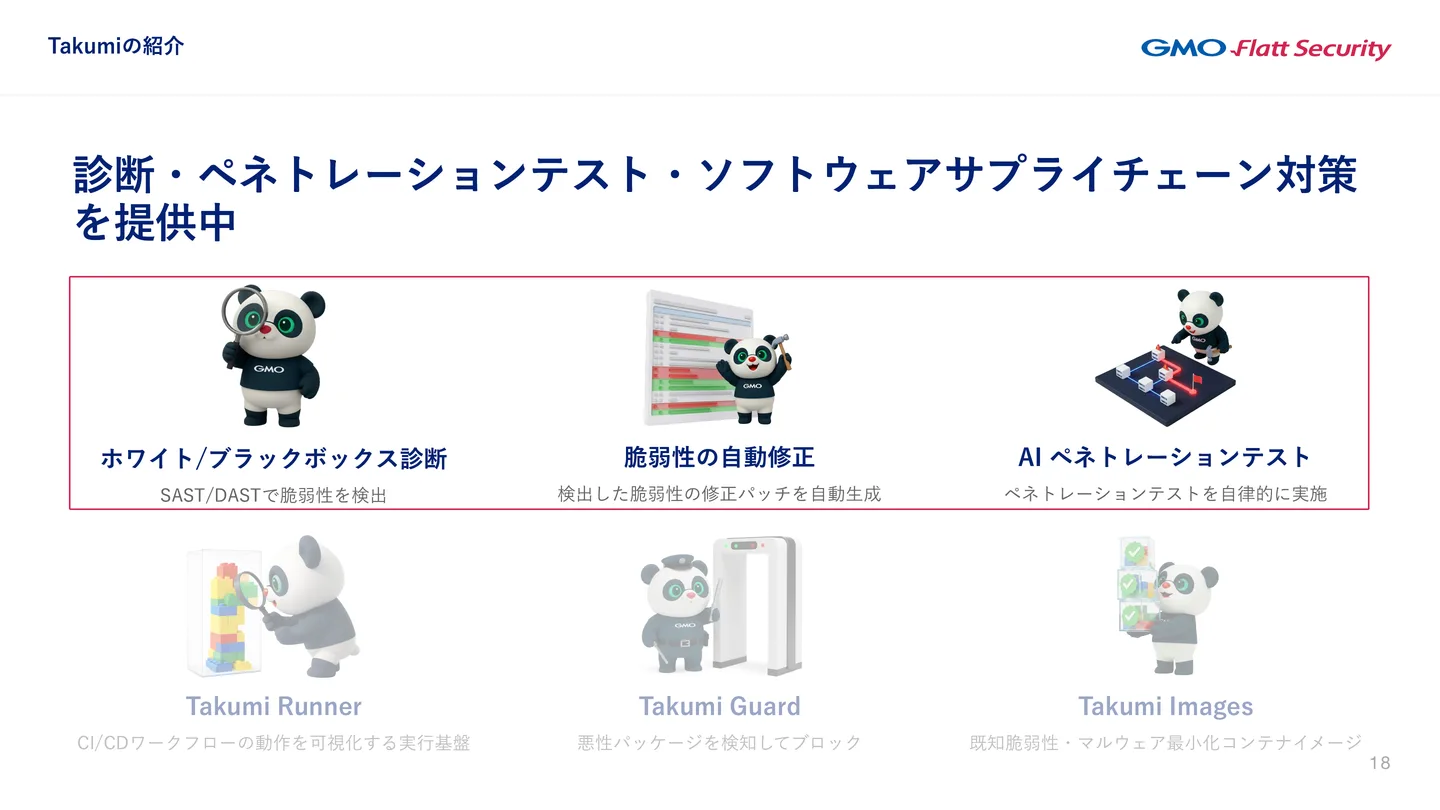
Takumi の機能は、大きく6つに分かれます。ホワイトボックス・ブラックボックスの脆弱性診断、脆弱性の自動修正、AI ペネトレーションテストの3つは、いわゆるオフェンシブセキュリティの分野の機能です。残りの3つ、CI/CD ワークフローの動作を可視化する実行基盤の Takumi Runner、悪性パッケージを検知してブロックする Takumi Guard、既知の脆弱性とマルウェアを最小化したコンテナイメージの Takumi Images は、ソフトウェアサプライチェーン対策の機能です。
ホワイトボックス診断・ブラックボックス診断から自動修正まで対応する
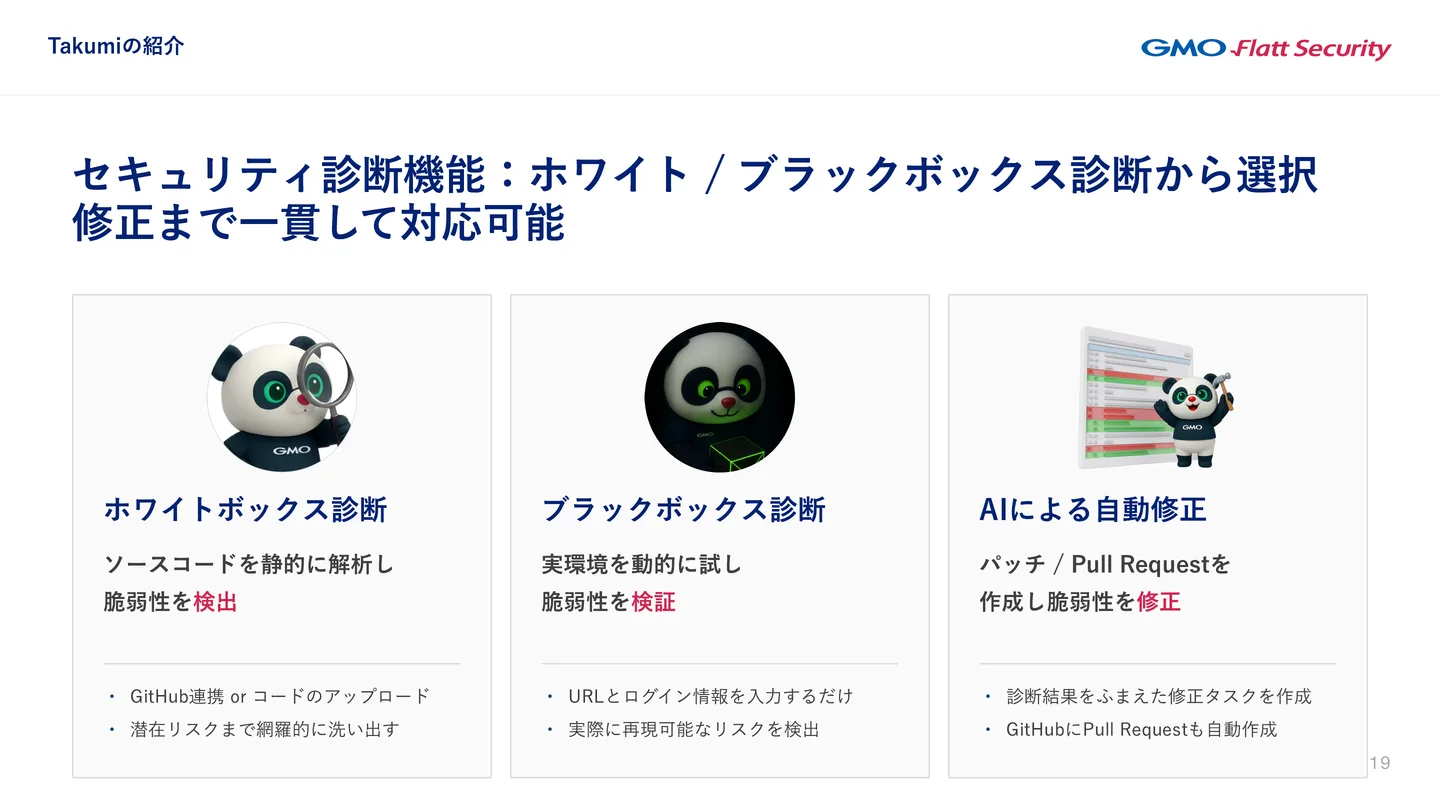
- ホワイトボックス診断: ソースコードを静的に解析して、脆弱性を見つけます。AI 以前の時代に SAST と呼ばれていたツールと同じ役割を、AI が担います。GitHub との連携か、コードのアップロードで始められ、潜在的なリスクまで網羅的に洗い出せます。
- ブラックボックス診断: ステージングなどのデモ環境の URL を起点に、実際にアプリケーションを動かしながら動的に検証します。URL とログイン情報を入れるだけで始められ、実際に再現できるリスクを検出します。
- AI による自動修正: 見つけた脆弱性のパッチまで書きます。診断の結果をふまえた修正のタスクを作り、GitHub と連携していれば Pull Request まで自動で作ります。
グレーボックス診断はソースコードで見つけた脆弱性を実環境で検証する
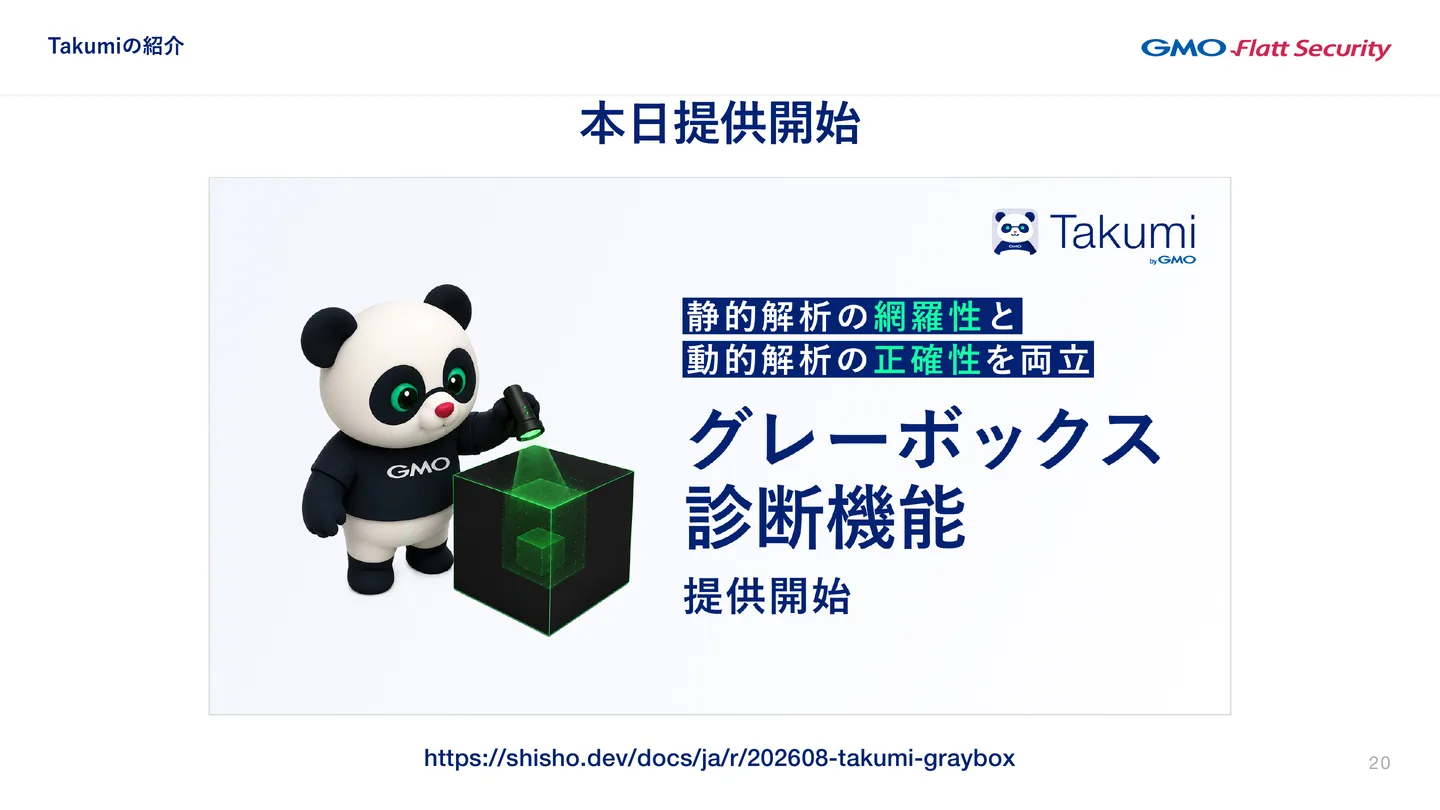
弊社は、2026年8月18日に、グレーボックス診断の提供を始めました(リリースノート)。ホワイトボックス診断の後に、ブラックボックス診断を実施するものです。
ホワイトボックス診断は、ソースコードから脆弱性を見つけるので、潜在的なものまで網羅的に検出できるのが利点ですが、見つけすぎてしまい、時には誤検知が多くなってしまうといった欠点があります。ブラックボックス診断は、与えられた環境で実際に効くものを見つける手法なので、ホワイトボックス診断ほど網羅的ではないものの、誤検知を減らしやすい利点があります。この2つを組み合わせ、ホワイトボックス診断で網羅的に見つけた後に、ブラックボックス診断で検証するのがグレーボックス診断です。
AI ペネトレーションテストは設定したゴールの達成に向けて自律的に侵入を試みる
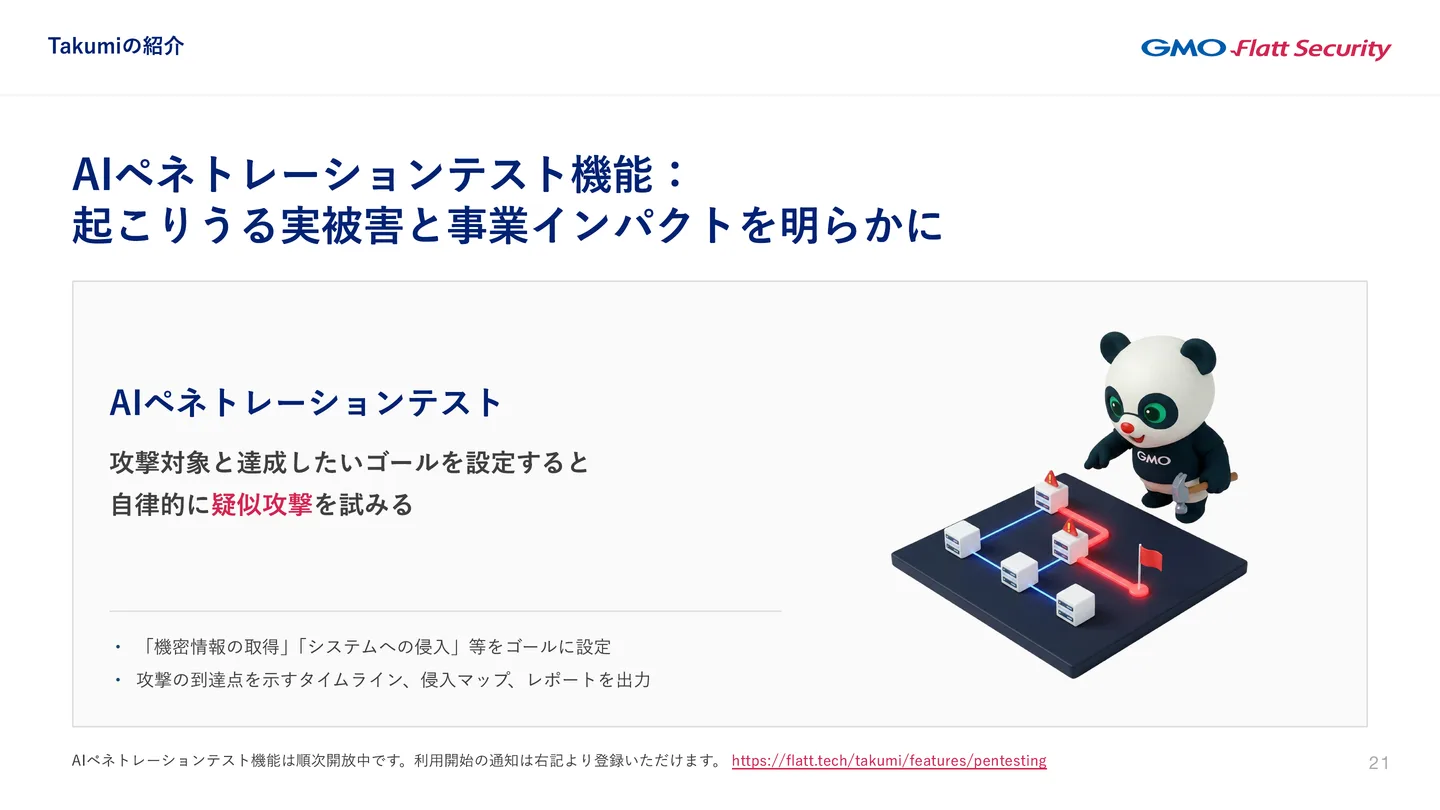
AI ペネトレーションテストは、脆弱性診断のようにマトリックスのマスをすべて確かめることは目標にしません。「機密情報の取得」「システムへの侵入」のように、情報を盗み取れるか、特権を奪取できるかといったゴールを設定すると、そこへ向かって自律的に疑似攻撃を試みる機能です。攻撃の到達点を示すタイムライン、侵入マップ、レポートを出力します。
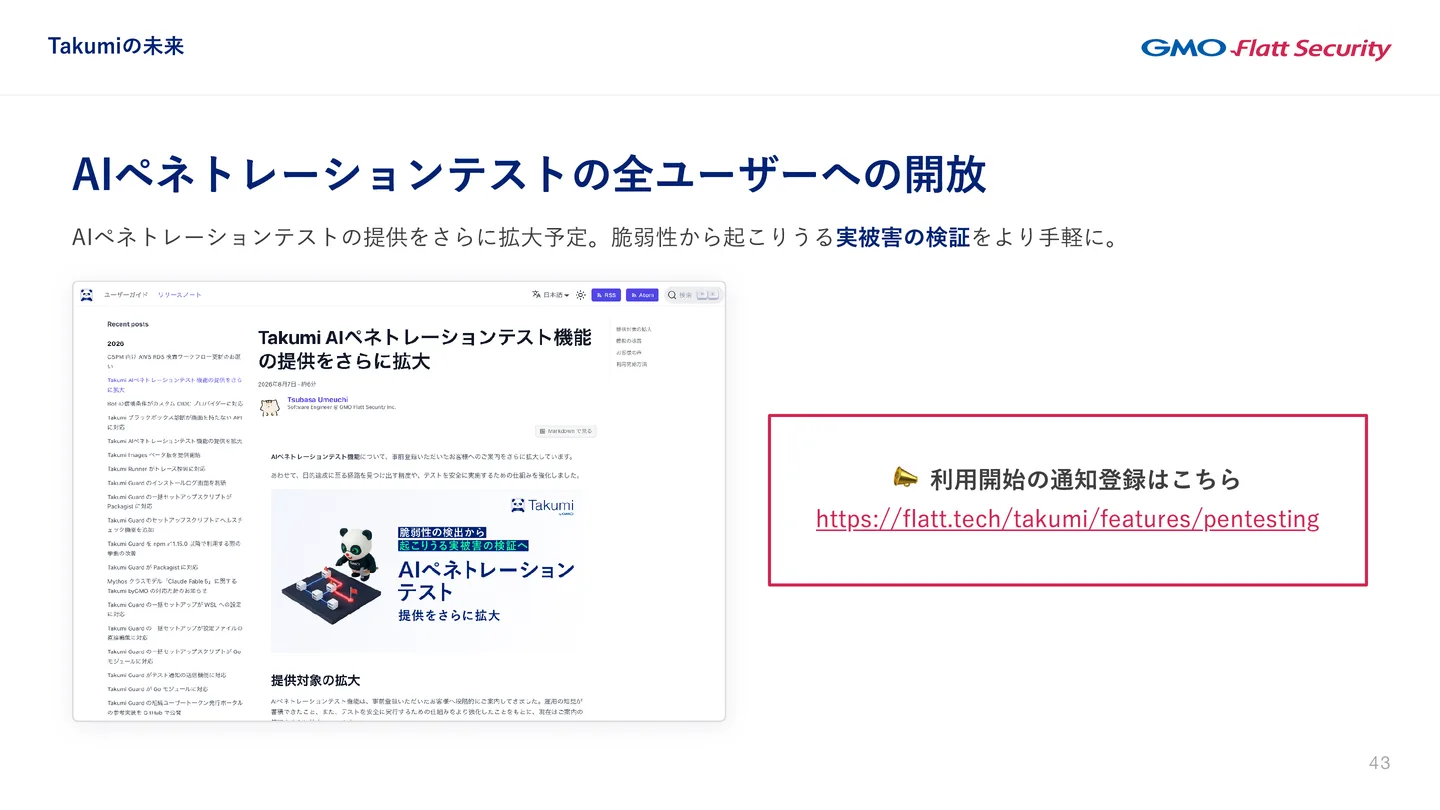
破壊力のある機能なので、弊社は少しずつお客様への開放を進めていて、すべての利用者への開放を目指しています。
注: 2026年10月7日から、AI ペネトレーションテストはすべての組織で、事前の申し込みなしに使えるようになりました。
Takumi の運用
Takumi の3つの使い方は全体診断・複数製品の順次診断・週次診断
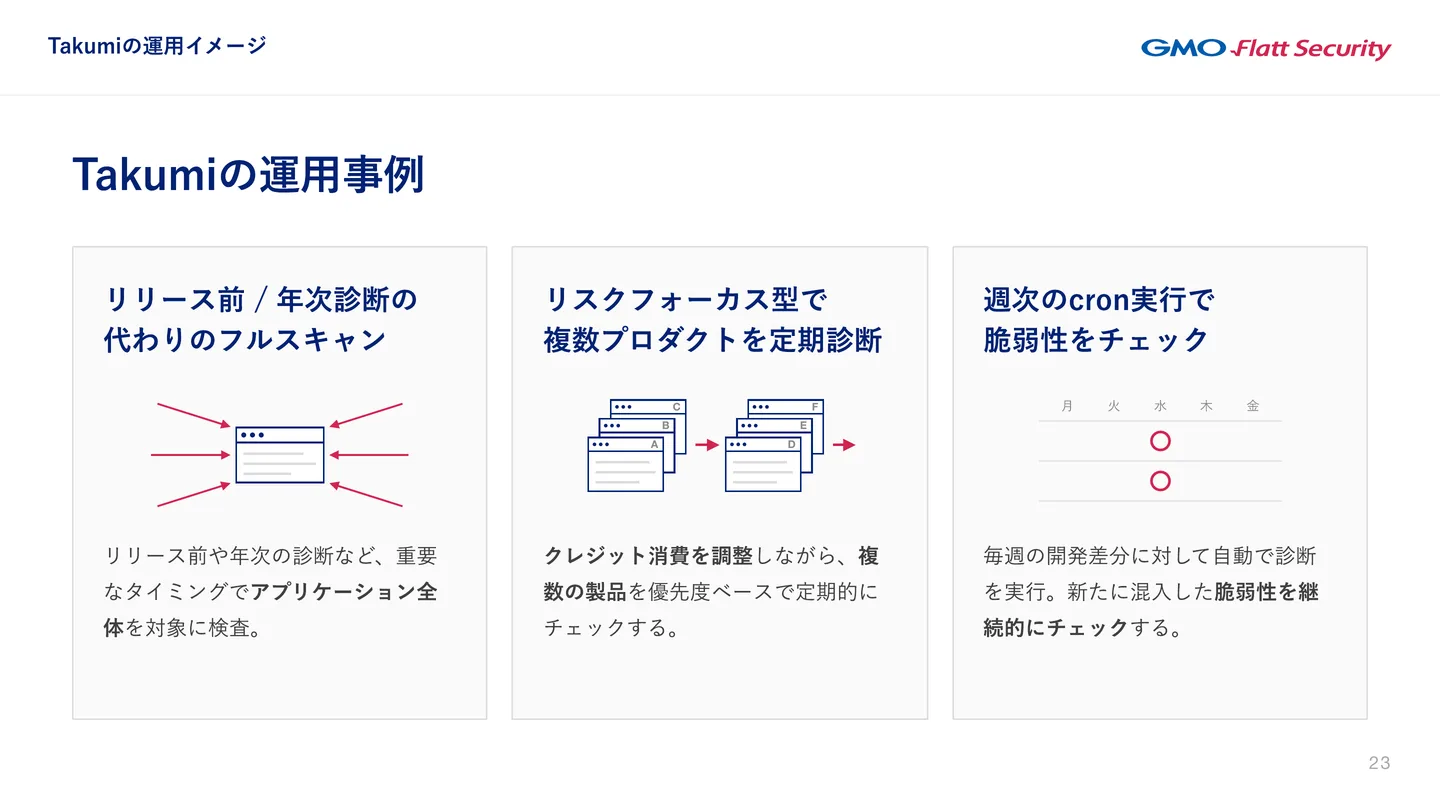
Takumi では、診断などを実行するたびに、クレジットというポイントを消費します。消費量は、どれだけ重い検査をしたかによって決まります。利用者が Takumi を実際にどう使っているかには、大きく3つの型があります。
- リリース前・年次の診断の代わりのフルスキャン: 製品のリリース前や、これまで年に1回行っていた脆弱性診断の代わりに、すべての機能とエンドポイントを対象に検査します。クレジットは多めにかかりますが、外部のベンダーに委託するのと比べれば経済的なので、年に1回ではなく四半期に1回、小規模なものなら毎月といった頻度で全体を見ることもできます。従来の脆弱性診断に当たる検査を、代替する使い方です。
- 消費の上限を決めて、複数の製品を順に診断: おそらく最も多い使い方です。クレジットは、放っておくと消費が大きくなり、年間や月間の予算と釣り合いを取るのが難しくなります。そこで、クレジットの消費の上限を決めて診断すれば、1つの製品の診断で多くのクレジットを使ってしまい、ほかの製品を見られなくなる、ということを防げます。こうしてクレジットを調整しながら、複数の製品の診断をうまくローテーションで回しているお客様が多いと見ています。
- 週次の cron 実行で、脆弱性をチェック: クレジットに余裕がある場合や、この製品は必ず定期的に見たいと決まっている場合は、cron のように実行の日時を設定できます。たとえば開発の定例が水曜日なら、火曜日の夜に診断を回しておき、水曜日の定例には必ず報告が上がってくるようにする、といった動きを決めておけます。毎週の開発の差分に新たに混入した脆弱性を、継続的にチェックできます。
弊社自身も、自社の製品に Takumi の診断を高い頻度で回しています。セキュリティ製品を作る立場として、品質にこだわらなければならないためです。
ソースコードと実環境がそろえばグレーボックス診断を選ぶ
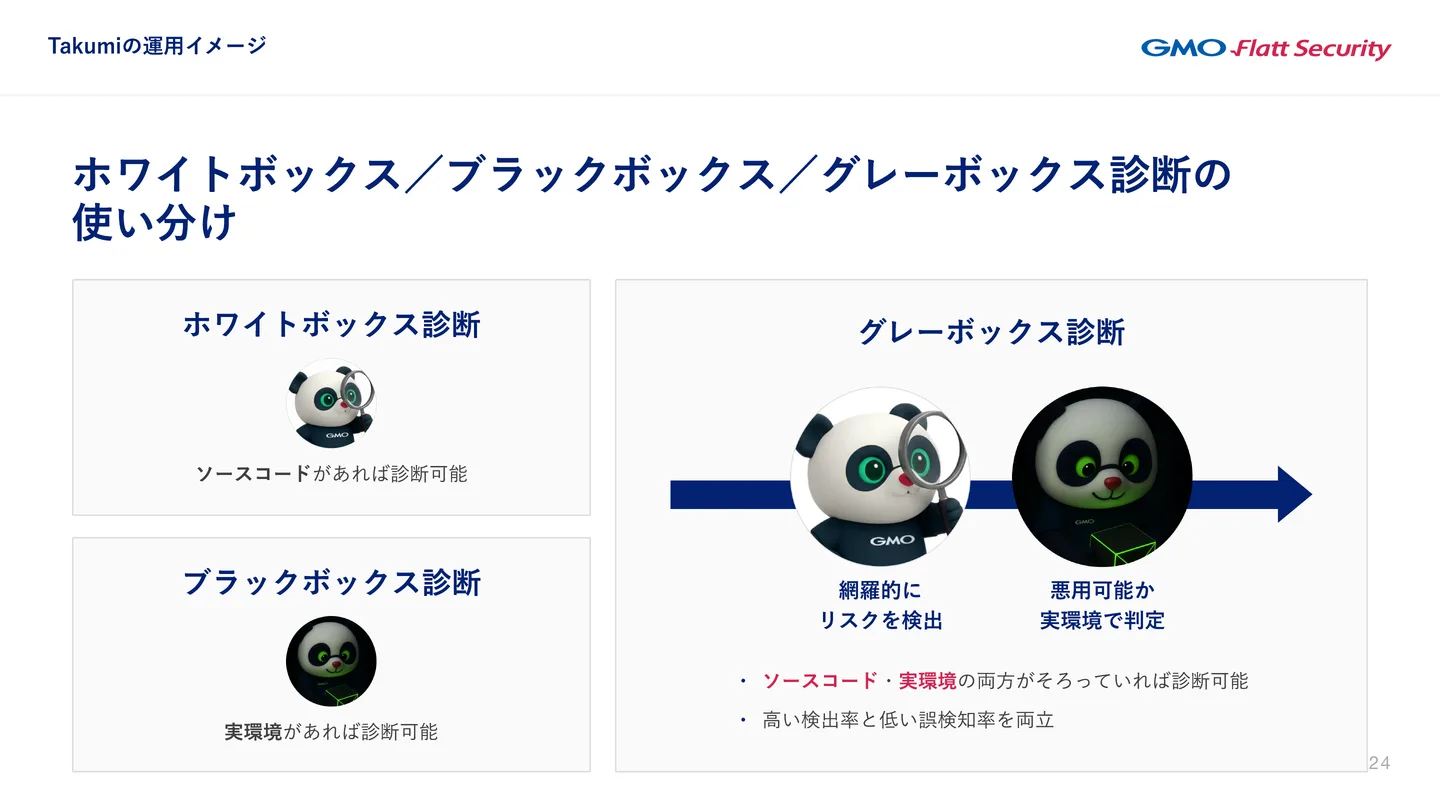
ソースコードと実環境の両方がそろっていれば、グレーボックス診断をおすすめします。見つけた脆弱性が本当に悪用できるもの、つまり優先度の高い脆弱性かどうかを実際の環境で判定できるので、高い検出率と低い誤検知率を両立できます。
ブラックボックス診断は攻撃に近い行為で、本番環境が落ちてしまう可能性も否めず、ノイズのデータが入ることもあるので、本番環境での実施は基本的におすすめしていません。そのため、グレーボックス診断にはソースコードとデモ環境の両方が要ります。片方しかない会社でも、ソースコードだけならホワイトボックス診断、実環境だけならブラックボックス診断を選べます。
クロールで診断対象を洗い出し、リスクフォーカスで予算内の優先順位を決める
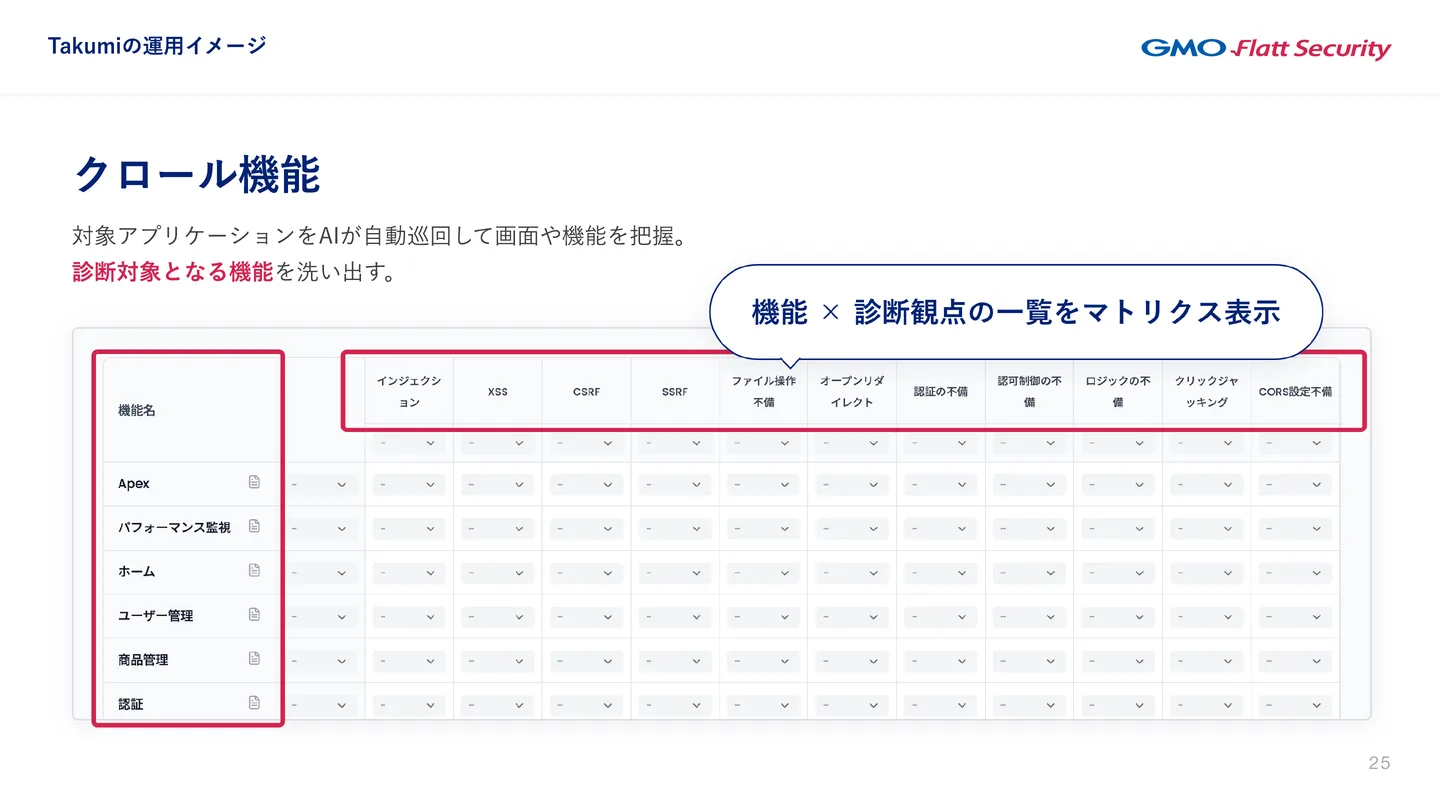
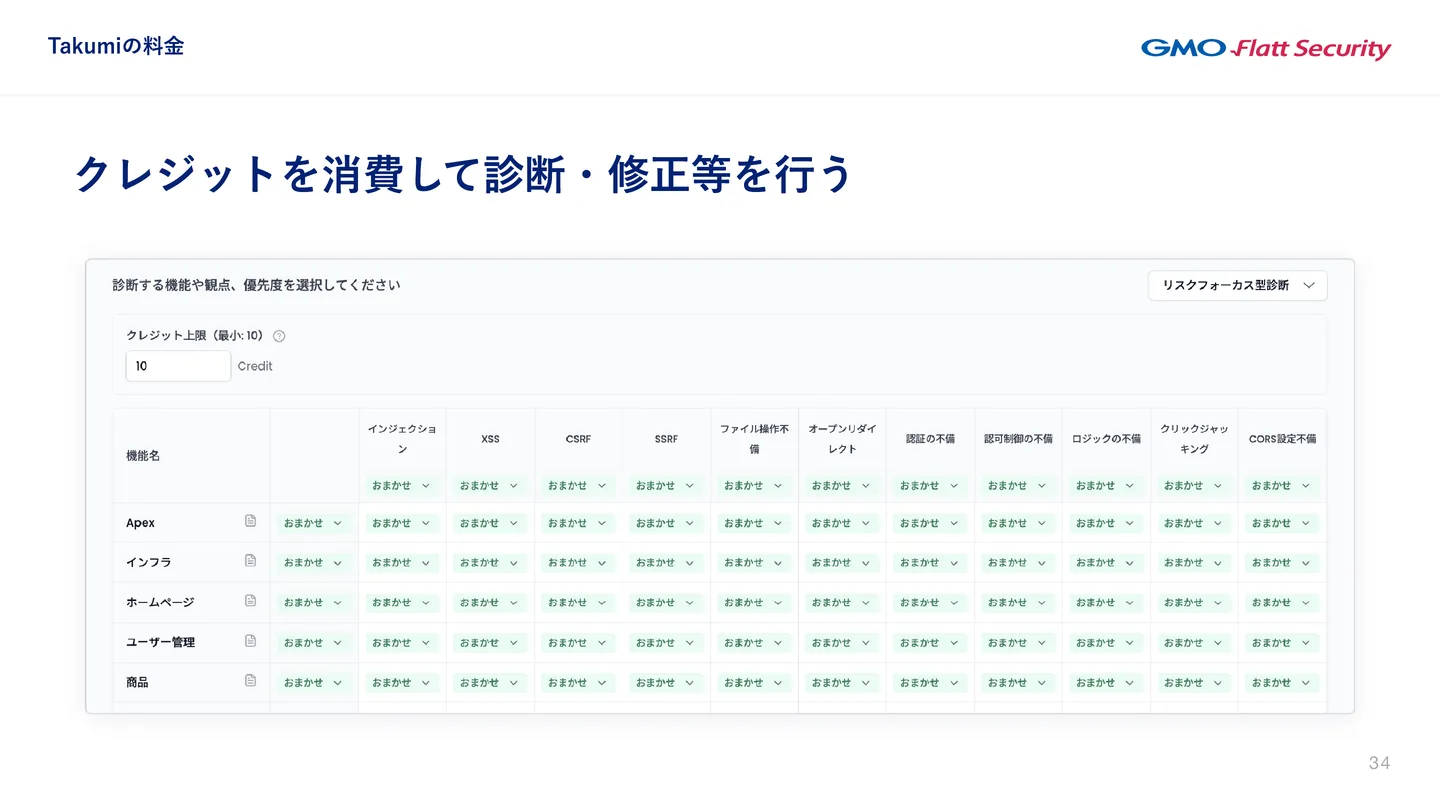
Takumi の診断を支える機能が2つあります。1つ目はクロール機能です。クロールは、脆弱性診断を発注したことがある方にはなじみのある概念で、診断の対象を洗い出すことです。古くは人が行っていて、ブラウザで対象のアプリケーションを操作し、このボタンを押すとこの API に通信が送られ、この画面に遷移する、といったことを手作業で洗い出していました。現在はこれを AI がしっかりと行います。Takumi は、対象のアプリケーションを自動で巡回して画面や機能を把握し、アプリケーション全体の機能の一覧と診断の観点を掛け合わせたマトリックスを生成します。
診断してほしくない機能は、スコープの URL やファイルの範囲を指定して、クロールと診断の対象から除外できます。ペネトレーションテスト機能で間違って本番環境に行ってしまわないか、という心配の声をいただくこともありますが、診断でもペネトレーションテストでも、こうした設定ができます。
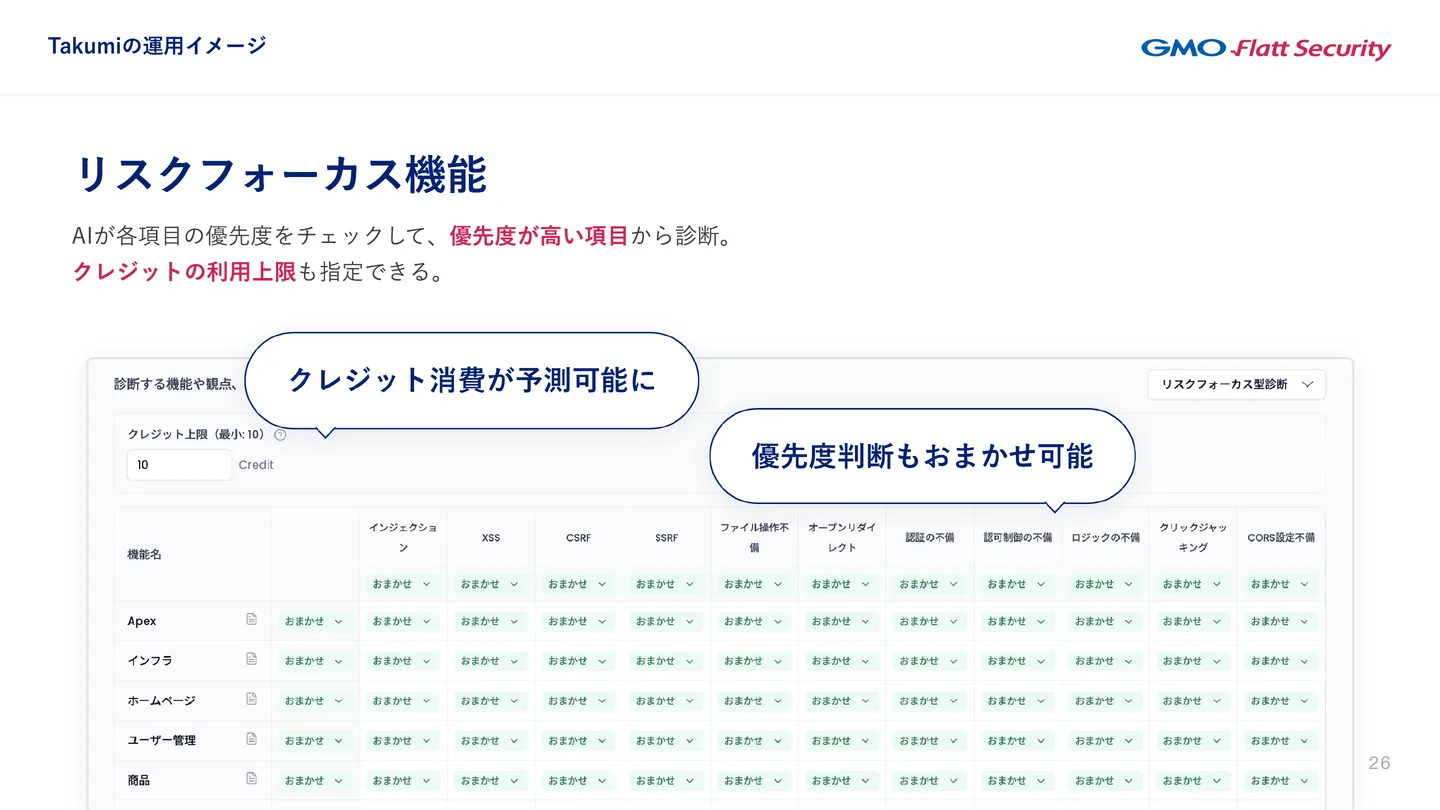
2つ目はリスクフォーカス機能です。弊社の造語で、限られた予算、限られたクレジットの中で、事業への影響が大きく、リスクの高い脆弱性から優先的に見ていくことを指します。予算に上限があることを前提にした機能です。本来の脆弱性診断がそうであるように、クレジットに余裕があればマトリックスをすべて確かめたほうがよいのですが、現実には予算に制約があります。そこで、限られた予算の中で最も成果を出せるよう、Takumi が各項目の優先度を判断し、今回使うクレジットの中でどこから見ていくべきかを決めます。基本的には、すべての項目を Takumi に任せる運用で問題ありません。特に見てほしい機能があれば、その項目の優先度を高く指定して、Takumi の判断を変えることもできます。
診断対象・クレジット上限・優先項目を設定し、報告書で結果を確認する
診断の作り方は、ホワイトボックス診断もブラックボックス診断も基本的に同じです。
- 診断の作成: 診断の名称を決め、ホワイトボックス・ブラックボックス・グレーボックスの3つから手法を選びます。次に診断のタイプを「一部だけ診断」と「全体を診断」から選びます。「一部だけ診断」は、まずクロールだけを終わらせ、その結果を見てからどう診断していくかを人が調整したいときや、一応確認しておきたいときに使います。「全体を診断」は、クロールの後も止まらずに診断まで進みます。介入したい理由が特になければ、「全体を診断」で任せてしまって構いません。
- ホワイトボックス診断の設定: ソースコードを、GitHub のリポジトリとの連携か、ZIP ファイルのアップロードで渡します。診断の範囲から除外する設定(ファイルスコープ)も指定できます。
- ブラックボックス診断の設定: 診断の対象を Web アプリケーションか API から選び、対象の URL を入れます。この手軽さがブラックボックス診断の利点です。URL のスコープも指定できます。認証のあるアプリケーションでは、ログイン情報を Takumi に渡すことがほぼ必須です。認証に重大な脆弱性がない限り、ログイン情報がなければログイン後の画面はまったく見られないためです。2要素認証のあるアプリケーションのログインにも対応しています。ほかに、参考のファイルなどを任意で追加できます。
- ネイティブアプリ: バックエンドの API は、ブラックボックス診断で対象に API を選べば診断できます。クライアント側は、ホワイトボックス診断でソースコードをアップロードするか、GitHub のリポジトリを連携して診断します。バックエンドはホワイトボックス診断でもブラックボックス診断でも診断できます。
- クレジットの消費の上限: 診断ごとに、消費するクレジットの上限を入力できます。基本プランでは毎月250クレジットが付与されるので、月7万円に抑えたい方はこの250クレジットをどうやりくりするかを考える必要があり、そこで重要になるのがこの上限です。たとえば今月あと8つの製品を見なければならないなら、1回の診断を30クレジットほどに抑えておくのがおすすめです。以前はこの機能がなく、利用者の苦労の声を受けて弊社が力を入れて開発した部分です。
- クロールの後の画面: 機能と観点のマトリックスが生成されます。ユーザー管理や認証は特に見てほしい、というときは、ここで優先度を高く指定します。
- 診断の後の画面: ホワイトボックス診断でもブラックボックス診断でも、かなり似た見た目で、「アプリケーション診断報告書」という、いわゆる脆弱性診断のレポートの形式そのものの画面が出ます。検査の項目、診断の対象のエンドポイント、全体の評価、指摘事項の一覧がまず要約として出て、その後に各指摘事項の詳細として、脆弱性の説明、再現の手順、リスクが続きます。ホワイトボックス診断のレポートには、ソースコードの引用もあります。人が介在せずに生成されるもので、これを読んで対策するだけで脆弱性を十分に直せる内容になっていると考えています。PDF のレポートをそのまま発行したり、Markdown でダウンロードしたりできます。
- 自動修正: レポートに含まれる脆弱性の一覧から修正するものを選んでタスクを作成すると、AI に与えるプロンプトが生成され、Takumi が修正のパッチを作ります。GitHub と連携していれば、そのまま Pull Request まで出すので、あとは人がそれを確認してマージするだけです。
人が決めるのは、対象の渡し方と、クレジットの上限と、優先して見てほしい機能までです。そこから先の診断と報告書の作成は、人が介在せずに Takumi が進めます。修正のパッチも、直す脆弱性を選べば Takumi が作ります。
時間をかけるからこそ高い精度の診断ができる
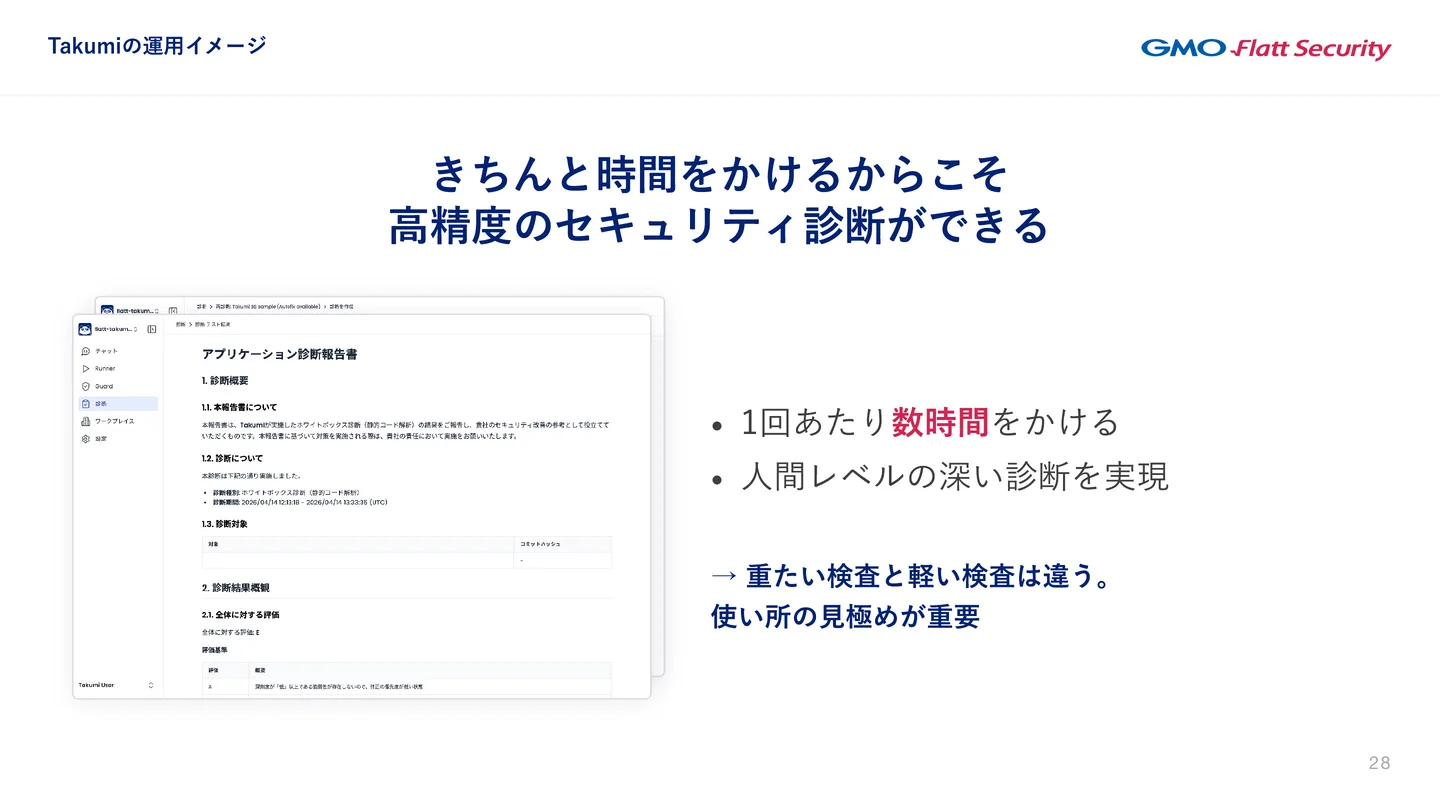
Takumi の診断について見落とされやすいのは、1回の診断に時間がかかる点です。Takumi の診断は、1回あたり数時間、長いと1日以上かかります。これを短いと感じるか長いと感じるかは、これまでの診断の経験によるでしょうが、ほかの AI のツールと比べても比較的長く、10分や20分、30分で完了するものではありません。
時間をかけるのは、そのほうが高い精度のセキュリティ診断ができるからです。弊社が Takumi を作り始めたときから一貫して考えているのは、人間レベルの脆弱性診断を代替することです。そのためには、重い検査が確実に必要でした。Takumi は、この重い検査を実現するものです。重い検査と軽い検査は別物で、使いどころの見極めが重要になります。
Takumi はリリース前の検査に組み込む
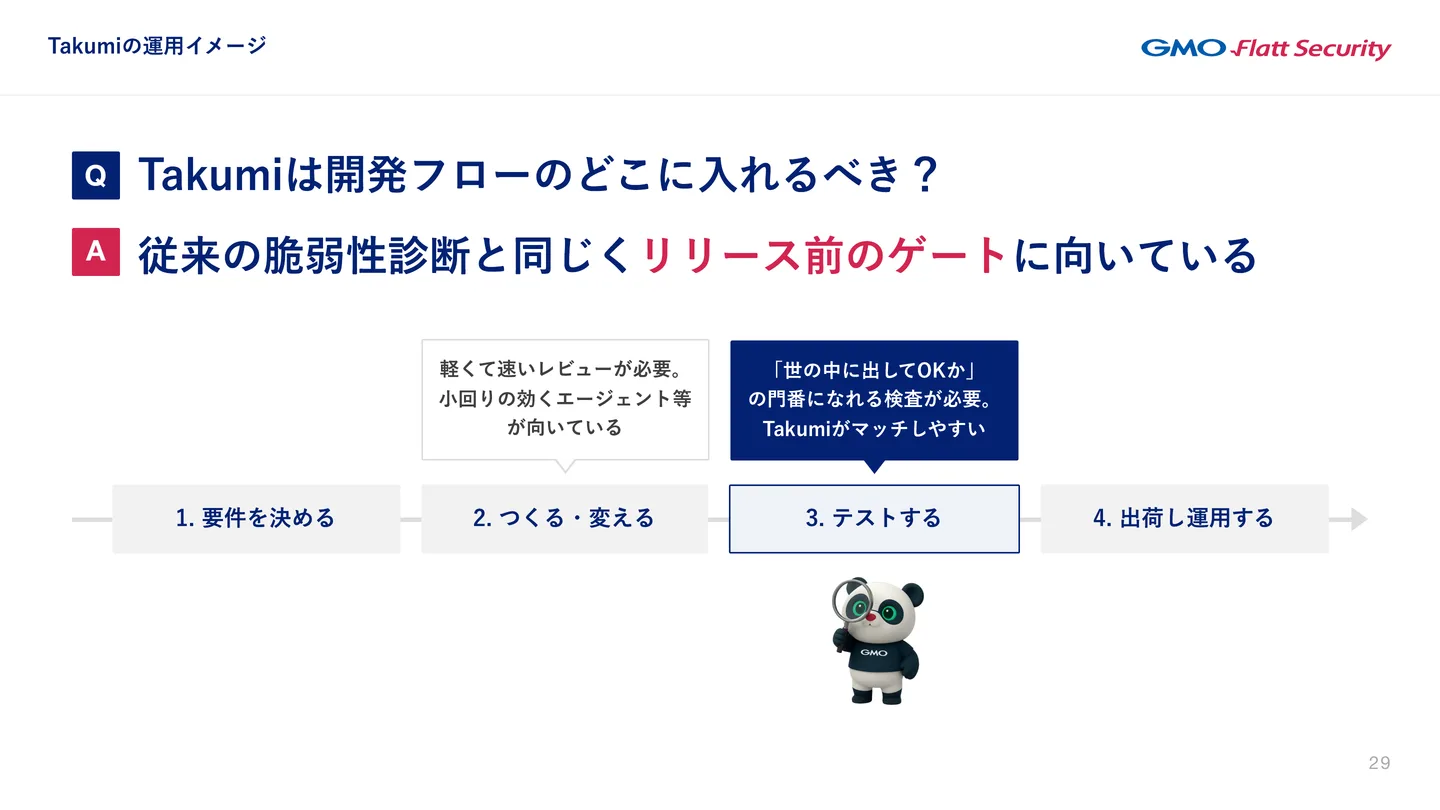
Takumi のような自動の検知ツールを DevSecOps に組み込みたいので、CI のテストの中に入れるのがよいか、という相談をよくいただきます。場合によりますが、弊社はおすすめしないことのほうが多いです。CI での検査、つまりプルリクエスト単位のセキュリティチェックは、本来、重い検査を組み込むものではありません。重い検査を入れた結果、ブランチがなかなかマージできず、運用が形骸化してしまうのは、最も避けなければならない事態です。AI 以前の時代にも、人が行う診断を CI に組み込むことはありませんでした。Takumi の検査も人間レベルの検査なので、CI でプルリクエスト単位に回すのではなく、1週間分のデプロイの差分をまとめて見る、リリース前にフルスキャンする、といった段階に位置づけるものです。こうした段階に置くので、数時間や1日に相当する時間をかけた検査ができます。
開発の流れで言えば、「つくる・変える」段階に要るのは軽くて速いレビューで、小回りの効くコーディングエージェントなどが向いています。Takumi が合うのは、従来の脆弱性診断と同じく、「世の中に出してよいか」を判断する検査が要る「テストする」段階、つまりリリース前のゲートです。
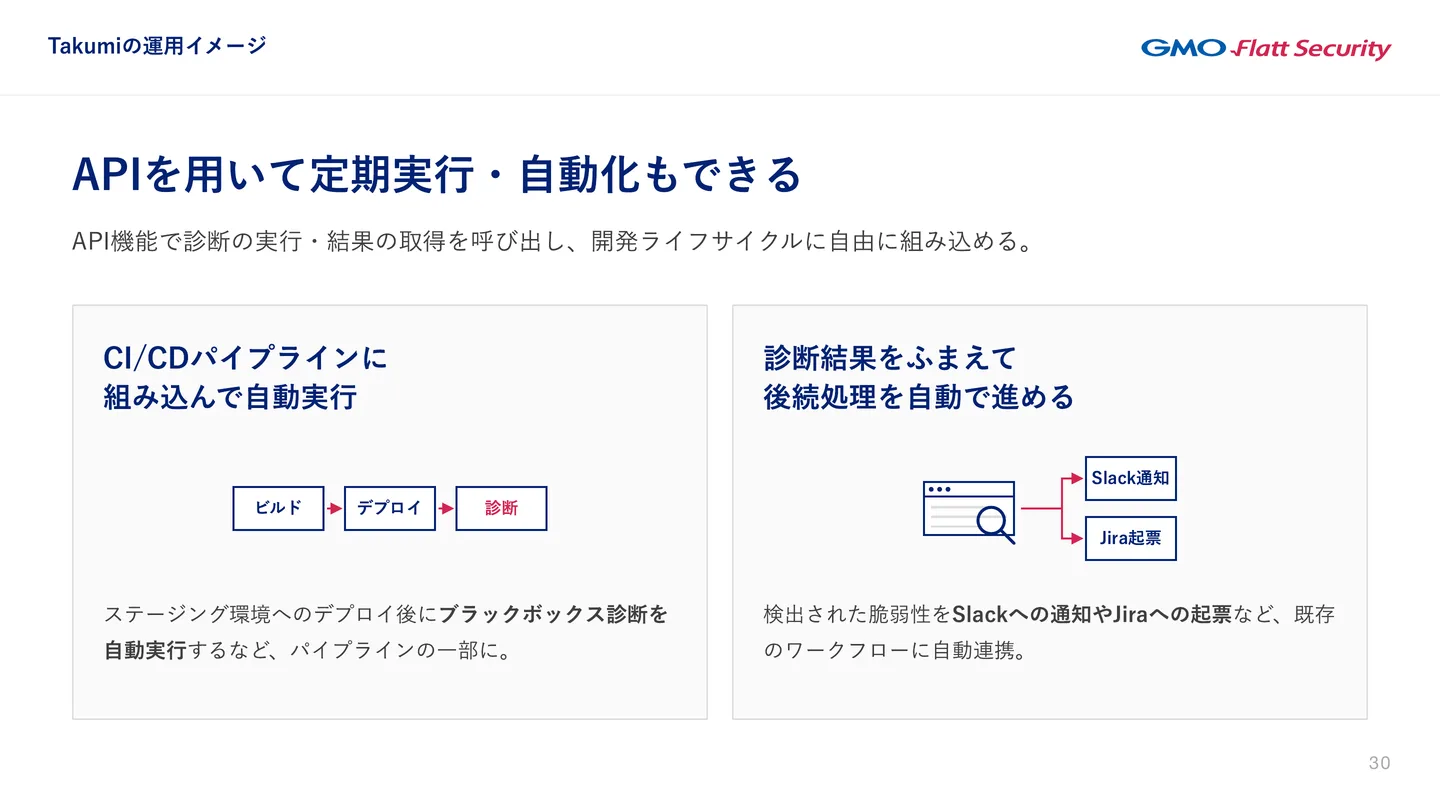
CI には多くの場合合いませんが、CD では少し違った面が見えてきます。Takumi は API を提供していて、診断の実行と結果の取得を呼び出せるので、自動化ができます。ステージング環境へのデプロイの完了をきっかけにブラックボックス診断を走らせる、というのは1つのやり方です。検出された脆弱性を Slack に通知する、Jira に起票するといった後続の処理も、API を使って自由にカスタムでき、開発のライフサイクルに組み込めます。
料金とクレジットの考え方
基本プランは月7万円・250クレジットで追加分は1クレジット280円
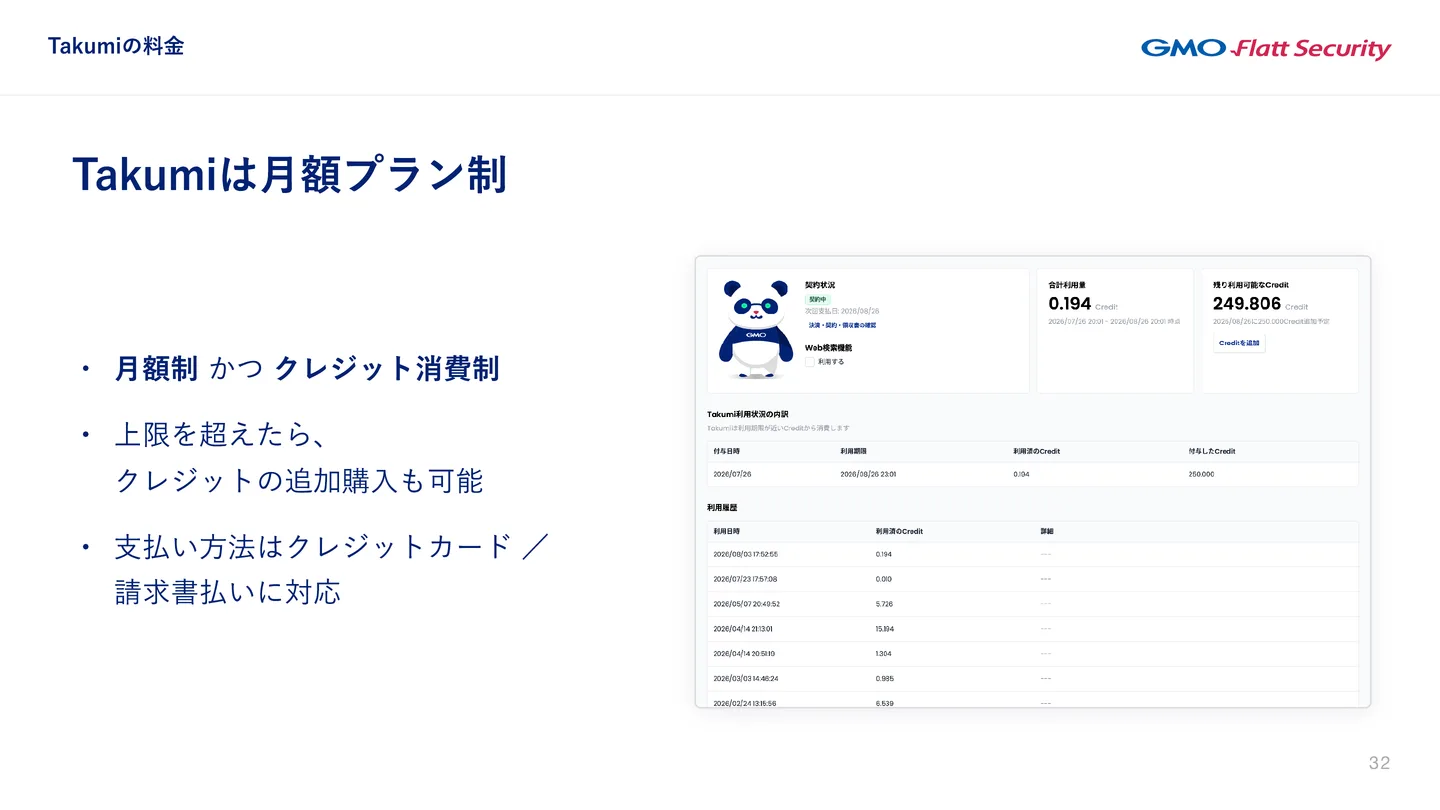
Takumi は、月額プラン制で、かつクレジットを消費する料金体系です。支払いはクレジットカードが基本で、請求書払いは一部にとどまっています。
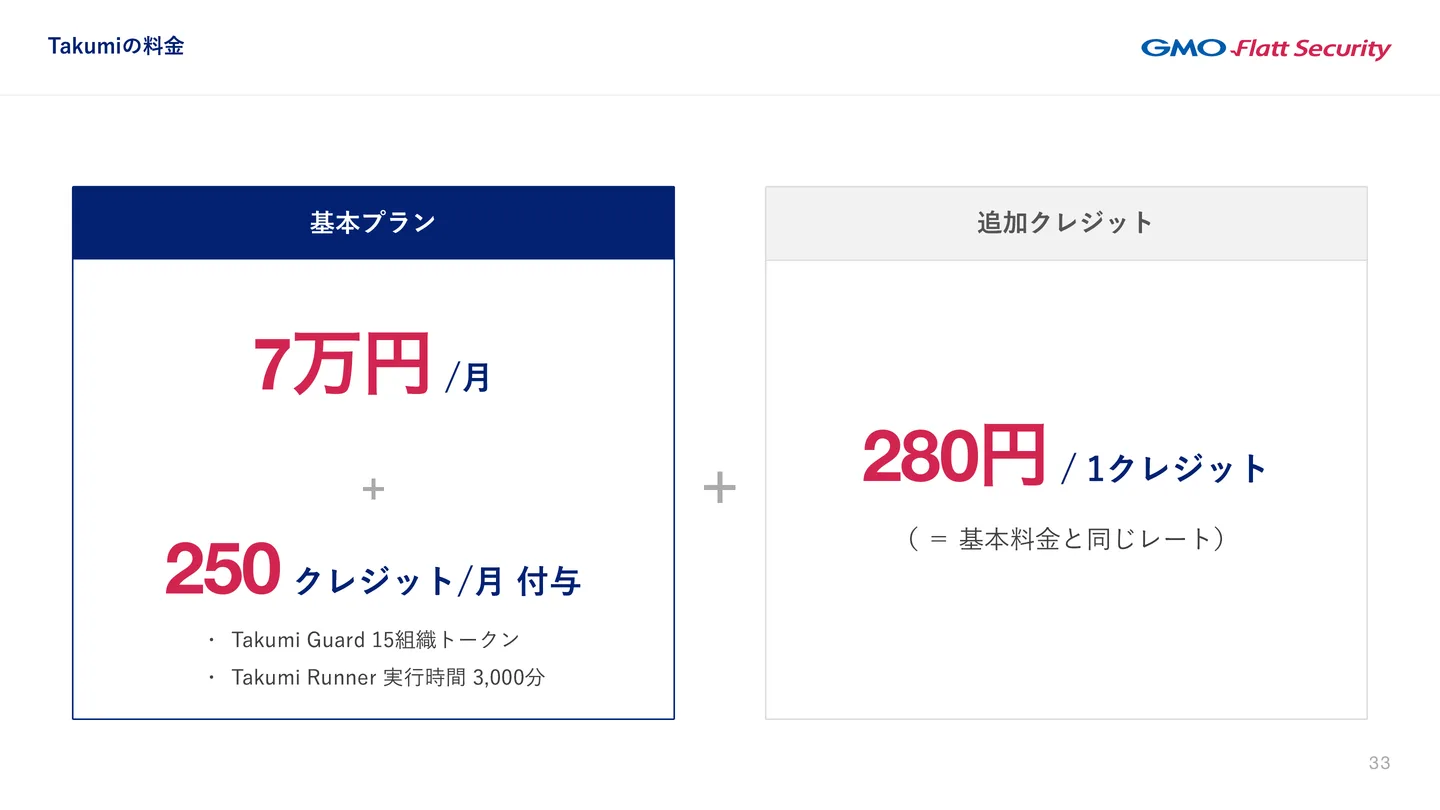
- 基本プラン: 月7万円で、毎月250クレジットが付与されます。基本は、この250クレジットをどうやりくりするかを考えます。Takumi Guard の有料の機能の15ユーザーと、Takumi Runner の GitHub Actions の実行時間3,000分も含まれるので、ソフトウェアサプライチェーン対策の機能も試せます。
- 追加のクレジット: 月の250クレジットを使い切ったら、追加で購入できます。1クレジット280円で、7万円で250クレジットの基本プランと同じレートなので、追加分が割高になることはありません。
診断1項目の目安はブラックボックス5〜8・ホワイトボックス1〜3クレジット
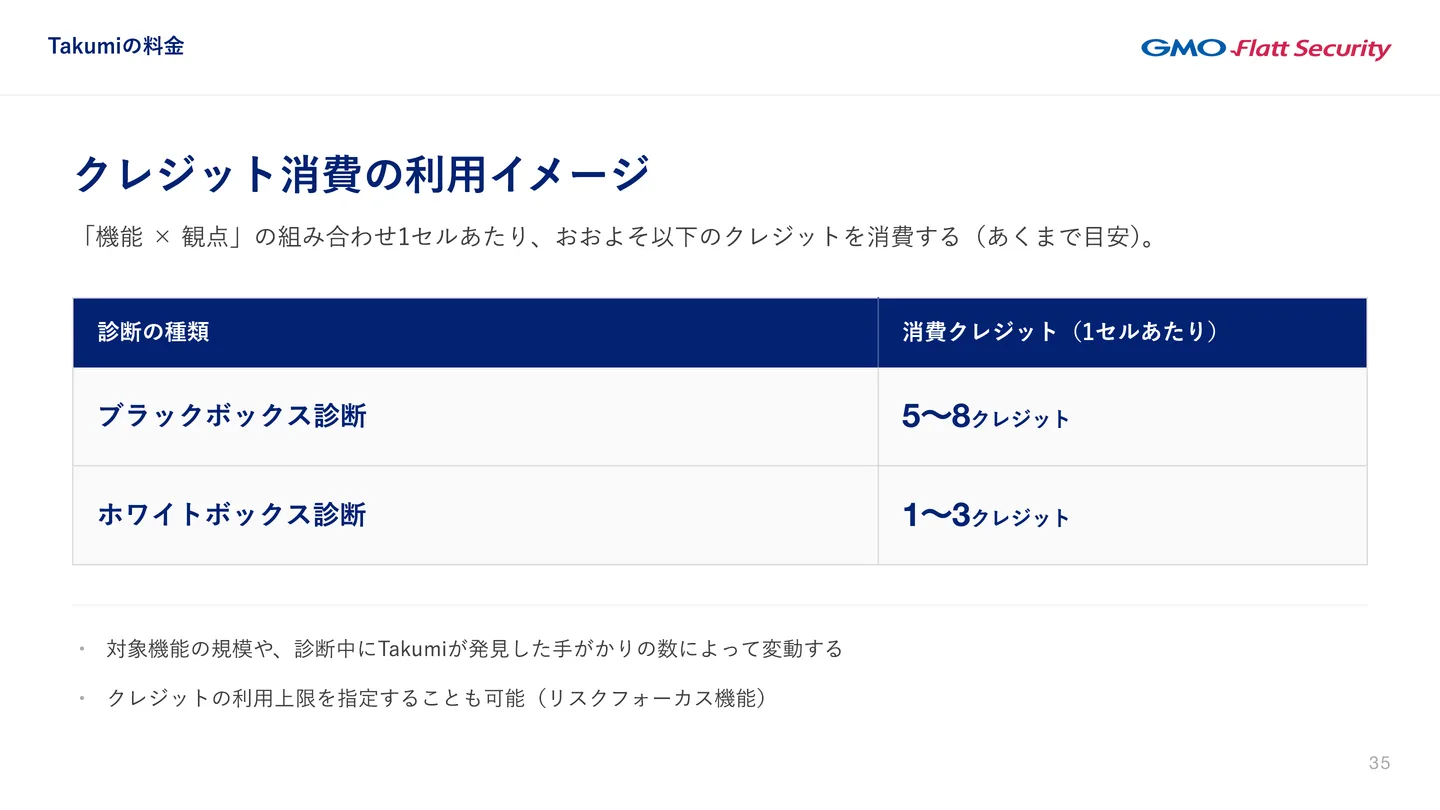
クレジットは、クロールで生成される「機能×観点」のマトリックスの1マスあたりで消費されます。1マスあたりの目安は、ブラックボックス診断で5〜8クレジット、ホワイトボックス診断で1〜3クレジットで、ブラックボックス診断のほうが少し高めです。対象の機能の規模や、診断中に Takumi が見つけた手がかりの数によって変動します。クロールでもクレジットを消費しますが、診断に比べるとかなり少なめです。
リスクフォーカス機能でクレジットの消費の上限を指定しておけば、マトリックスのすべてのマスを見るのではなく、予算に沿ったクレジットの消費の中で Takumi が優先順位を付け、セルごとにクレジットを消費しながら確かめます。最終的には試していただくしかない部分もありますが、アプリケーション1つあたり数十クレジットを用意しておけばよい、といった感覚は、比較的早い段階でつかめるはずです。
コーディングエージェントとの違い
Takumi はコーディングエージェントにない診断の網羅性と安定性を提供する
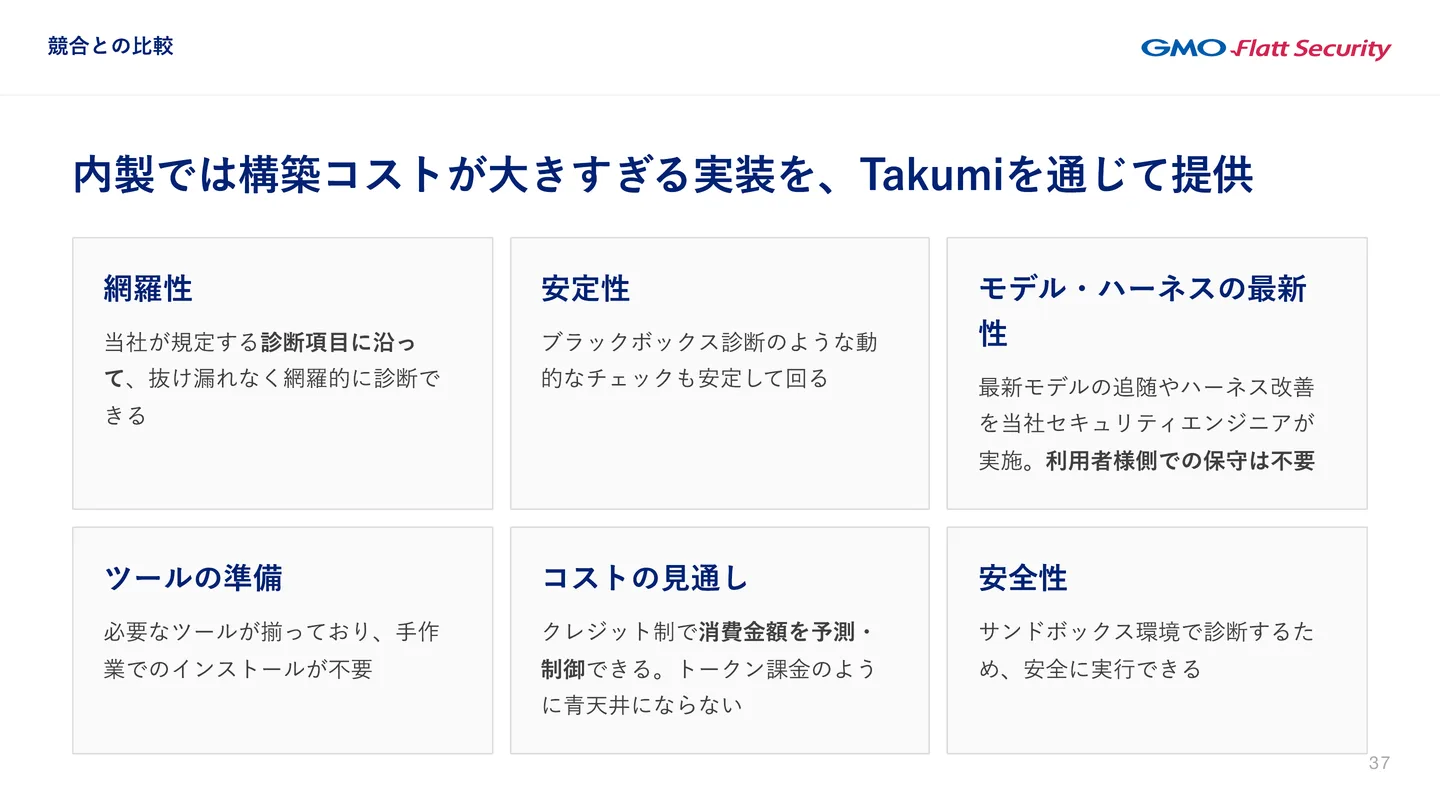
Claude Security や Codex Security のような、モデルに道具を持たせて脆弱性を探させる仕組み(ハーネス)を備えた製品や、Claude Code などのコーディングエージェントを回す場合と、Takumi を使う場合とでは何が違うのか、という質問をよくいただきます。まず、UI が提供されていて、さまざまな職種の方が使いやすいことが1つです。また、診断ごとにクレジットの消費の上限を決める機能そのものは、こうした製品には無いはずで、Takumi の差別化の部分です。そのうえで利点を列挙すると、次の6つになります。特に重要なのは、はじめの3つです。
- 網羅性: 脆弱性診断では診断対象を網羅的に検査する必要がありますが、AI は手を抜くこともあり、くまなくチェックさせるのは意外と制御が効きません。制御が効いていない状態では、お客様に対して「きちんとしたセキュリティチェックをしている」とは言えません。Takumi は、弊社が規定する診断の項目に沿って観点を網羅し、安定して診断します。
- 安定性: ブラックボックス診断のような動的な検証は、途中で失敗したり、安定しなかったりすることがあります。弊社はハーネスを作り込んでいるので、安定して稼働します。
- モデル・ハーネスの最新性: その時点で最良の価値を提供できるように、最新のモデルへの追随やハーネスの改善を、弊社のセキュリティエンジニアが常に行います。利用者の側での保守は要りません。弊社が作り込んだ実装を、利用者の皆様にスケールした形で提供することが、Takumi が根本的に目指しているものです。
- ツールの準備: 必要なツールがそろっていて、手作業でのインストールが要りません。
- コストの見通し: クレジット制なので、消費する金額を予測し、制御できます。トークンの課金のように、上限なく増えることはありません。
- 安全性: サンドボックスの環境で診断するので、安全に実行できます。
Anthropic との提携と自社の診断実務が Takumi を支えている
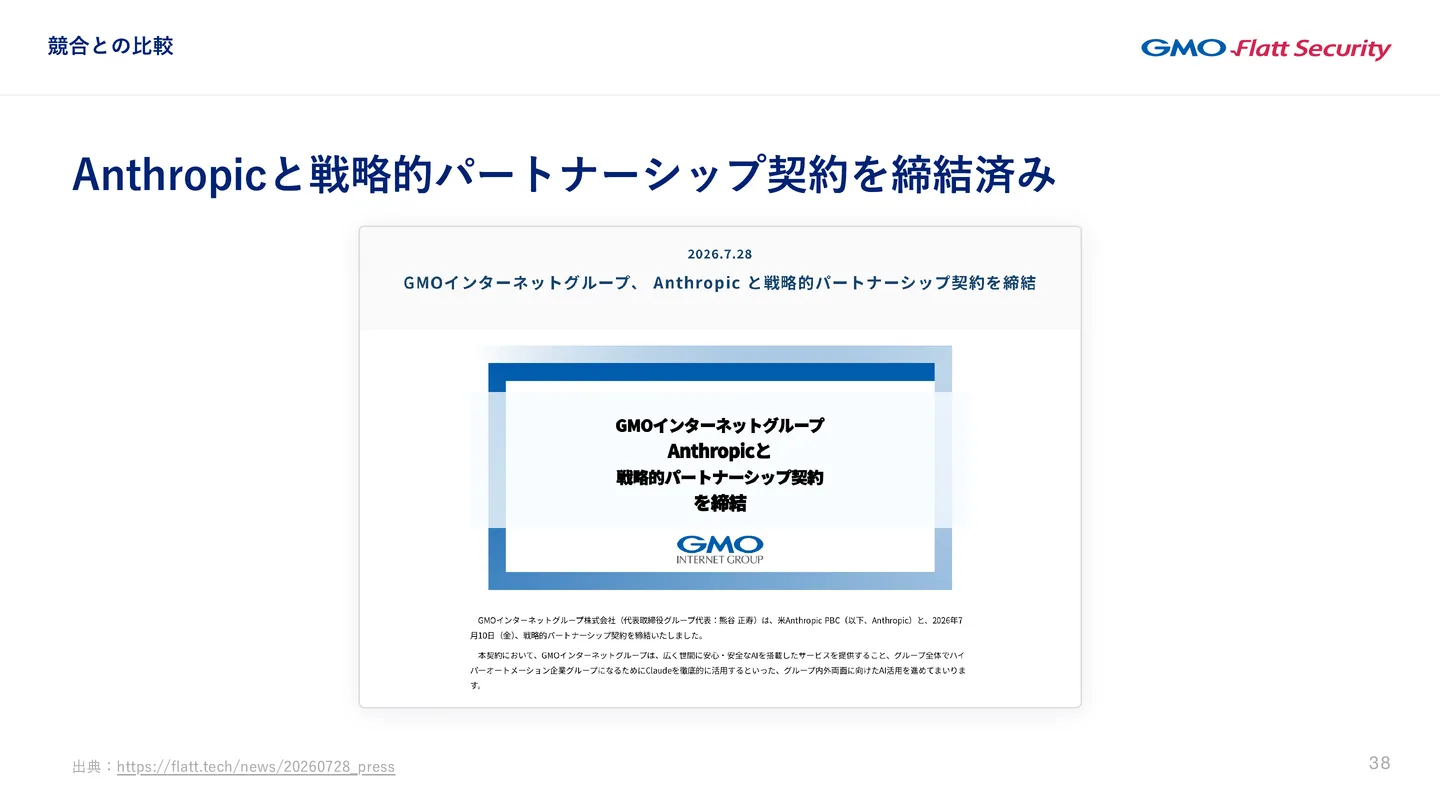
GMO インターネットグループは、Anthropic と包括的な戦略的パートナーシップ契約を結んでいます。詳細は公開できない部分もありますが、Anthropic のモデルを使ううえでいくつかの恩恵を受けていて、弊社にしかない強みの1つです。
また、弊社のプロフェッショナルサービスである脆弱性診断・ペネトレーションテストの実務でも、日々 Takumi を活用しています。実務に投入していると、こういうところで失敗する、こういうことができたほうがよい、という点が都度出てくるので、Takumi はそこで鍛えられ、更新され続けています。
まず手元のコーディングエージェントで試すのも一案
弊社としては Takumi の利用をおすすめしますが、まずは手元のコーディングエージェントに脆弱性を見つけさせてみるのも一つの選択です。おそらく、見つかるという前向きな感想と、安定しない、思うようにいかない、面倒だという否定的な感想の両方が出てきます。その実感があると、Takumi の価値も伝わりやすいかもしれません。
Takumi を「外部の第三者」とみなせるかは自社の要件で決まる
脆弱性診断には、品質の評価そのものとは別に、第三者による保証という側面があります。顧客から「外部の第三者による評価を受けていること」というセキュリティの要件を、セキュリティチェックシートなどで課される場面も引き続きあります。そのために Takumi とは別に人の診断を受けるべきかについては、コストメリットがあるほうを選んでいただければよい、というのが弊社の答えです。
Takumi を外部の第三者と見なしてよいかは、お客様のスタンスと外部からの要件によるので、弊社では決めきれません。要件が許すなら、Takumi のほうが安いので、Takumi で実施するのがよいでしょう。周りの環境がそれを許さないなら、弊社はプロフェッショナルサービスとして人の診断を提供しているので、そちらで対応できます。