
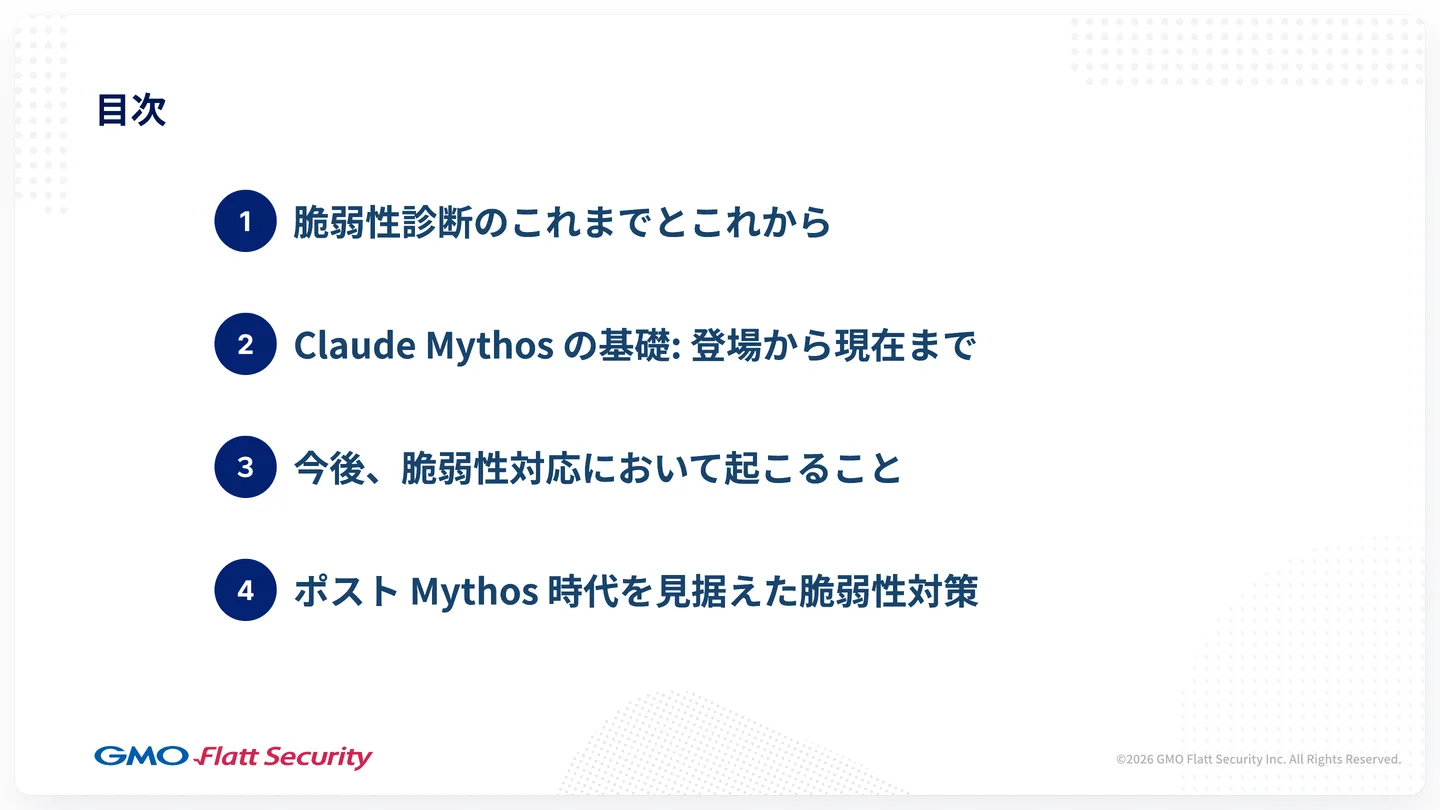
2026年4月に Anthropic が Claude Mythos を発表して以降、AI による脆弱性の発見と悪用をめぐるニュースが相次いでいます。この記事ではまず、AI が介在しない脆弱性診断とスキャナの限界を押さえ、次に Claude Mythos で実際に何が変わったのかを、発表の内容と第三者の評価の両面から確かめます。そのうえで、今後の脆弱性対応で起こる変化と、それに備えて技術面・組織面で変えるべきことを解説します。
AI エージェントで従来の脆弱性診断の限界を解決できる
従来の脆弱性診断は完了までに数か月かかることもある
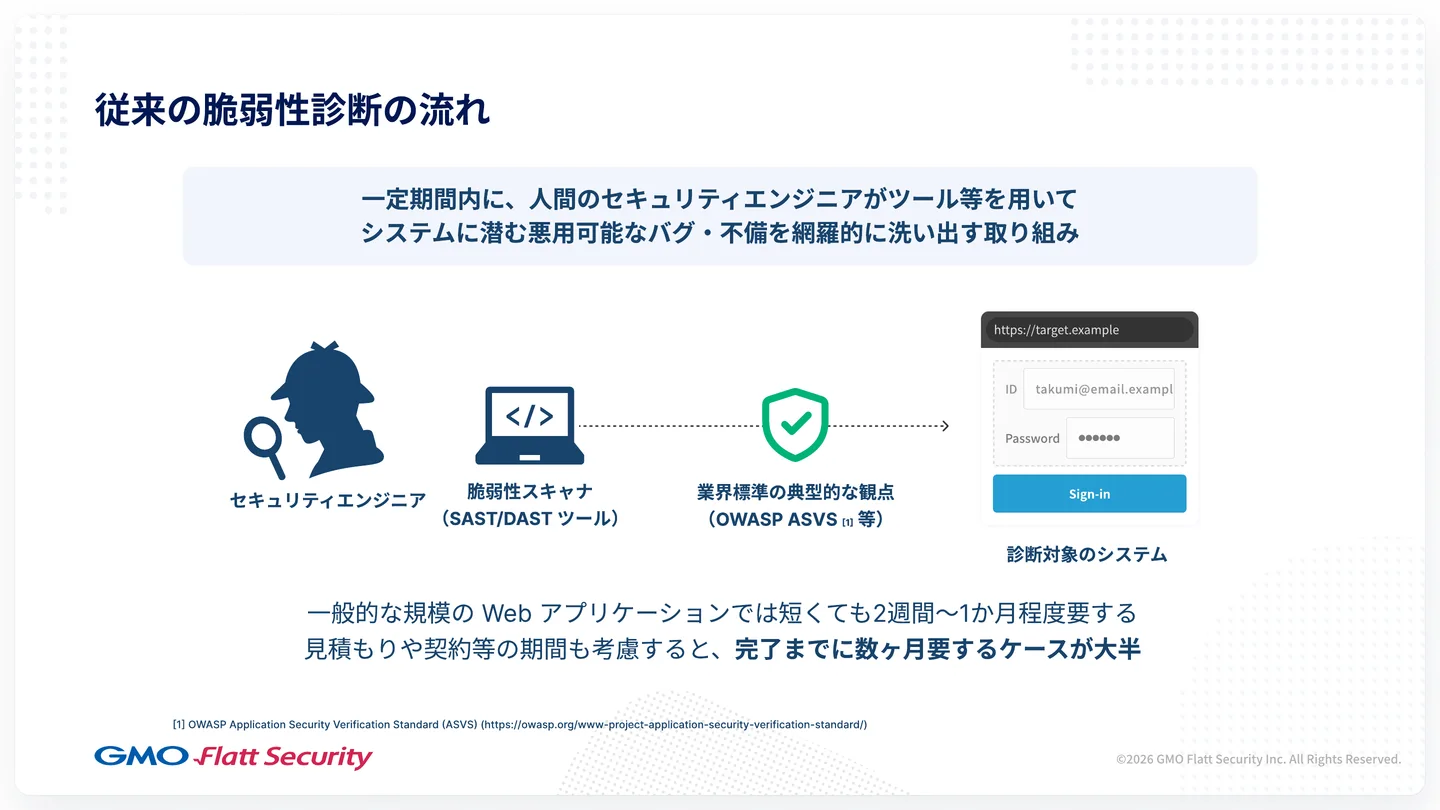
ここでいう従来の脆弱性診断は、AI が介在しない診断のことです。一定の期間の中で、人のセキュリティエンジニアがさまざまなセキュリティのツールを使いながら、システムに潜む悪用できるバグや不備を網羅的に洗い出します。検査では、OWASP ASVS などの業界標準に書かれた典型的な観点を網羅的に確かめるのが、主なやり方です。
一般的な規模の Web アプリケーションでも、人が診断すると、短くても2週間から1か月ほどかかることが大半です。診断の前には規模の見積もりや契約の期間もあるので、完了までに数か月かかることもまれではありません。
従来の脆弱性診断では SAST と DAST を組み合わせる
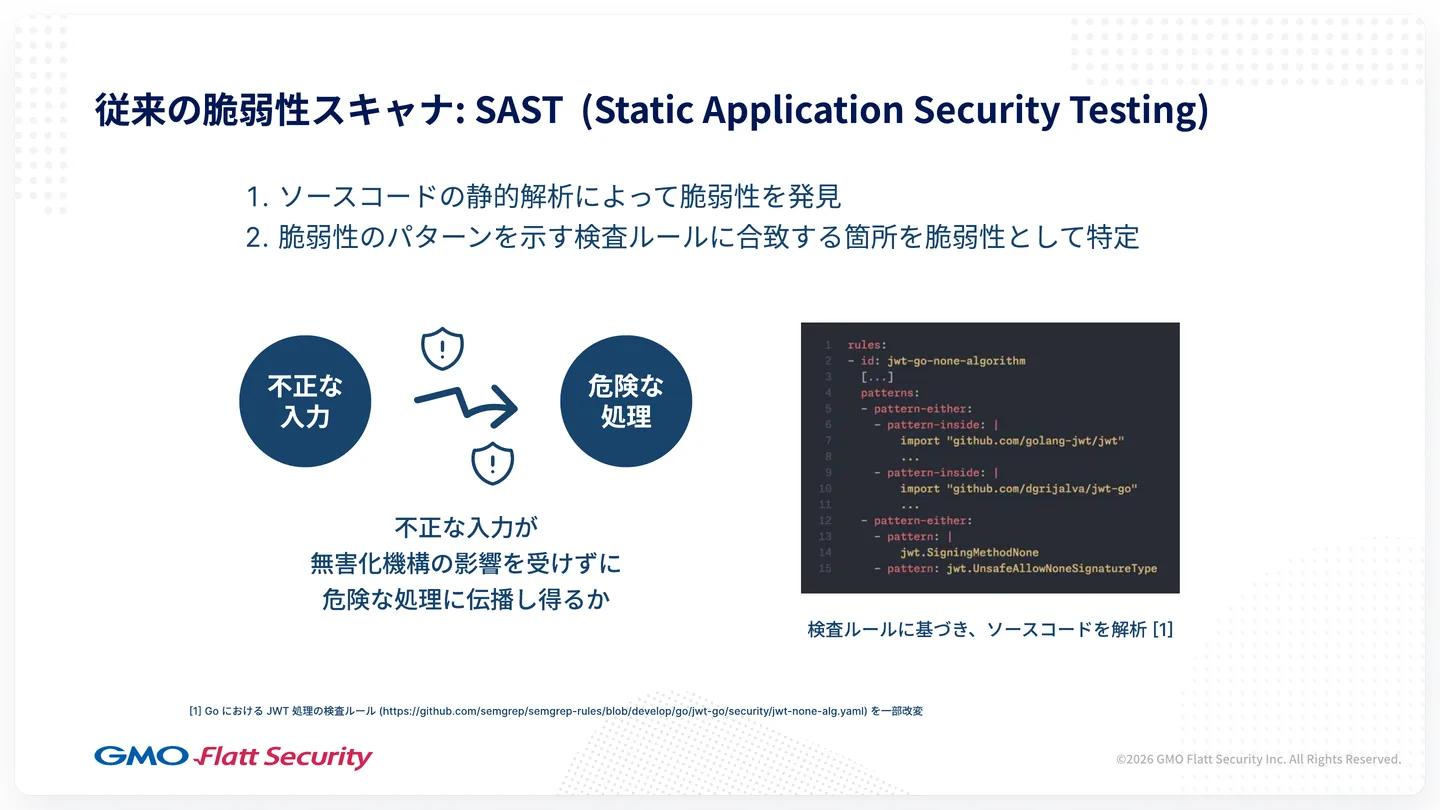
従来の脆弱性診断は、2つの種類の脆弱性スキャナを組み合わせて行うのが主な流れです。
SAST(Static Application Security Testing)は、ソースコードの静的解析で脆弱性を見つけるツールです。脆弱性のパターンを表した検査ルールに合う箇所を、コードベースから探して脆弱性として特定します。たとえば、JWT の署名のアルゴリズムに危険なものが使われていないかを見つけるルールがあります。SAST の主な役割は、攻撃者が入力したデータが、無害化や検証の仕組みを通らずに危険な処理まで届いてしまわないかを検査することです。
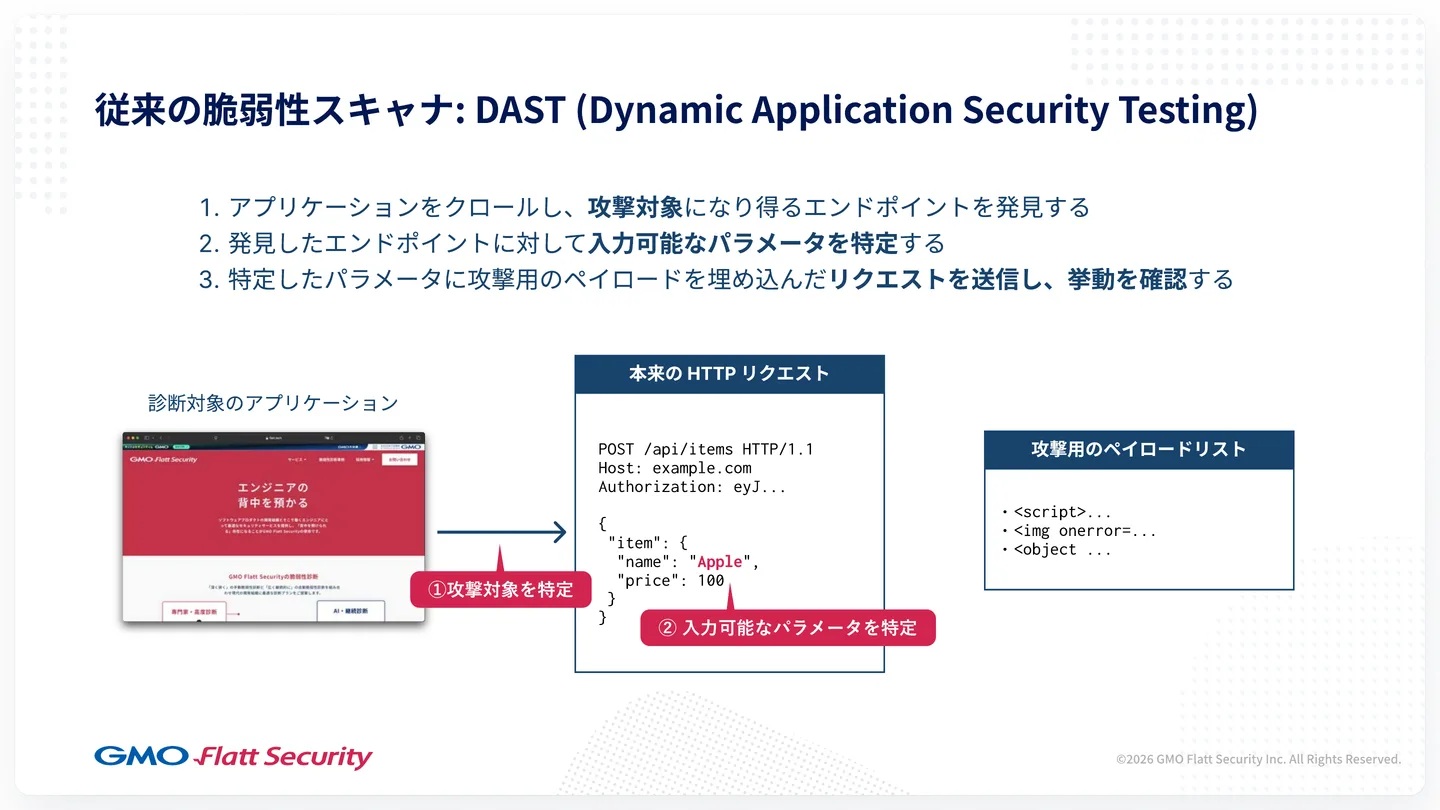
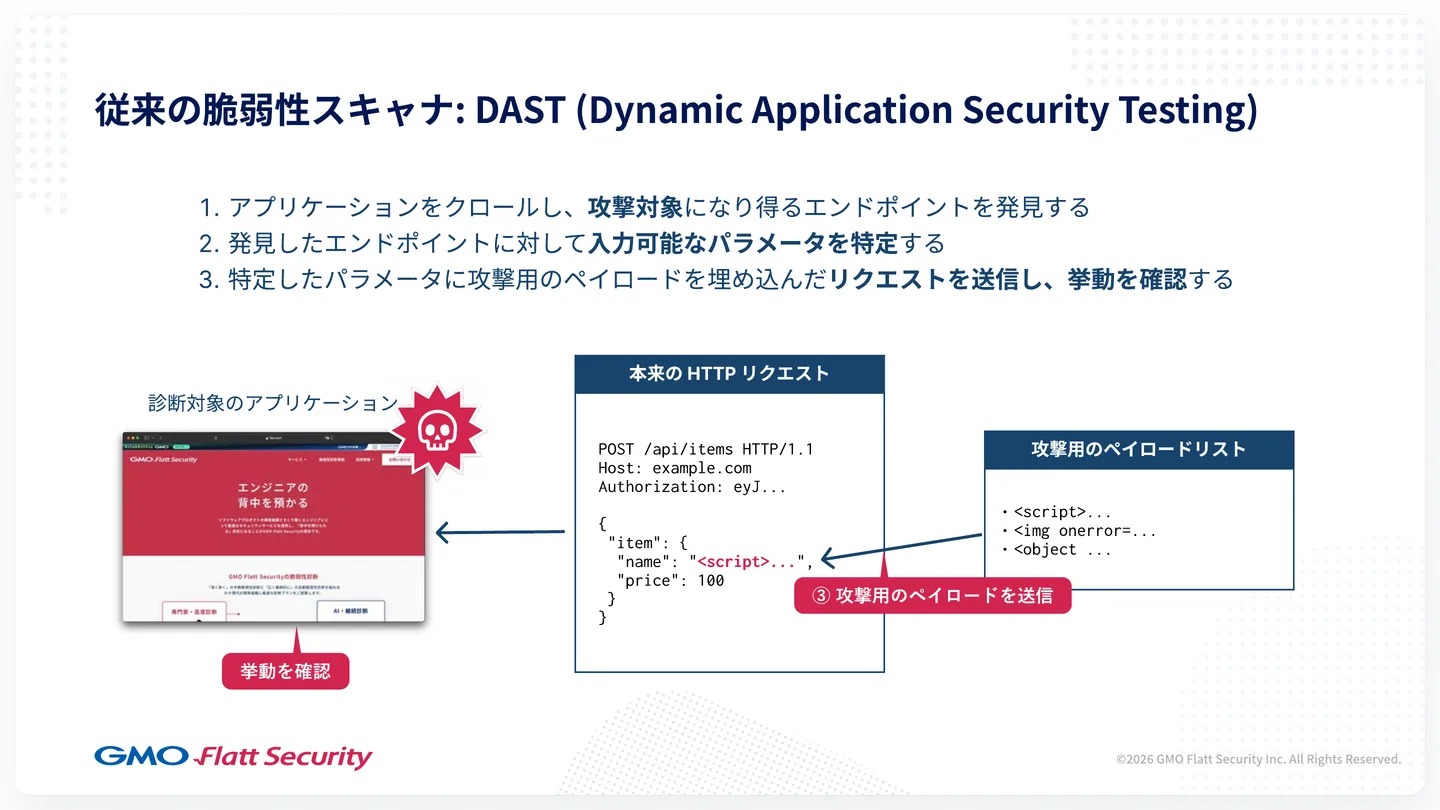
DAST(Dynamic Application Security Testing)は、動いているアプリケーションに対して試すツールです。まずアプリケーションをクロールして、API やページなど攻撃の対象になりうるエンドポイントを見つけます。次に、リクエストの中で操作できるパラメータを特定し、そこに攻撃用のペイロードを順に埋め込んだリクエストを送って、アプリケーションの挙動がどう変わるか、危険な挙動を引き出せないかを観察します。
既存のスキャナには検査ルールや適応的な診断に限界がある
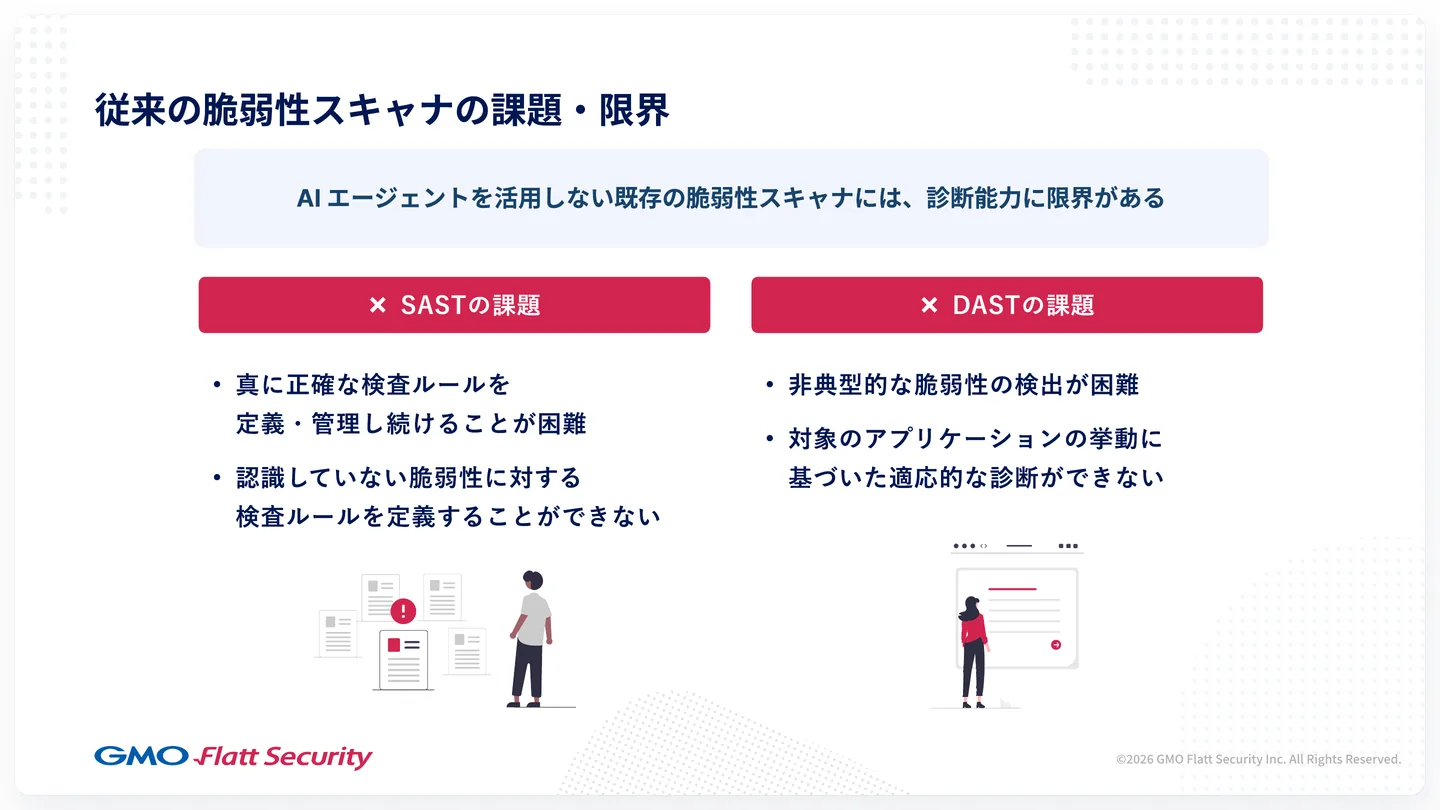
AI エージェントを使わない既存のスキャナには、診断の能力に限界があります。SAST の課題は、検査ルールの定義と管理が難しいことと、認識していない脆弱性の検査ルールを定義できないことの2つです。DAST の課題は、典型的でない脆弱性を見つけにくいことと、アプリケーションの挙動に合わせた適応的な診断ができないことの2つです。
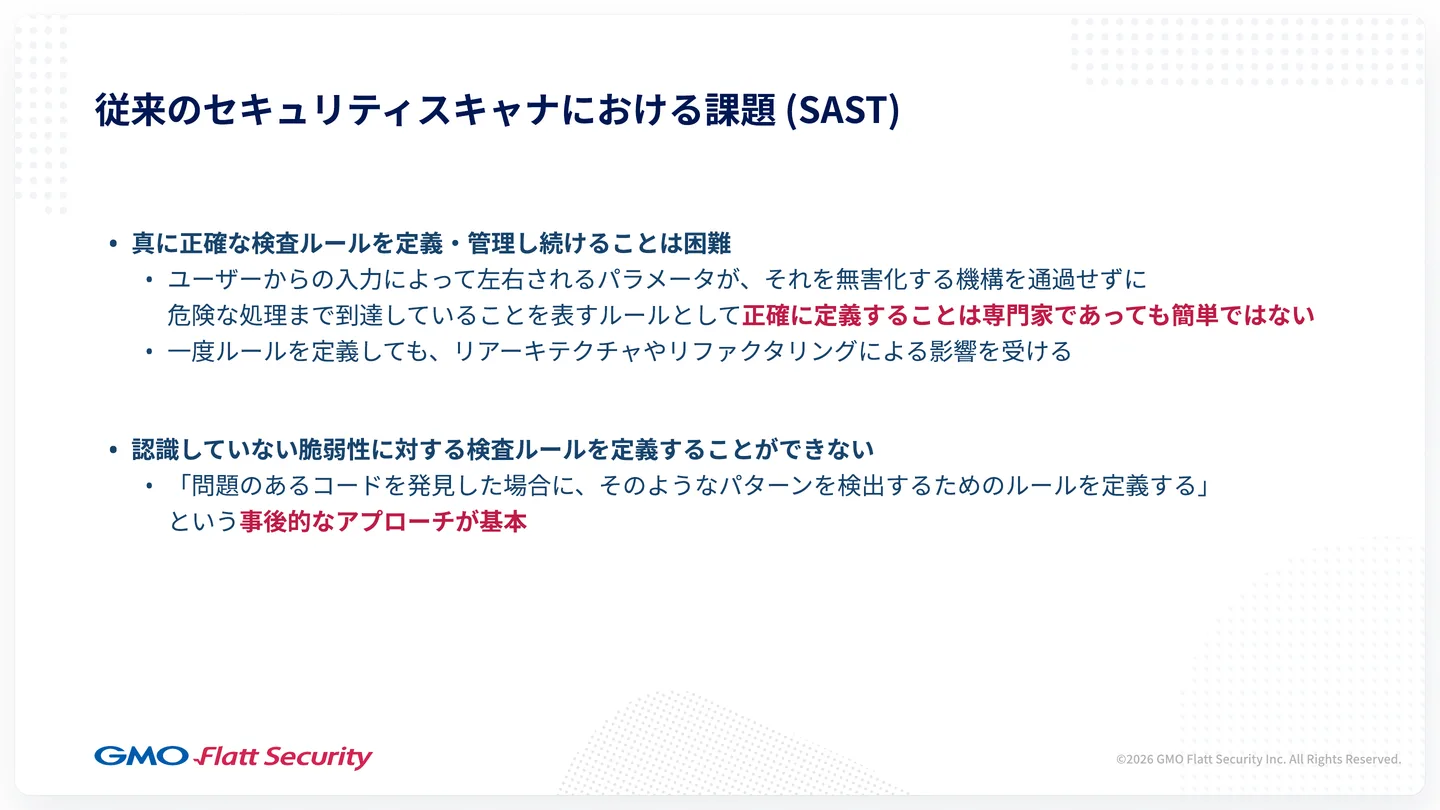
SAST の1つ目の課題は、正確な検査ルールを定義し、管理し続けることの難しさです。ユーザーの入力に左右されるパラメータが、無害化の仕組みを通らずに危険な処理まで届くことを、ルールとして正確に書くのは、セキュリティエンジニアのような専門家でも簡単ではありません。一度ルールを定義しても、ソフトウェアのアーキテクチャの変更やリファクタリングでコードのパターンが大きく変わると、既存のルールが使えなくなります。2つ目は、認識していない脆弱性のルールは定義できないことです。SAST のルールは、問題のあるコードが見つかったときに、同じパターンを今後は生まないようにと定義するものなので、事前に認識していない脆弱性のルールは当然書けず、事後的なアプローチが基本になります。
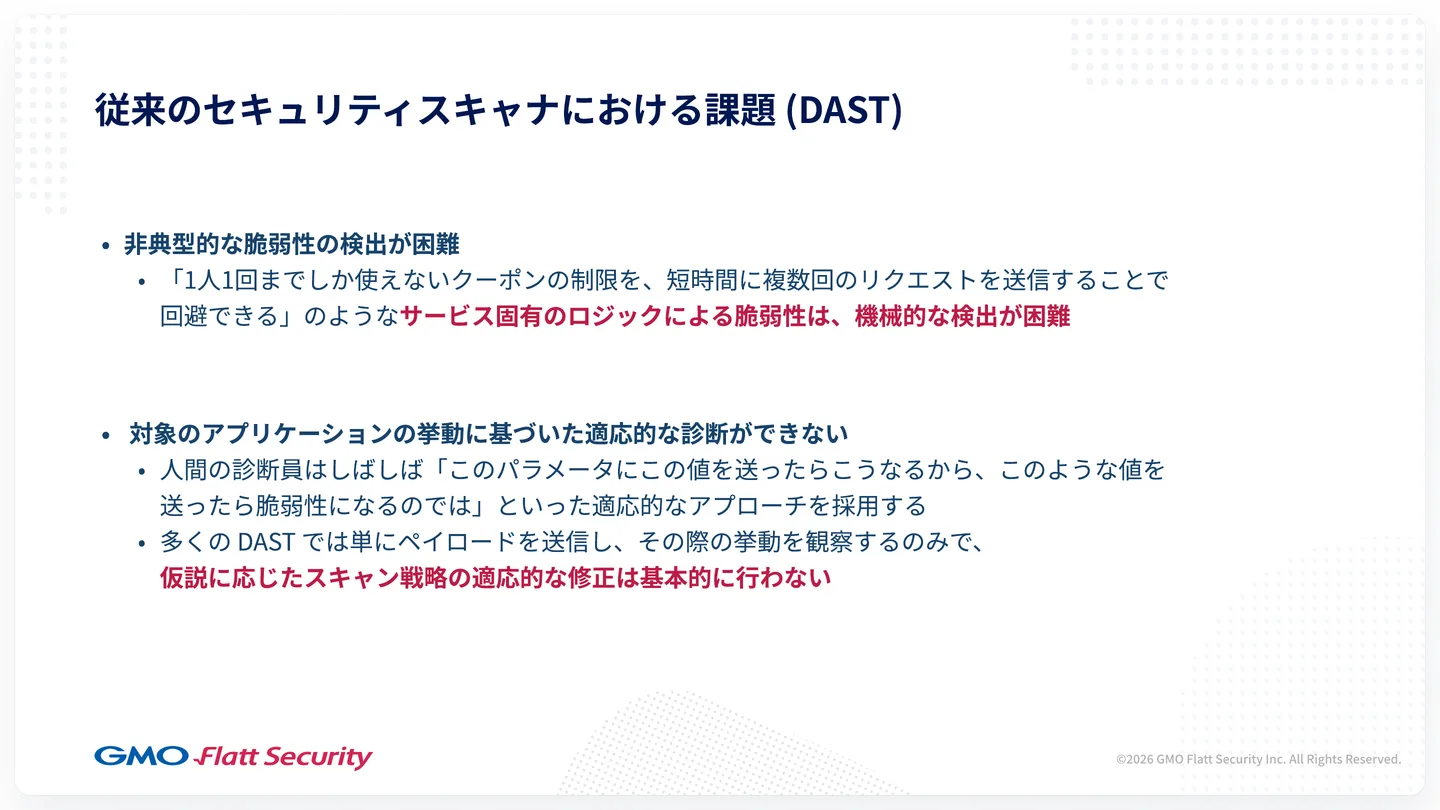
DAST の1つ目の課題は、典型的でない脆弱性を見つけにくいことです。DAST は、XSS や SQL インジェクションのように、アプリケーションの仕様によらない技術的な脆弱性の検出が得意です。しかし、EC サイトで「1人1回までのクーポンが、短い時間にまとめてリクエストを送ると2回以上使えてしまう」といった、サービス固有のロジックによる脆弱性を機械的に見つけるのは、非常に困難です。2つ目は、適応的な診断ができないことです。人の診断員は、最初からアプリケーションの挙動を理解しているわけではなく、「このパラメータにこの値を送ったら挙動がこう変わったので、こういう脆弱性があるのではないか」と仮説を立てて試し方を変える、適応的なアプローチをとることがほとんどです。多くの DAST は、ペイロードを送って挙動を観察するだけで、仮説を立ててスキャンの戦略を直すことは、基本的にできません。
AI エージェントはツールの速さと人の精度を両立できる
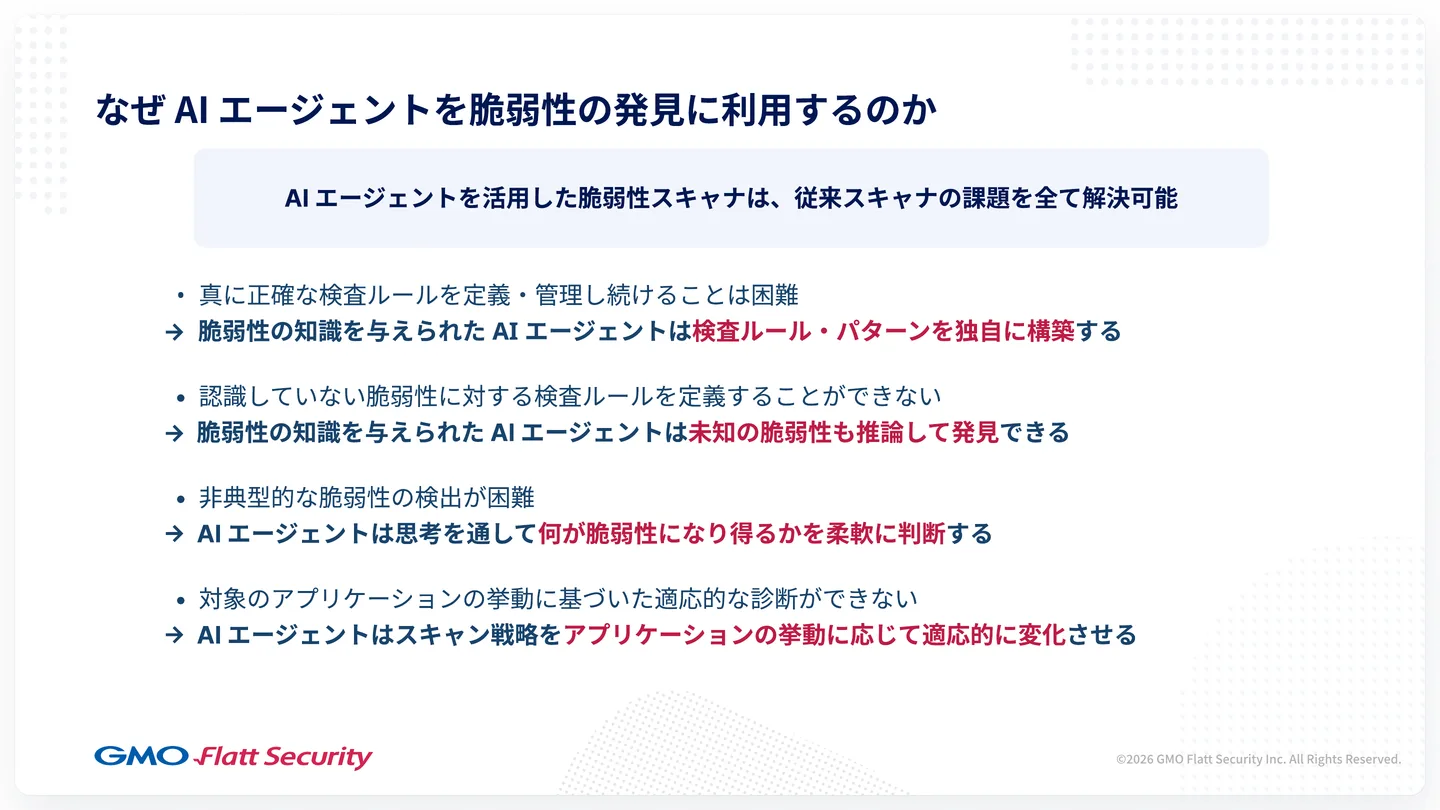
AI エージェントの力を使えば、こうした既存のスキャナの課題をまんべんなく解決できます。弊社が AI を用いた脆弱性の発見に取り組んでいるのは、そのためです。
- 検査ルールの定義と管理: 脆弱性の知識を与えられた AI エージェントは、検査のルールやパターン、問題になりうるコードのパターンを、自分で類推して組み立てます
- 未知の脆弱性: 推論によって、未知の脆弱性も見つけられます。AI がさまざまなゼロデイの脆弱性を見つけている最近の状況が、それを示しています
- 典型的でない脆弱性: 思考を重ねたり、アプリケーションのドキュメントを読んだりして、そのアプリケーションではどんな挙動が脆弱性になりうるかを柔軟に判断します
- 適応的な診断: スキャンの途中でも、対象のアプリケーションの挙動やコードの特徴に合わせて、戦略を適応的に変えられます
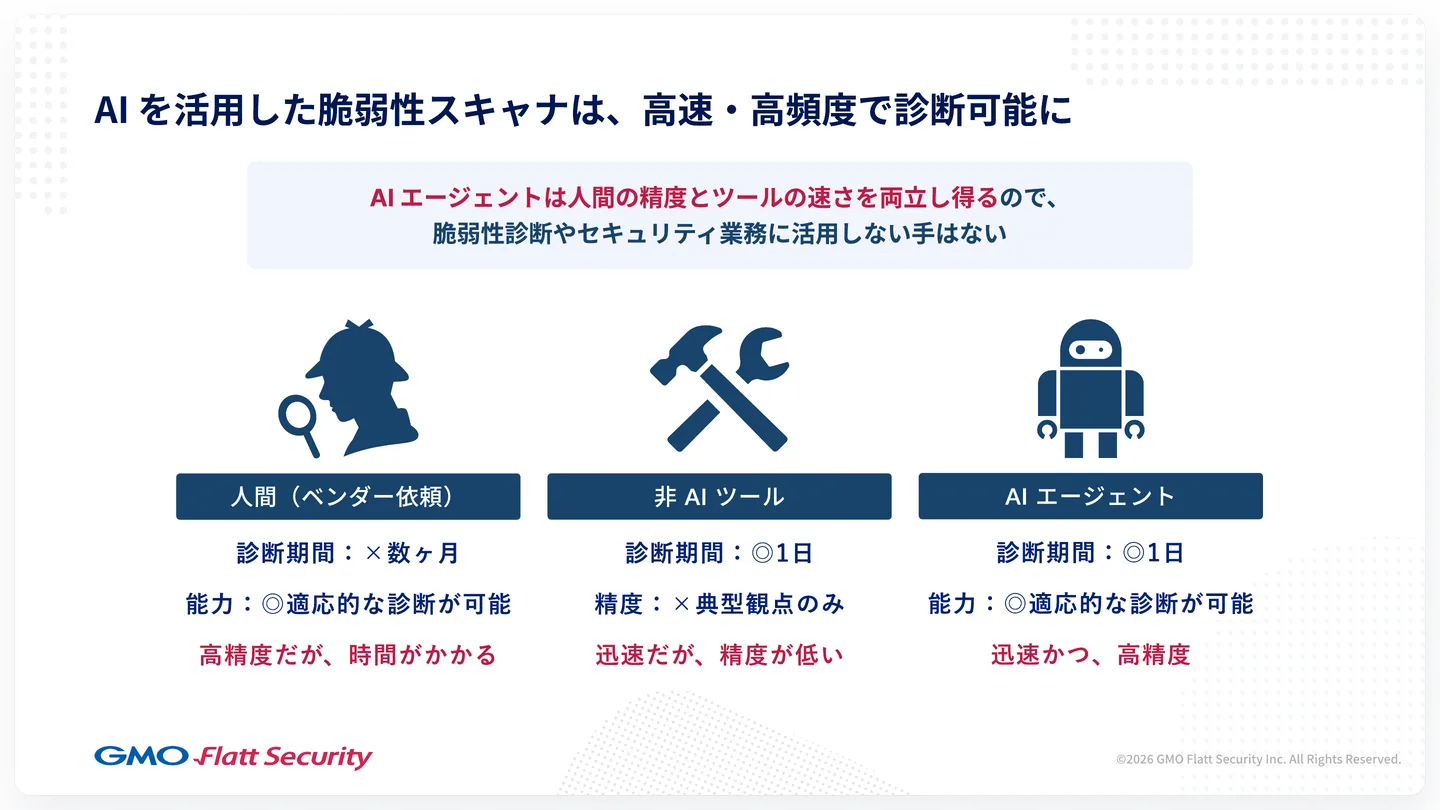
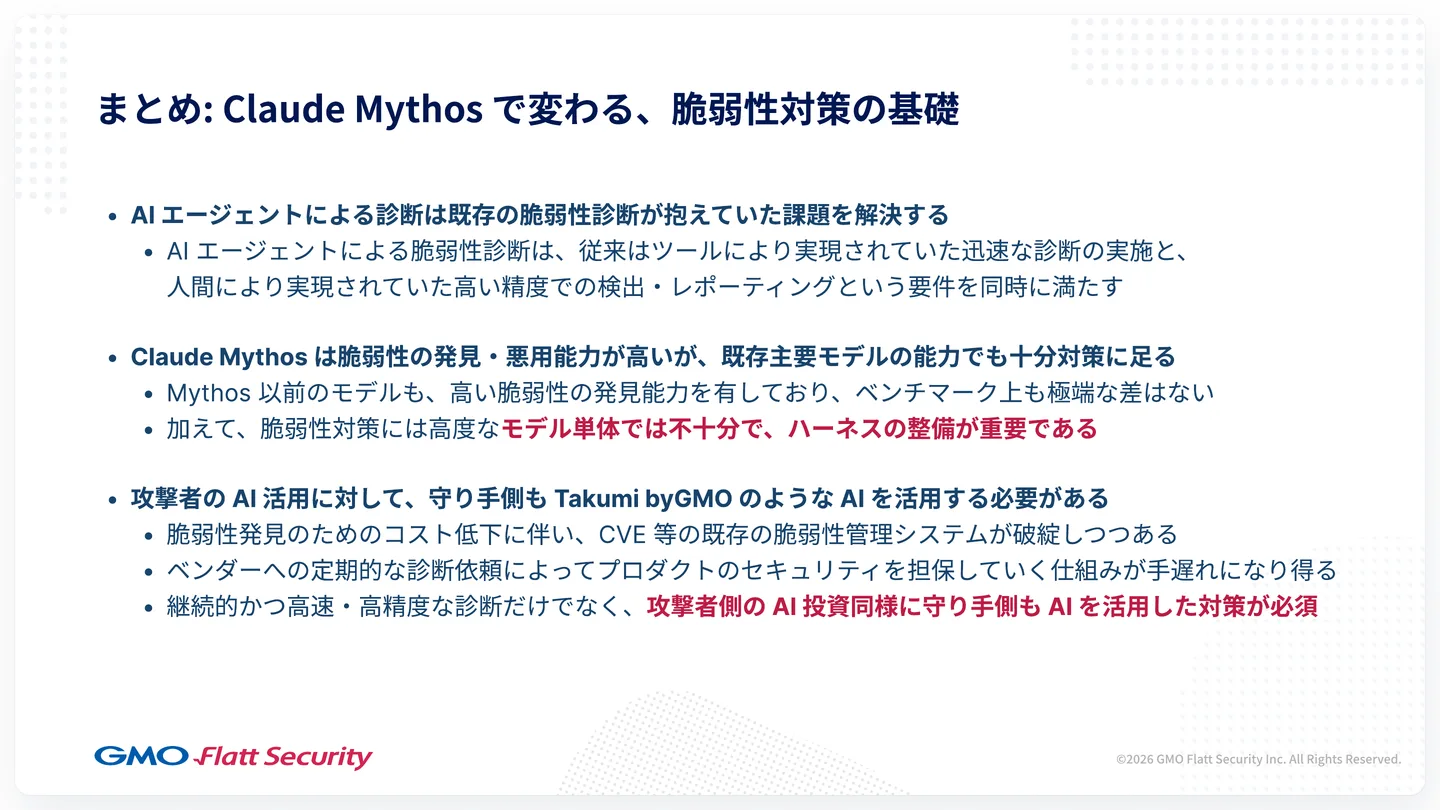
ベンダーに依頼する人の診断は、高精度ですが、どうしても時間がかかります。AI を使わないツールでの診断は速く終わりますが、見られる観点や精度に問題が出ます。AI エージェントなら、短時間で診断を終えながら、適応的な診断によって高い精度を出せます。人の精度とツールの速さを両立しうる以上、脆弱性診断やセキュリティのさまざまな業務に、積極的に活用すべき状況です。
Claude Mythos の悪用能力の向上と第三者による評価
モデルは次第に抽象度の高い目標でもタスクを遂行できるようになってきた
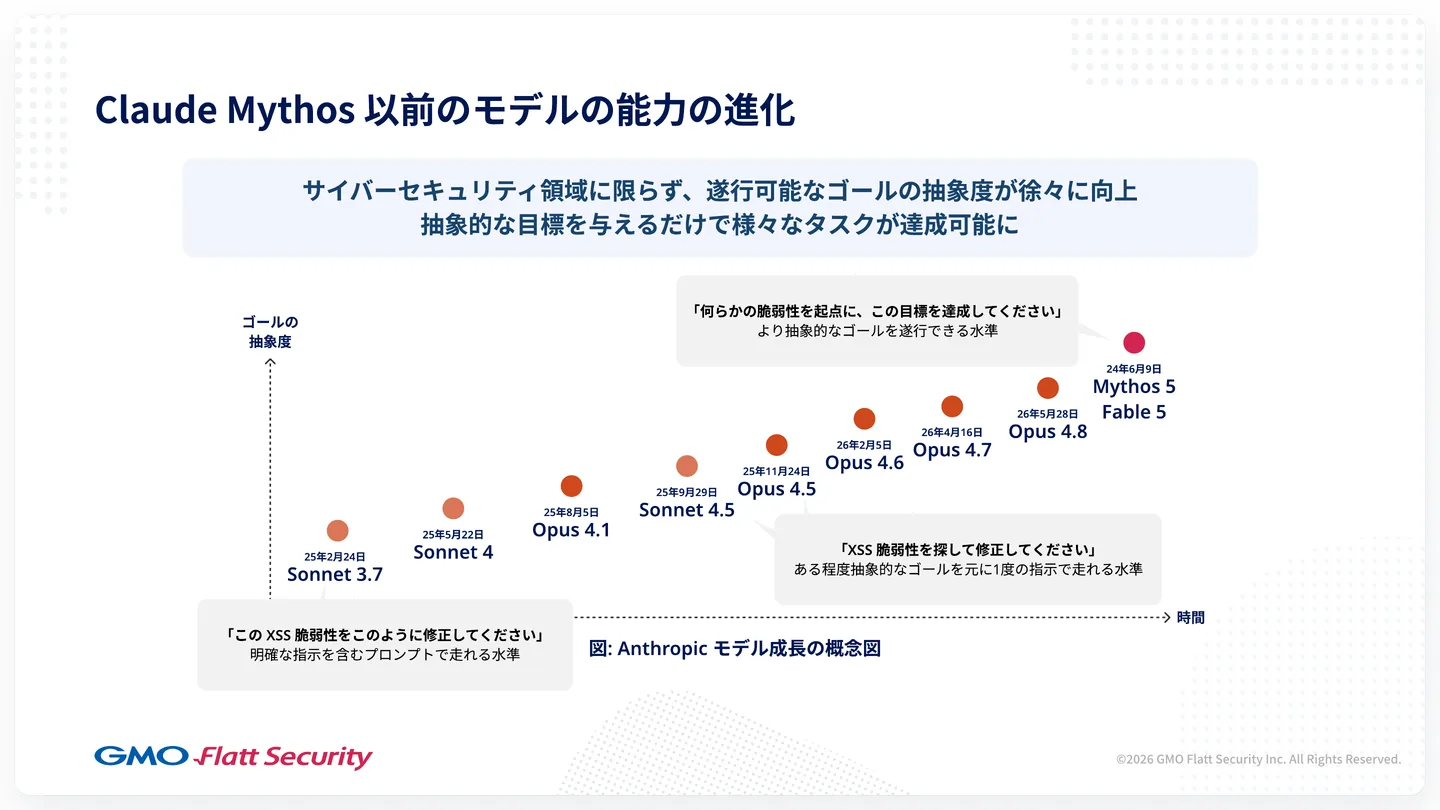
Claude Mythos が出る前から、サイバーセキュリティの領域に限らず、モデルが達成できるゴールの抽象度は徐々に上がっていました。直近のモデルは、抽象的な目標を与えるだけで、さまざまなタスクを達成できるようになりつつあります。
2025年2月に Anthropic がリリースした Claude 3.7 Sonnet のころは、「ここにこういう脆弱性があるので、この方法で修正してください」と、何をしてほしいかを明確に指示するプロンプトを与えれば、タスクを遂行できる、という水準でした。2025年の後半に出た Sonnet 4.5 や Opus 4.5 では、「脆弱性を探して直してください」という、ある程度抽象的なゴールでもタスクを達成できる水準になりました。直近の Mythos 5 などでは、「何らかの脆弱性を見つけて、この目標を達成してください」という、どう進めればよいかがまったく未知のタスクでも、ゴールを達成できる水準に達しています。
脆弱性を見つける能力は1年前には実用水準に達していた
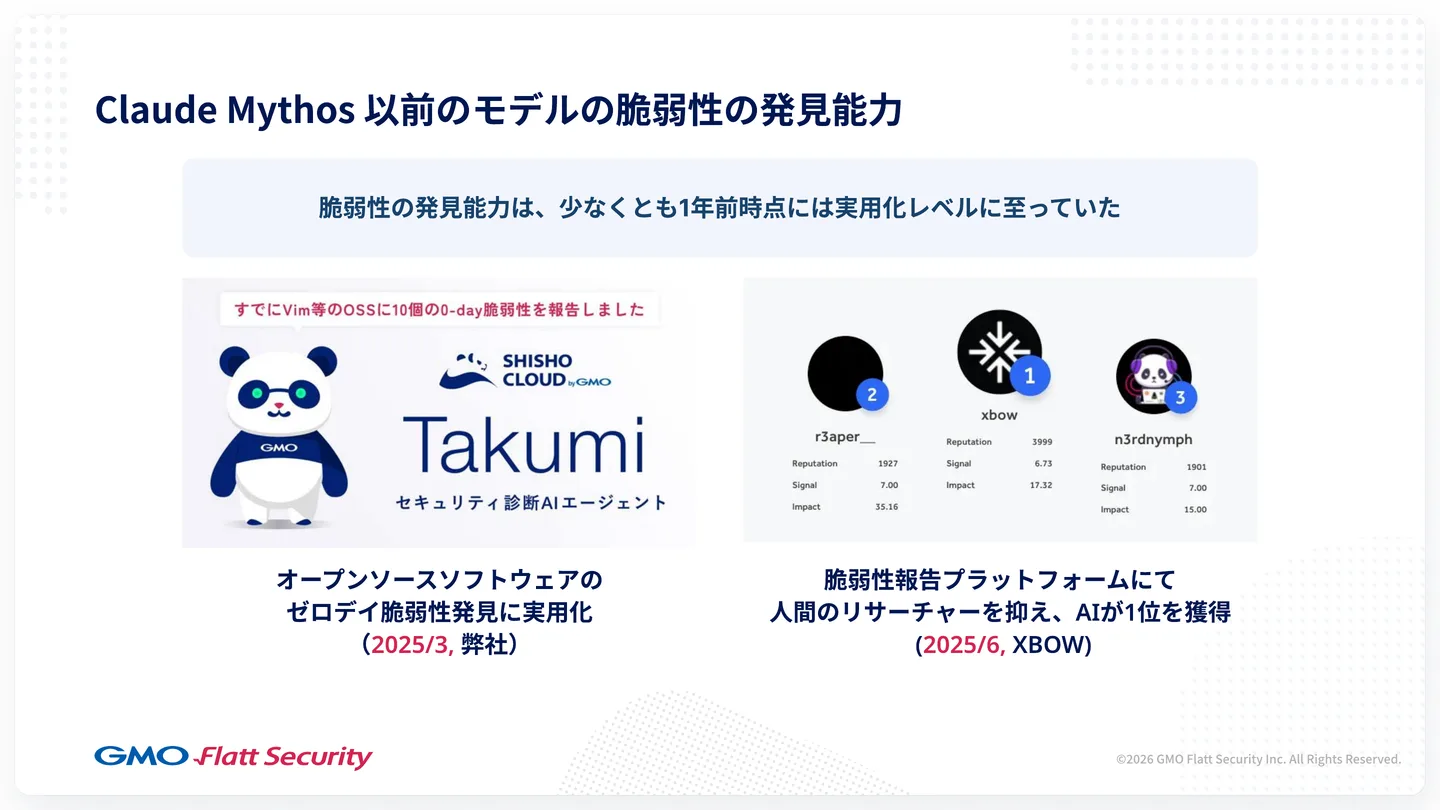
Claude Mythos 以前のモデルも、脆弱性を見つける能力に関しては、少なくとも1年前かそれ以前から、ほぼ実用化の水準に至っていました。弊社は2025年3月の時点で、Takumi byGMO を使い、Vim をはじめとするオープンソースソフトウェアにゼロデイ脆弱性を報告していました。2025年6月には、脆弱性報告のプラットフォームで、XBOW の AI エージェントが人のリサーチャーを差し置いてランキングの1位を取る事例もありました。
Claude Mythos で大きく向上した脆弱性の悪用能力
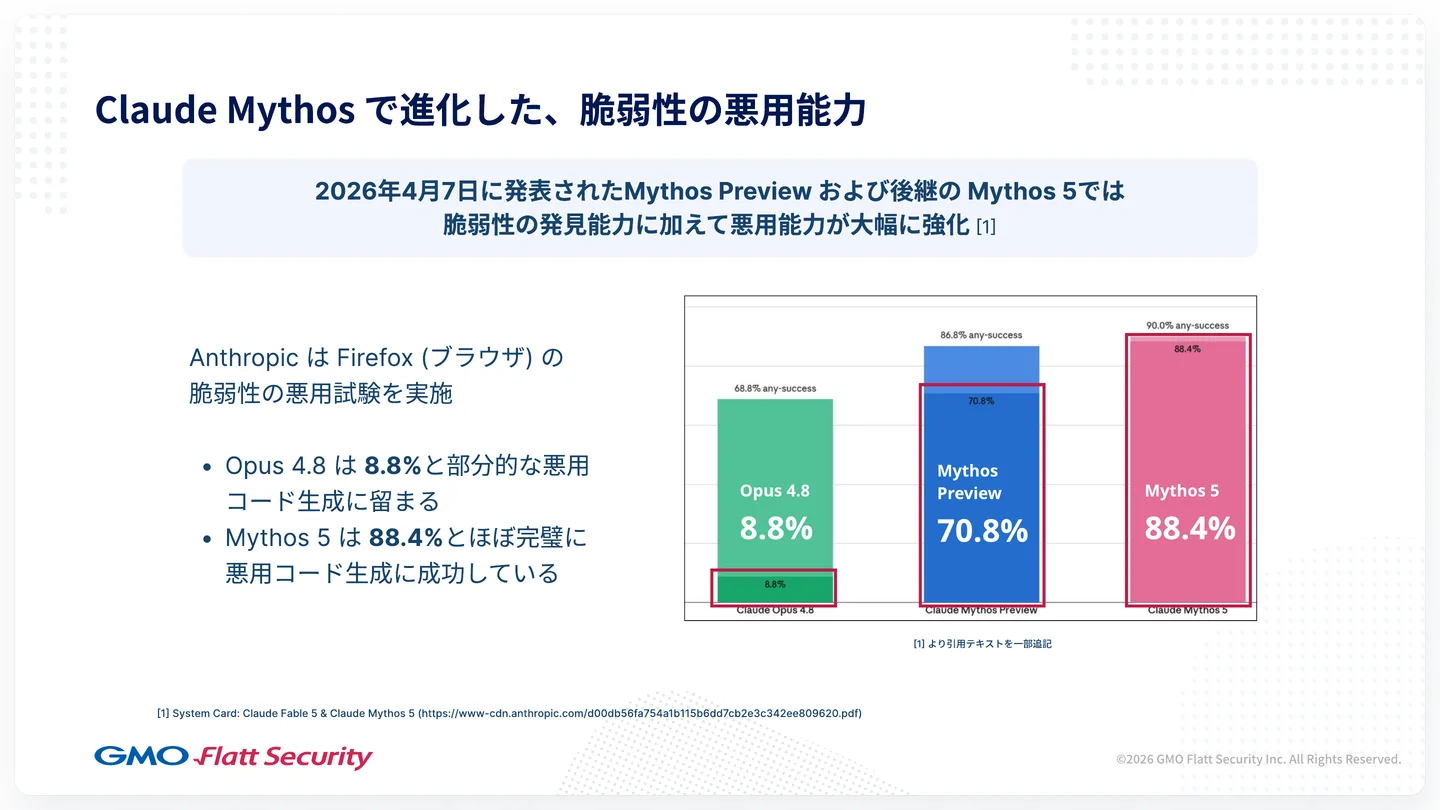
2026年4月7日に発表された Mythos Preview と、後継の Mythos 5 では、脆弱性を見つける能力に加えて、悪用(エクスプロイト)する能力が大幅に強化されたと発表されています。Anthropic が Firefox の脆弱性で行った悪用の試験では、Opus 4.8 は8.8%で、悪用のコードを部分的に作るところにとどまりました。Mythos Preview は70.8%、Mythos 5 は88.4%で、ほぼ完璧に悪用のコードを作れています。
攻撃者より先に脆弱性を修正するための枠組み Project Glasswing
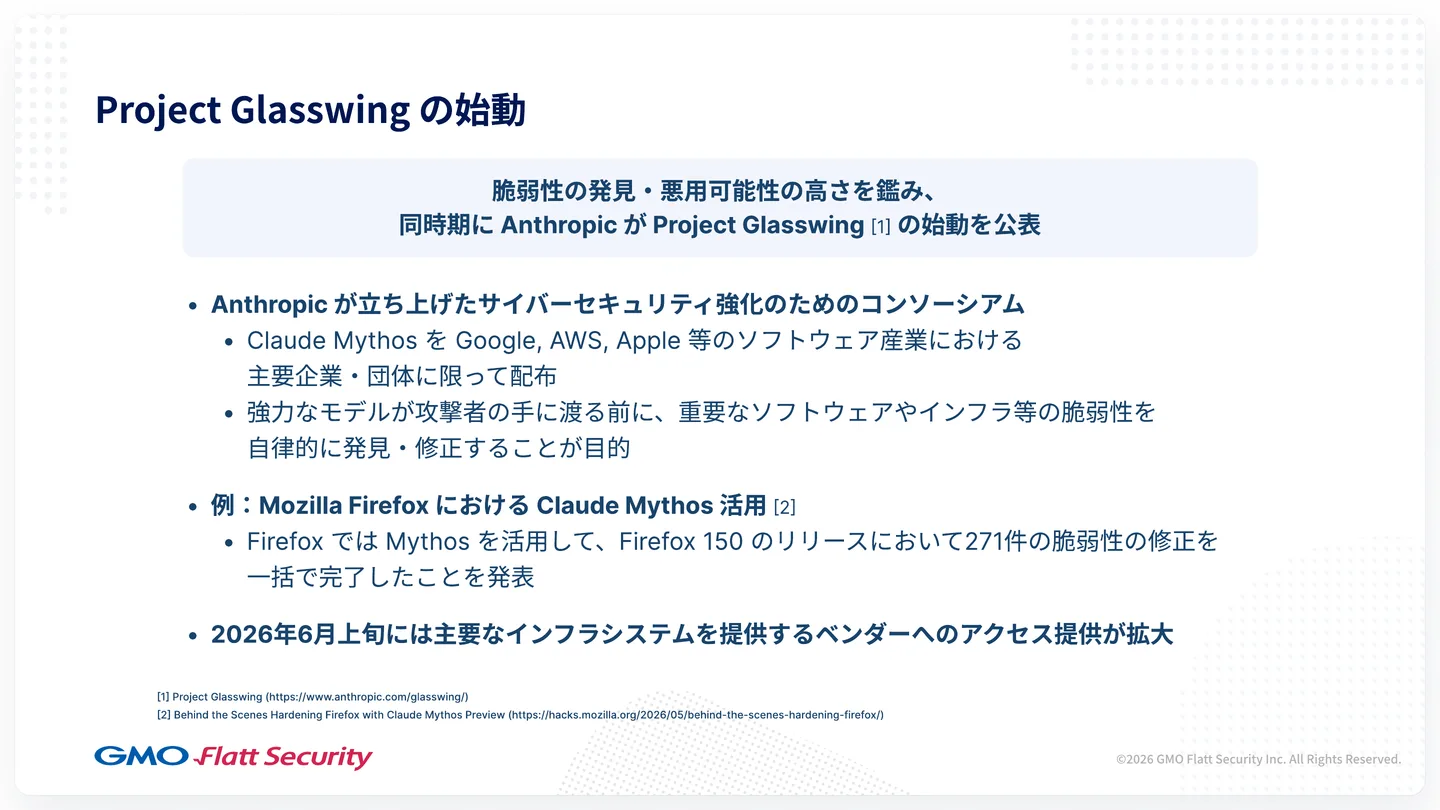
脆弱性の発見と悪用の能力がかなり高くなったことを踏まえて、Anthropic は同じ時期に Project Glasswing の始動を公表しました。Project Glasswing は、Anthropic が立ち上げたサイバーセキュリティ強化のためのコンソーシアムで、Claude Mythos をはじめとする最先端のモデルを、ソフトウェア産業の主要な企業や団体に限って提供します。強力なモデルが攻撃者の手に渡る前に、こうした事業者が提供する重要なソフトウェアやインフラの脆弱性を、前もって自律的に見つけて直すことが目的です。
たとえば Mozilla は、Mythos を活用して、Firefox 150 のリリースで271件の脆弱性の修正を一括で完了したと発表しています。2026年6月上旬には提供の範囲が広がり、主要なインフラのシステムを提供するベンダーも使えるようになりました。
Claude Fable 5 は防御用途にもほぼ使えなかった
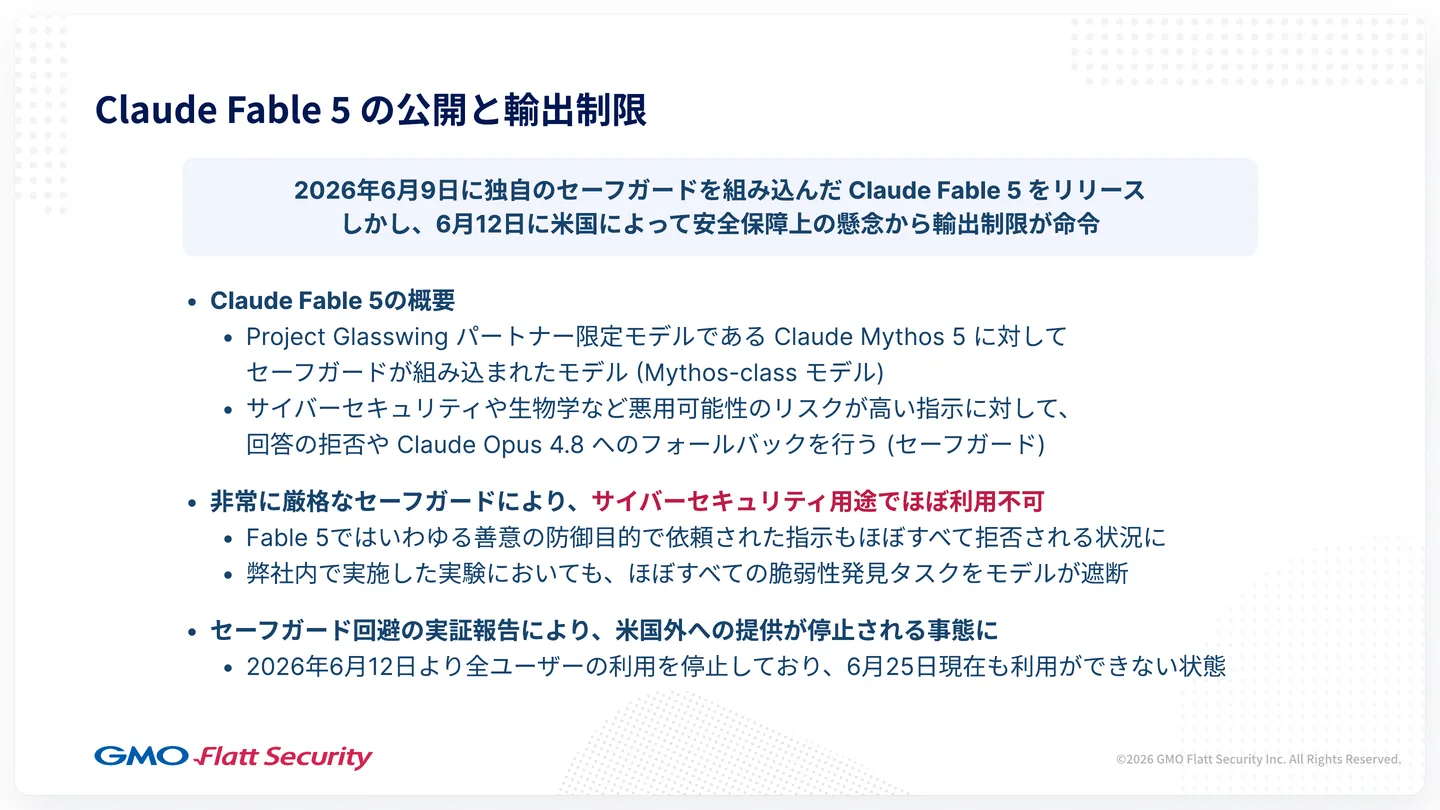
2026年6月9日、Anthropic は独自のセーフガードを組み込んだ Claude Fable 5 をリリースしました。Project Glasswing のパートナーに限定して配布されていた Mythos 5 にセーフガードを加えた、Mythos と同等の能力を持つとされるモデルです。セーフガードは、サイバーセキュリティや生物学など、悪用されたときのリスクが高い指示に対して、回答を拒否したり、Claude Opus 4.8 のような能力の低いモデルにフォールバックしたりする仕組みです。
このセーフガードは非常に厳格で、善意の防御のためのタスクも含め、サイバーセキュリティの用途ではほぼすべて拒否されていました。弊社が公開の直後に行った実験でも、脆弱性を見つけるタスクや直すタスクは、ほぼすべてモデルに遮断されました。
その後、特定の手法でセーフガードを回避できるという報告があったことなどから、6月12日に米国が安全保障上の懸念を理由に、外国籍の人の利用を止める輸出の制限を命じ、Anthropic は Claude Fable 5 と Claude Mythos 5 の提供をすべての利用者に対して停止しました。最先端のモデルでも、セーフガードの厳しさや提供の停止によって、防御の用途に使えるとは限りません。
Claude Mythos のベンチマーク上の進歩は漸進的なものにとどまる
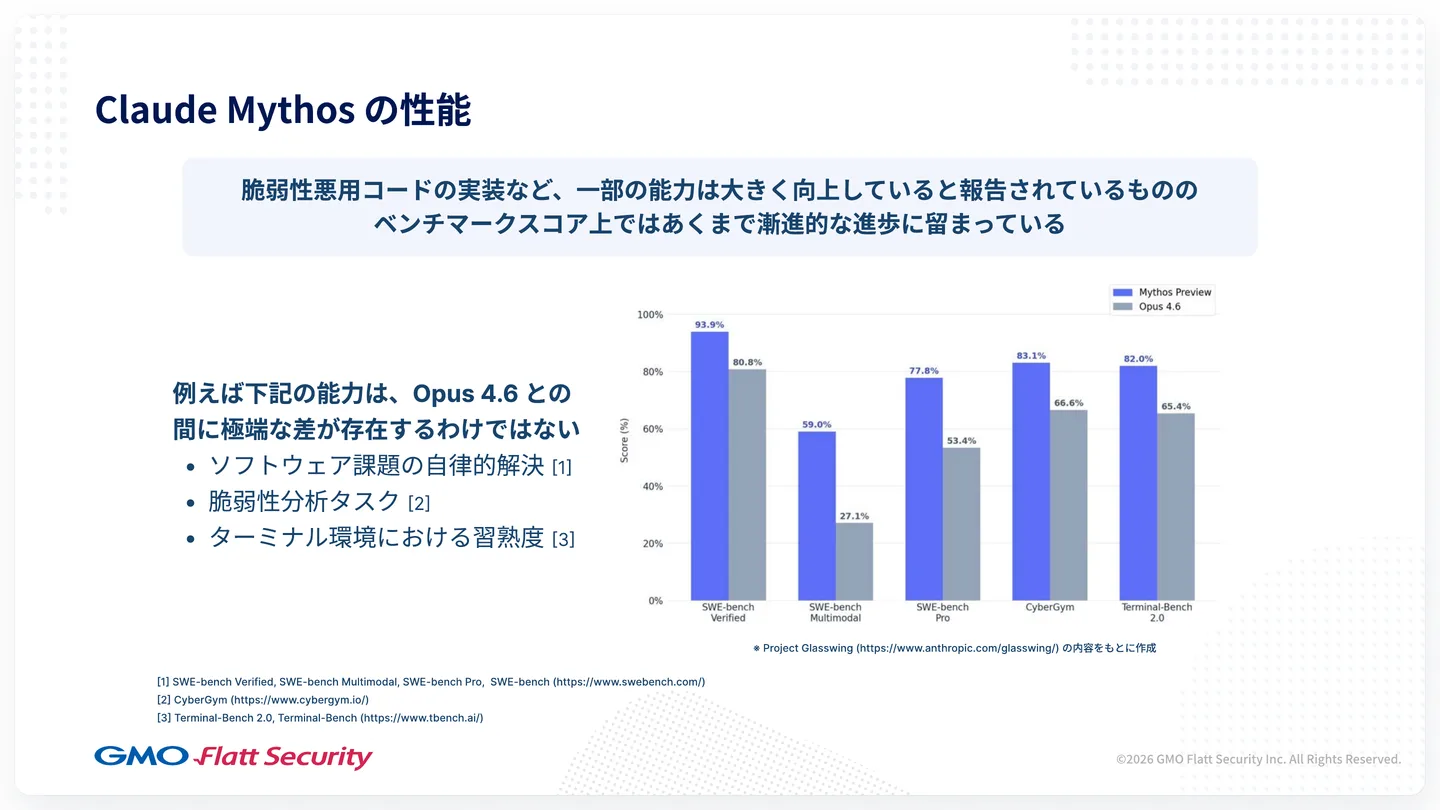
Claude Mythos の性能を見ると、脆弱性の悪用コードの実装など一部の能力は大きく向上したと報告されているものの、ベンチマークのスコアの上では、急に伸びたというより、あくまで漸進的な進歩にとどまっています。Mythos Preview と Opus 4.6 を比べると、ソフトウェアの課題の自律的な解決(SWE-bench)、脆弱性の分析(CyberGym)、ターミナル環境の操作(Terminal-Bench)のスコアは、Mythos Preview のほうが高いものの、極端に大きな差があるわけではありません。
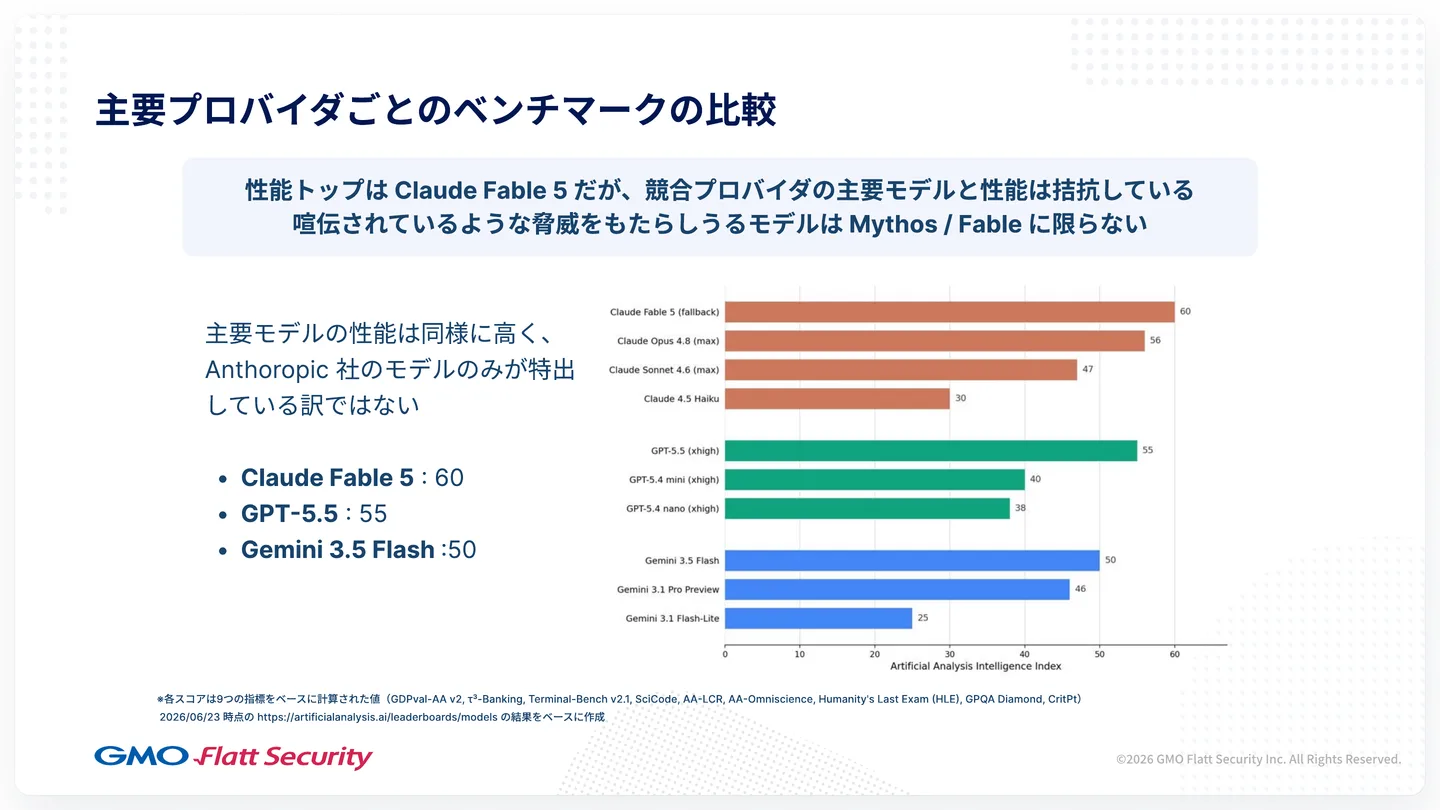
主要なプロバイダのモデルを比べると、性能のトップは Claude Fable 5 ですが、競合するプロバイダのフラッグシップのモデルと性能は拮抗しています。2026年6月23日の時点の Artificial Analysis の指標では、Claude Fable 5 が60、GPT-5.5 が55、Gemini 3.5 Flash が50でした。こうしたモデルについて伝えられているような脅威は、Mythos や Fable に限らず、競合するプロバイダのモデルによってももたらされえます。
Claude Mythos だけが特に優れているわけではないという評価もある
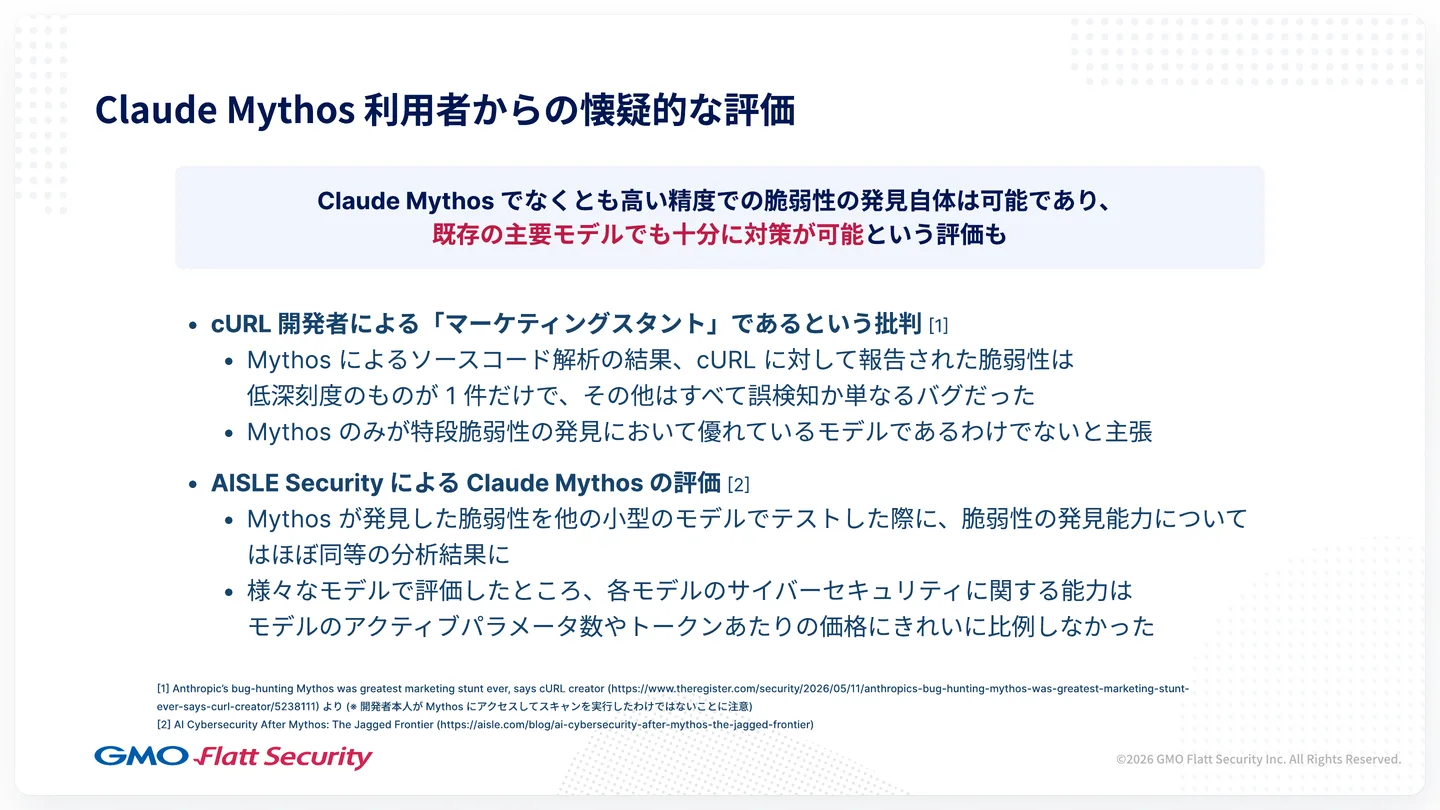
一方で、懐疑的な評価もあります。cURL の開発者は、Mythos を「マーケティングスタント」だと批判しました。Mythos によるソースコードの解析で cURL に報告された脆弱性は、低い深刻度のものが1件だけで、ほかは誤検知かバグだったとしています。ほかのモデルでも脆弱性の検出は可能だったとして、脆弱性の発見において、Mythos だけが特に優れたモデルではない、という主張です。ただし、開発者本人が Mythos を使ってスキャンしたわけではない点には注意が要ります。
AISLE Security は、著名な OSS で長年見つかっていなかった脆弱性を Mythos が見つけたという事例を取り上げ、同じ脆弱性をほかの安価で小型のモデルで試しました。適切な指示を与えれば、脆弱性を見つける能力はほぼ同等だった、という分析です。さまざまなモデルを評価した結果として、サイバーセキュリティ、特に脆弱性の発見に関する能力は、モデルのパラメータの数やトークンあたりの価格にきれいに比例するわけではなく、既存の主要なモデルでも高い精度で脆弱性を見つけることは十分に可能だ、という評価も示しています。
先端モデルを活かすにはハーネスとパイプラインが必要
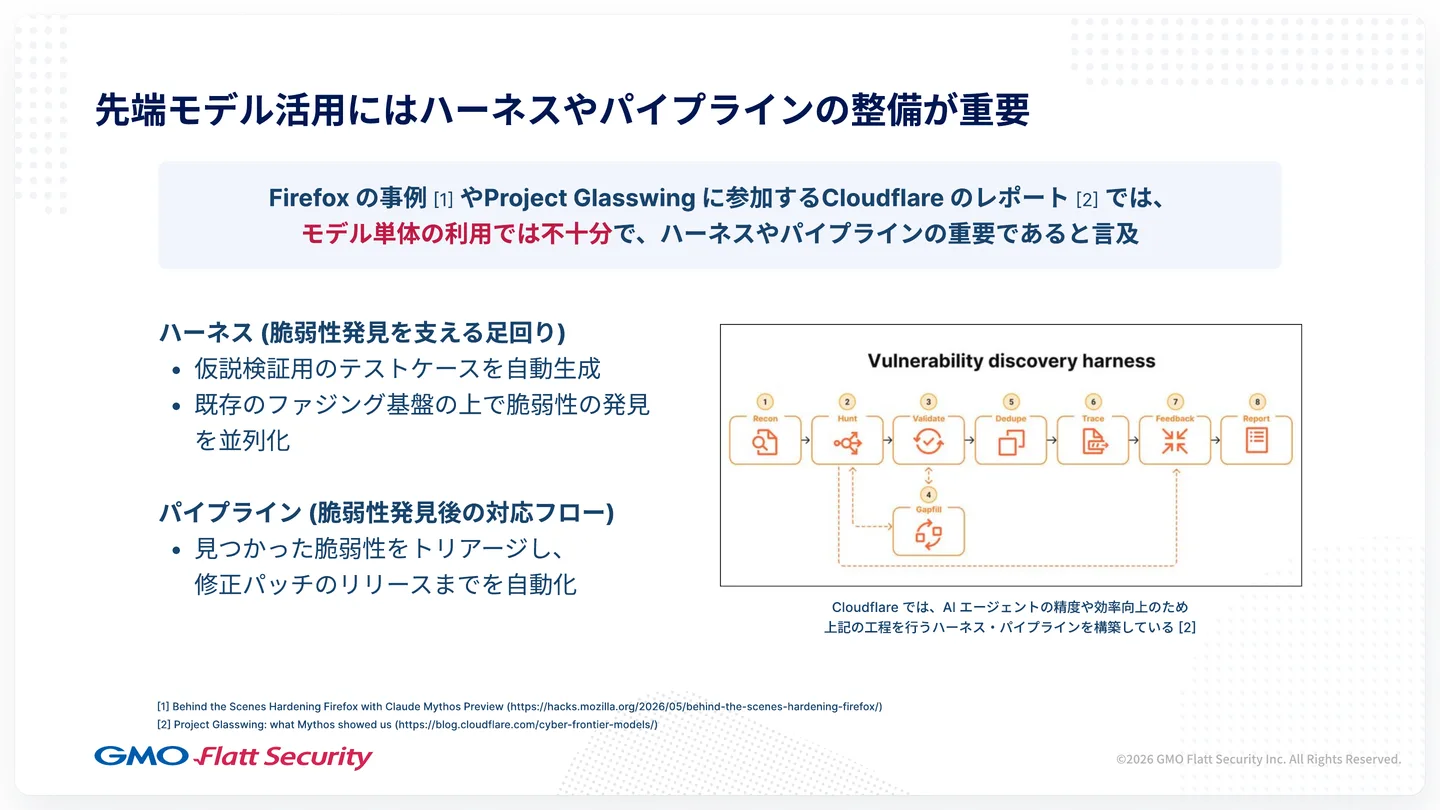
Mozilla の Firefox の事例や、Project Glasswing に参加する Cloudflare のレポートでは、モデルを単体で使うだけでは不十分で、ハーネスとパイプラインが重要だと述べられています。ハーネスは、脆弱性の発見を支えるツールや仕組みのことです。パイプラインは、脆弱性を見つけたあとの対応の流れ、つまり見つかった脆弱性にどう対応していくかの流れのことです。
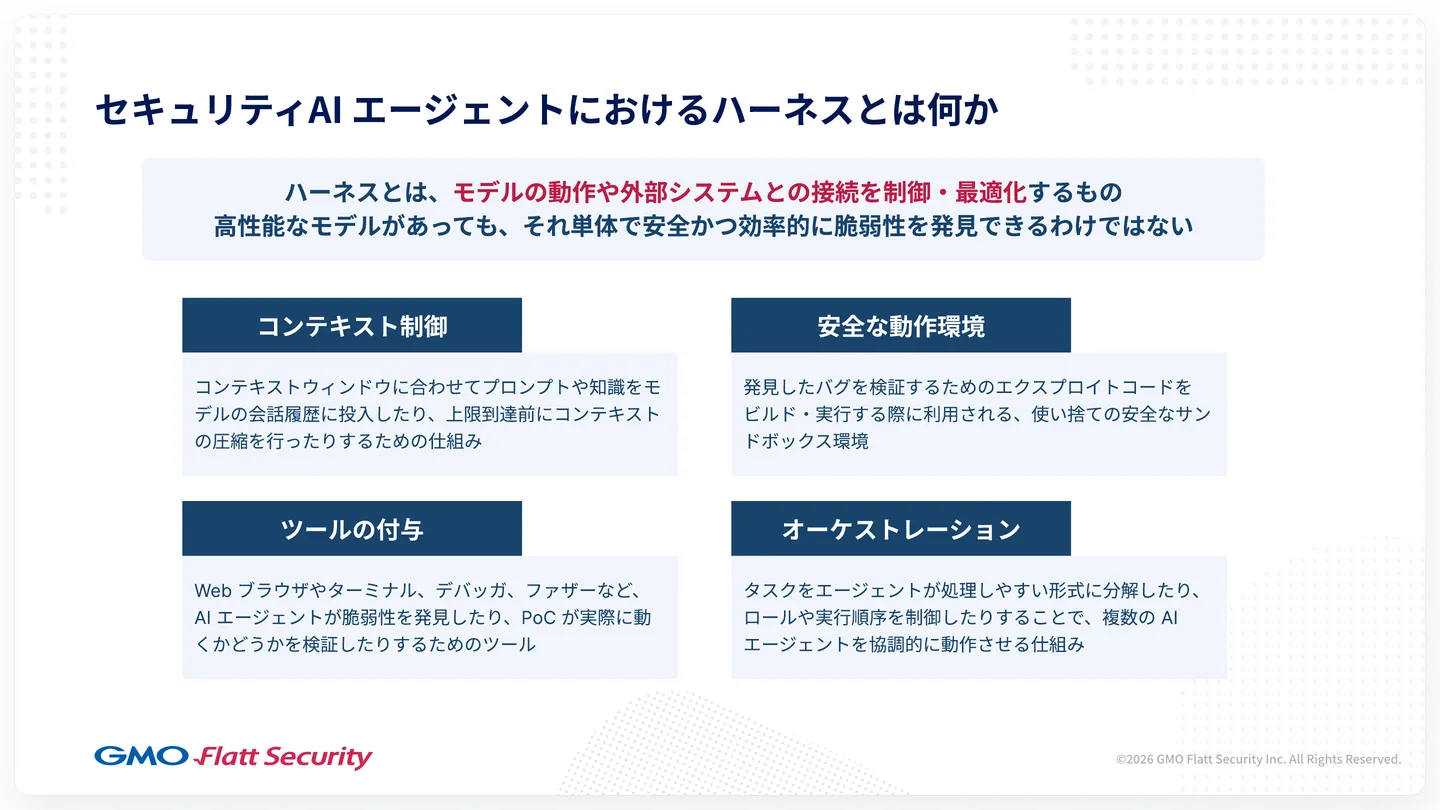
具体的には、ハーネスは、モデルそのものの動作や、外部のシステムとの接続を制御し、最適化します。高性能なモデルがあっても、それ単体で安全かつ効率的に脆弱性を見つけられるわけではありません。ハーネスには、大きく4つの種類があります。
- コンテキストの制御: モデルのコンテキストウィンドウに合わせて、プロンプトや知識をモデルの会話に投入したり、上限に達する前にコンテキストを圧縮したりして、継続して動けるようにします
- ツールの付与: コードを読む、Web にアクセスする、アプリケーションに直接アクセスするために、ブラウザ、コマンドを実行するターミナル、デバッガなどのツールを持たせます
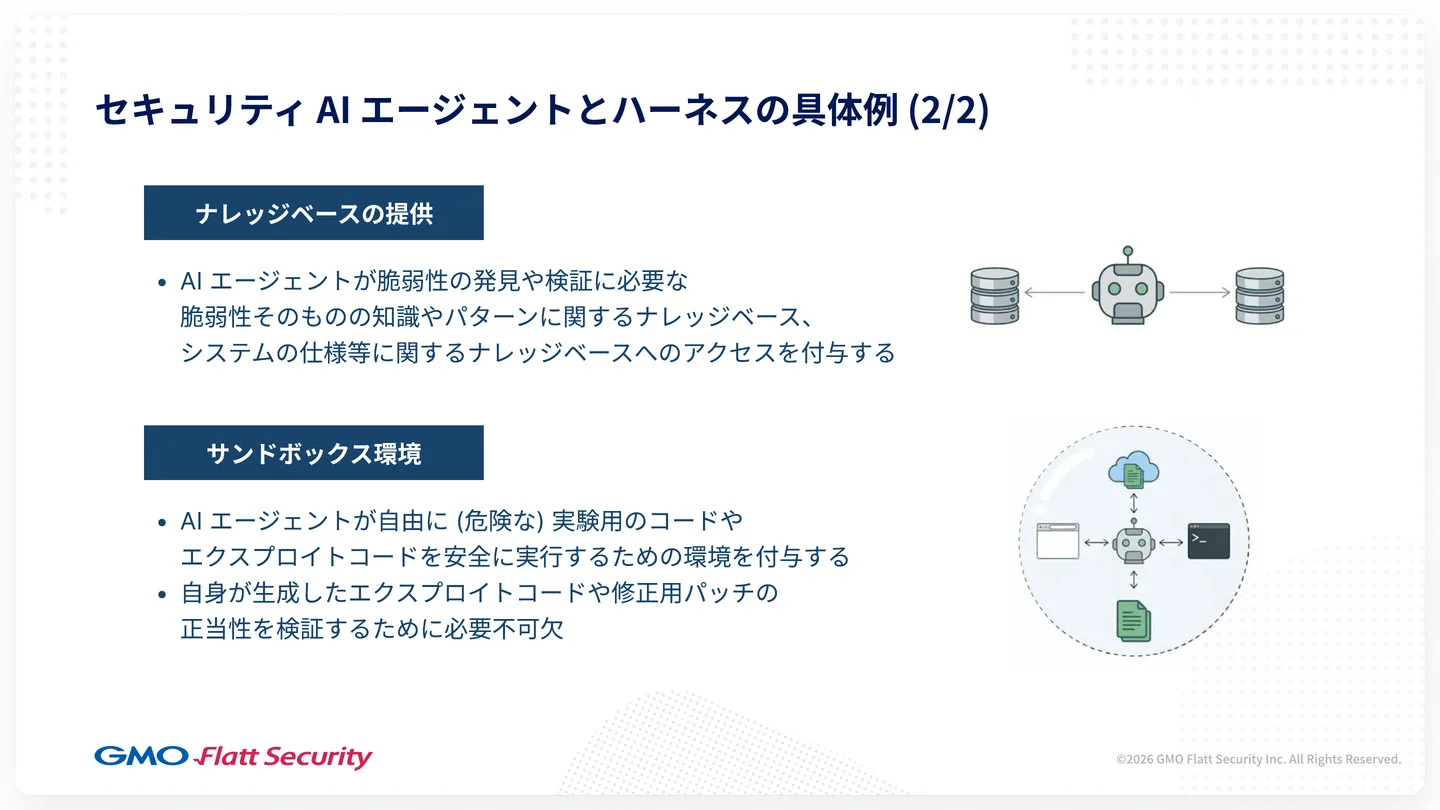
- 安全な動作環境: 見つけたバグを検証するために危険なコードをビルドして実行できる、安全に使い捨てできるサンドボックス環境を用意します
- オーケストレーション: 大きく抽象的なタスクを、複数のエージェントが処理しやすい形に分解したり、エージェントごとの役割や実行の順序を制御したりして、AI エージェントを協調させて動かします。最近の高性能なモデルでは、タスクの自律的な遂行に関する能力が大きく向上していることから、出番は減っています
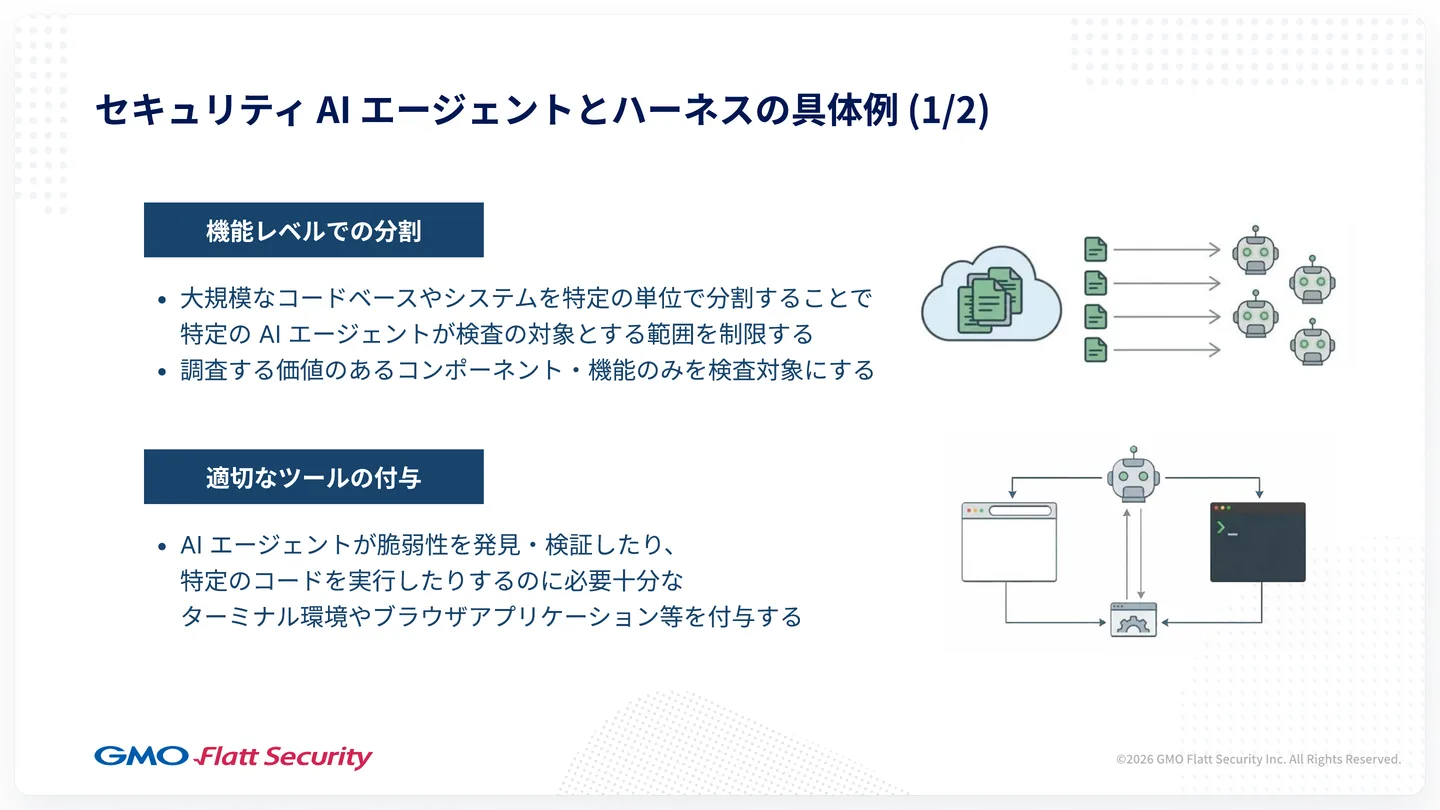
セキュリティの AI エージェントでは、ツールの付与とサンドボックス環境に加えて、次の2つが要ります。
- 機能の単位での分割: アプリケーションのコードベースは基本的に大規模で、全体をそのまま診断してほしいと AI エージェントに頼むのは、規模の面でかなり難しいものです。システムの構造や機能を特定の単位で分割して検査の対象を絞り、調査する価値のあるコンポーネントや機能だけを検査します
- ナレッジベースの提供: 脆弱性そのものの知識や、システムの仕様上どのようなものが脆弱性になりうるかという判断の根拠を与えるため、ナレッジベースにアクセスできるようにします
既存の主要なモデルでも、脆弱性の対策には十分な能力があります。そのうえで、モデルを単体で使うだけでは足りず、こうしたハーネスの整備が非常に重要になると考えています。
脆弱性の発見に人の確認と修正が追いつかなくなる
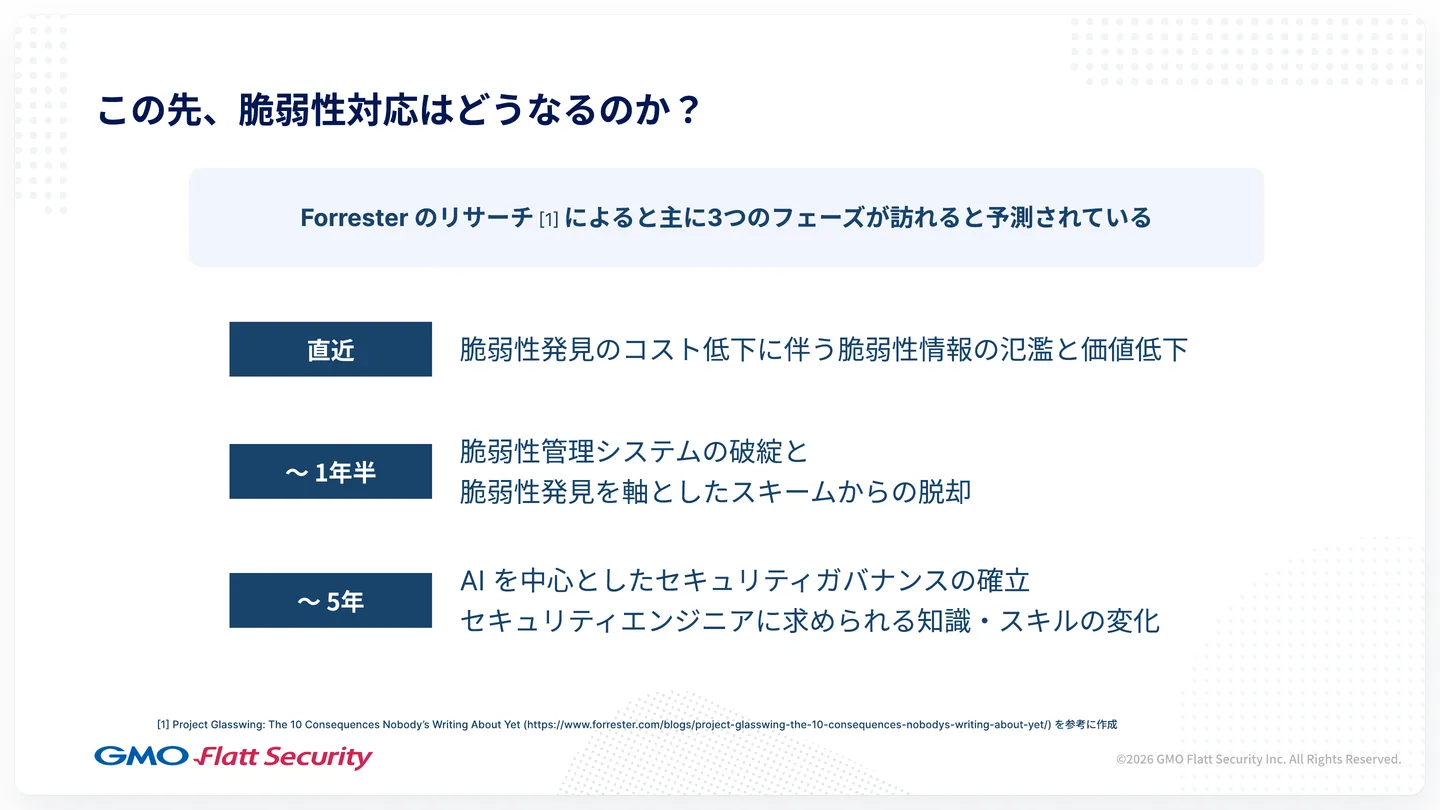
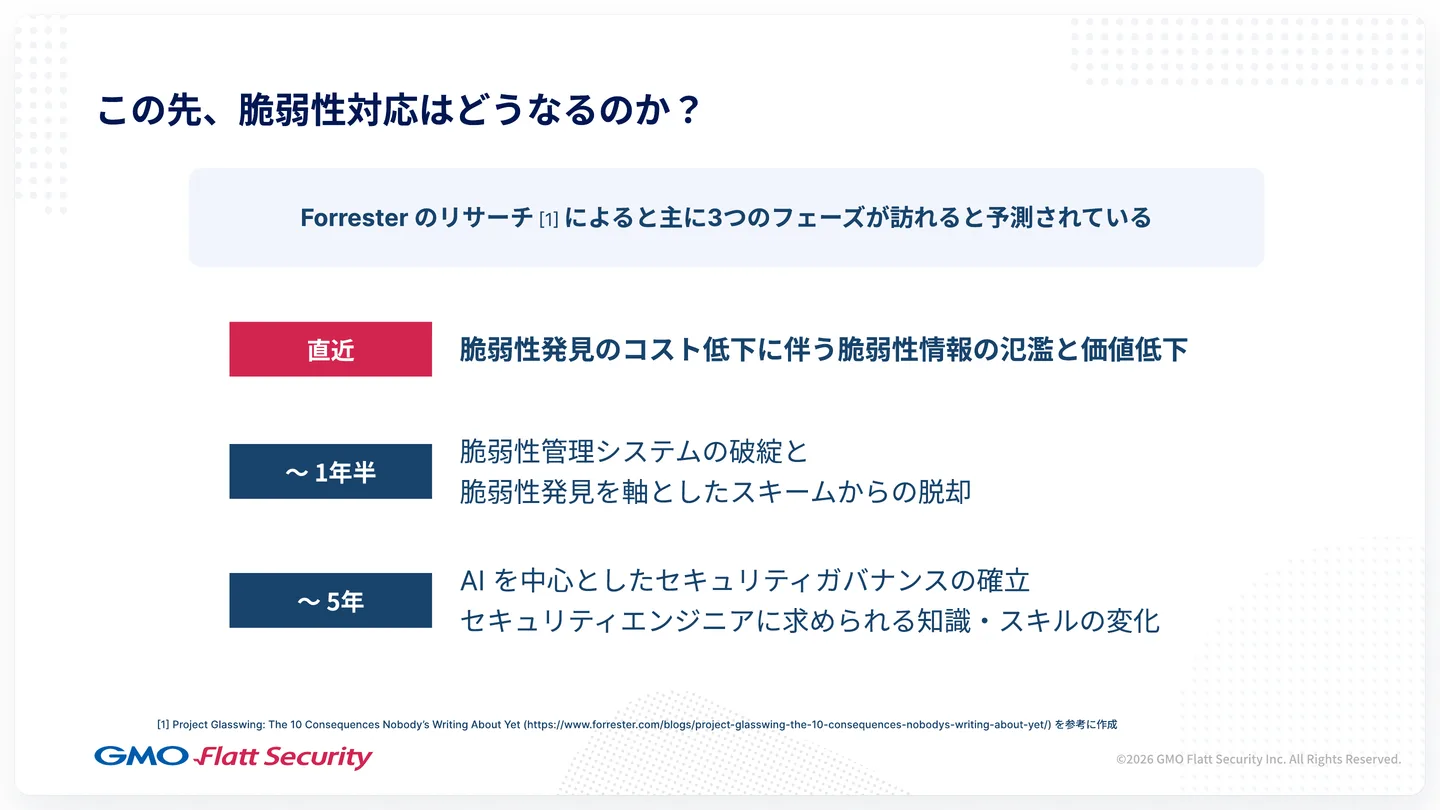
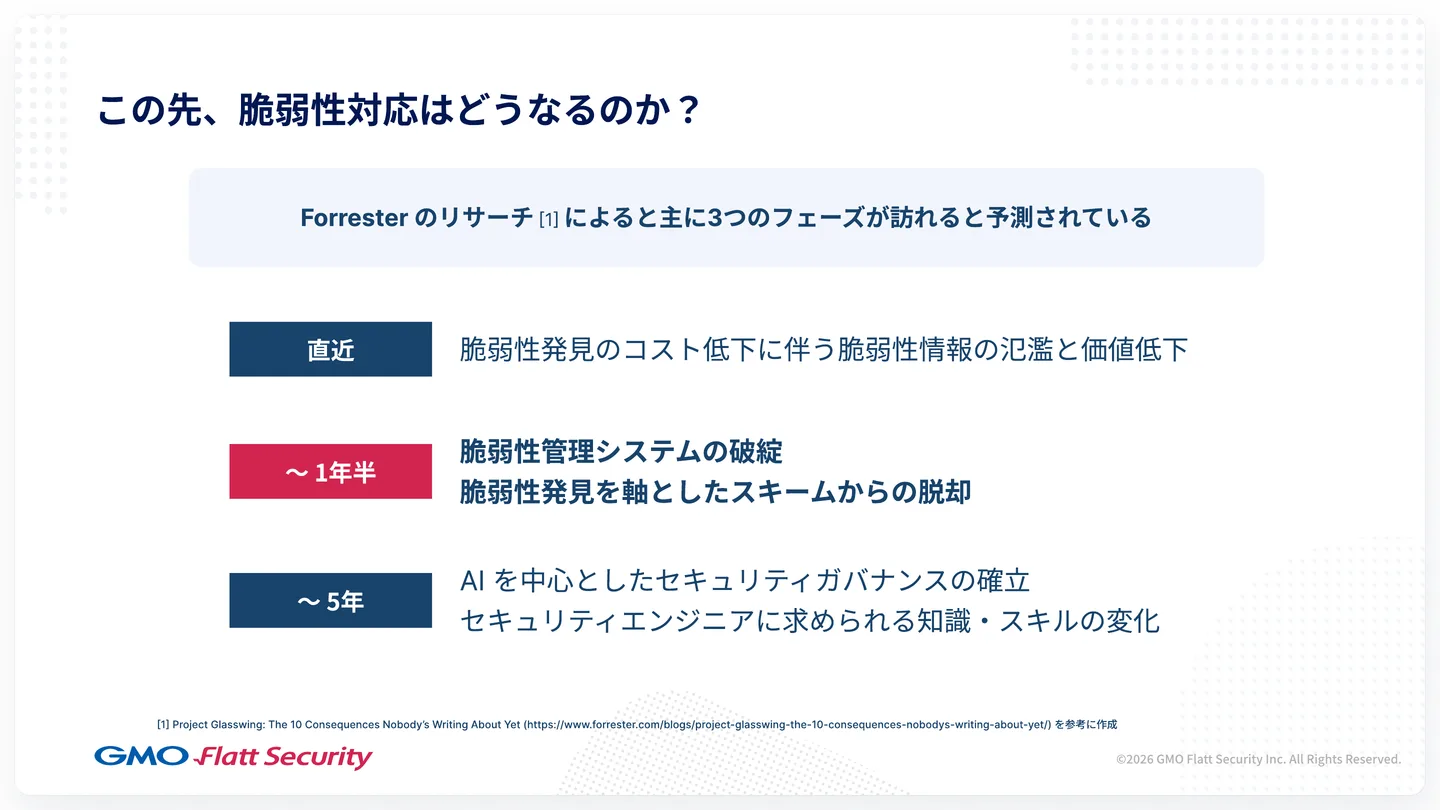
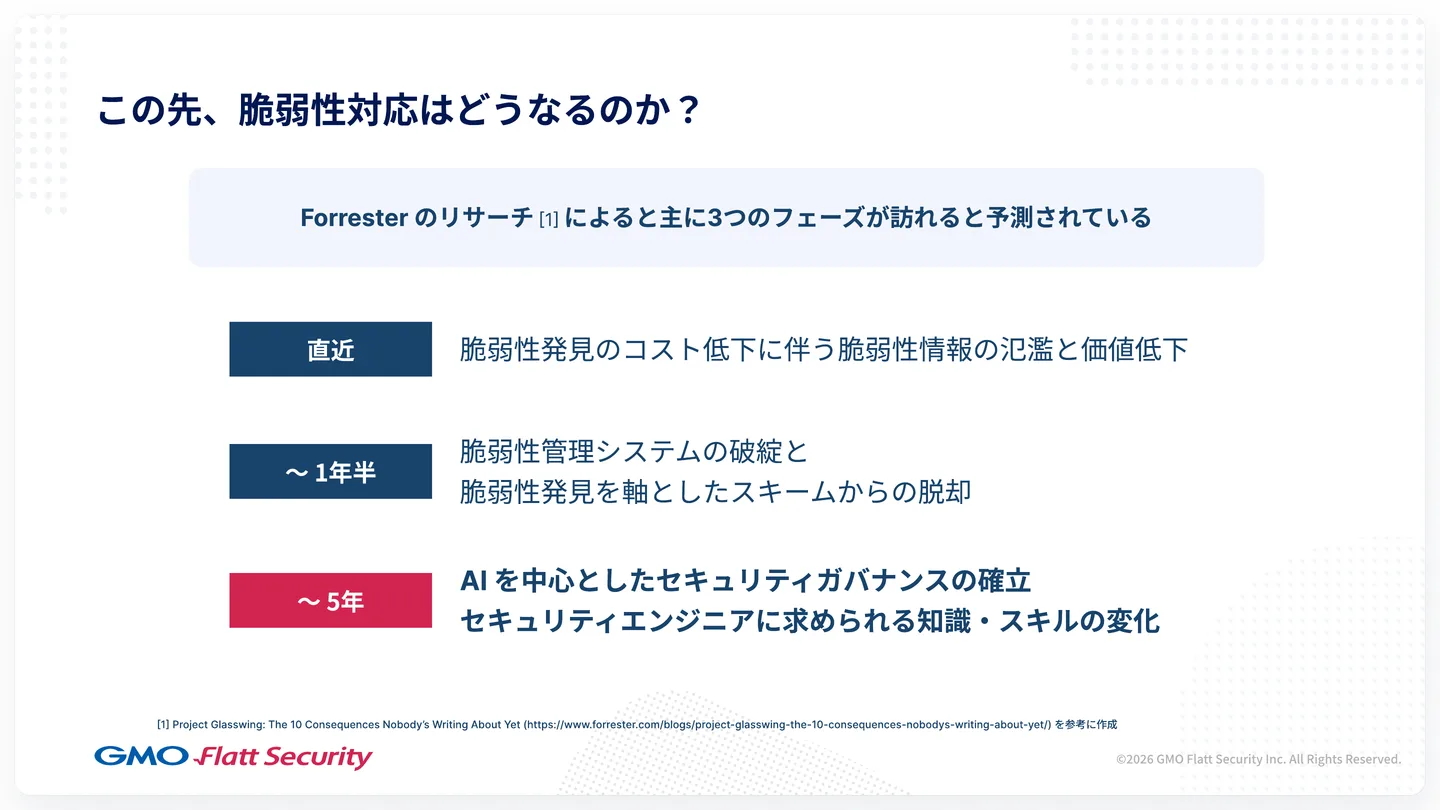
Forrester は、今後の脆弱性対応についてのリサーチを公表しており、直近、1年半ほど先まで、5年ほど先までの3つの段階で変化が起こると予測しています。
直近では脆弱性情報があふれ、その価値が下がる
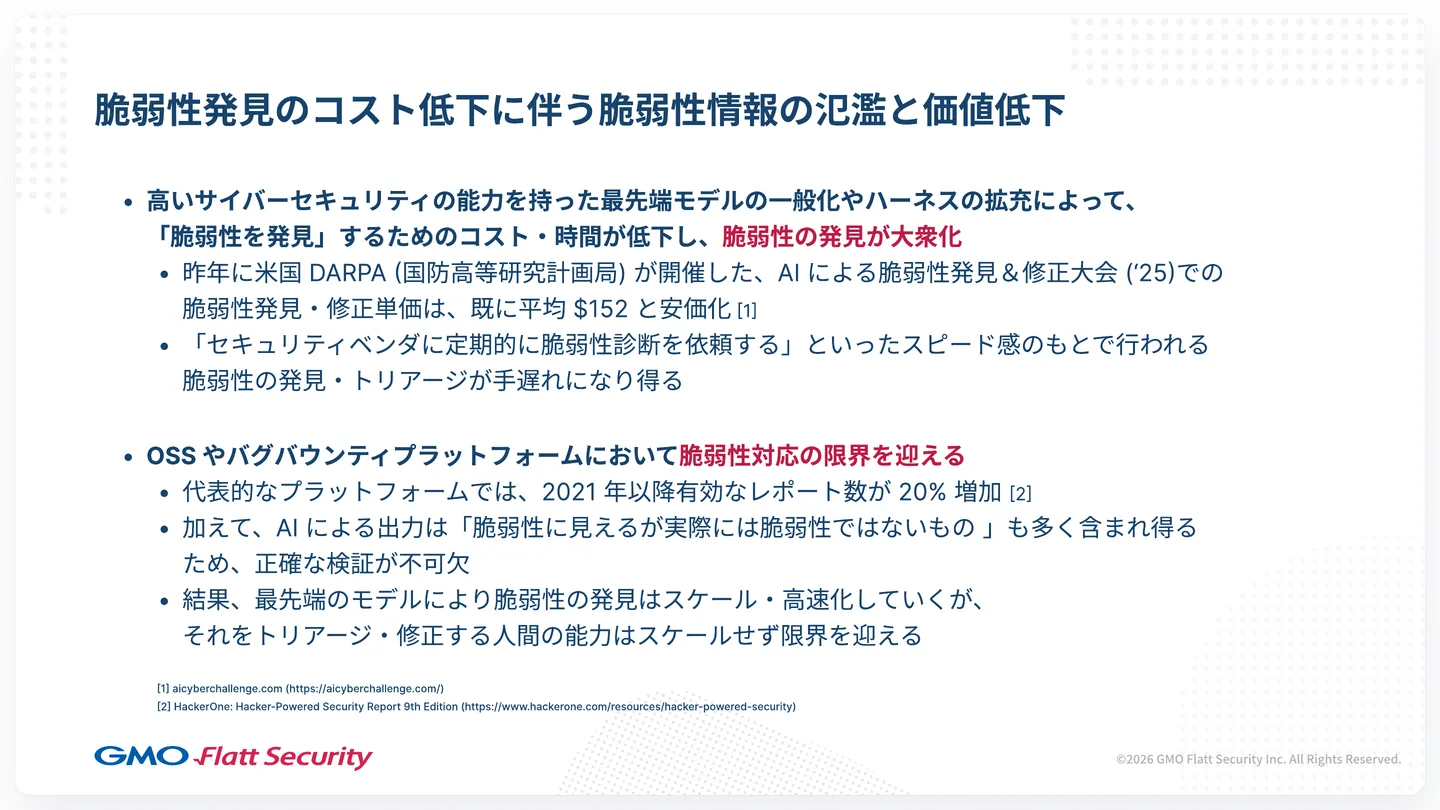
高いサイバーセキュリティの能力を持つ最先端のモデルが一般化し、それをうまく動かすためのハーネスも整備・拡充されてきたことで、脆弱性を見つけるためのコストと時間は大きく下がり、脆弱性の発見は大衆化(コモディティ化)していると言えます。2025年に米国の DARPA(国防高等研究計画局)が一定の期間開催した、AI による脆弱性の発見と修正を競う大会では、脆弱性の発見と修正が、すでに平均152ドルという非常に安価な単価で、高速に行われていました。この事実を踏まえると、セキュリティベンダーに年に1回など定期的に脆弱性診断を依頼するという、既存の脆弱性診断の基本的なやり方の速さでは、脆弱性の発見も、見つかった脆弱性を確かめて優先づけするトリアージも、手遅れになりえます。
OSS やバグバウンティのプラットフォームでは、脆弱性への対応がキャパシティを超えています。代表的なバグバウンティのプラットフォームでは、2021年以降、有効なレポートの数が20%増えました。最近は、AI で脆弱性を見つけて AI にレポートを書かせることが一般化していますが、その出力には、一見脆弱性に見えて実際は関係のないただの不具合だったり、完全なハルシネーションだったりするものも含まれるため、正確なレビューと検証が欠かせません。最先端のモデルによって発見とレポートの作成はスケールし高速化していく一方で、それをトリアージして直す人の能力は急にはスケールしないので、限界を迎えてキャパシティを超過した状態に陥っています。
1年半ほど先までに脆弱性の管理の仕組みが破綻する
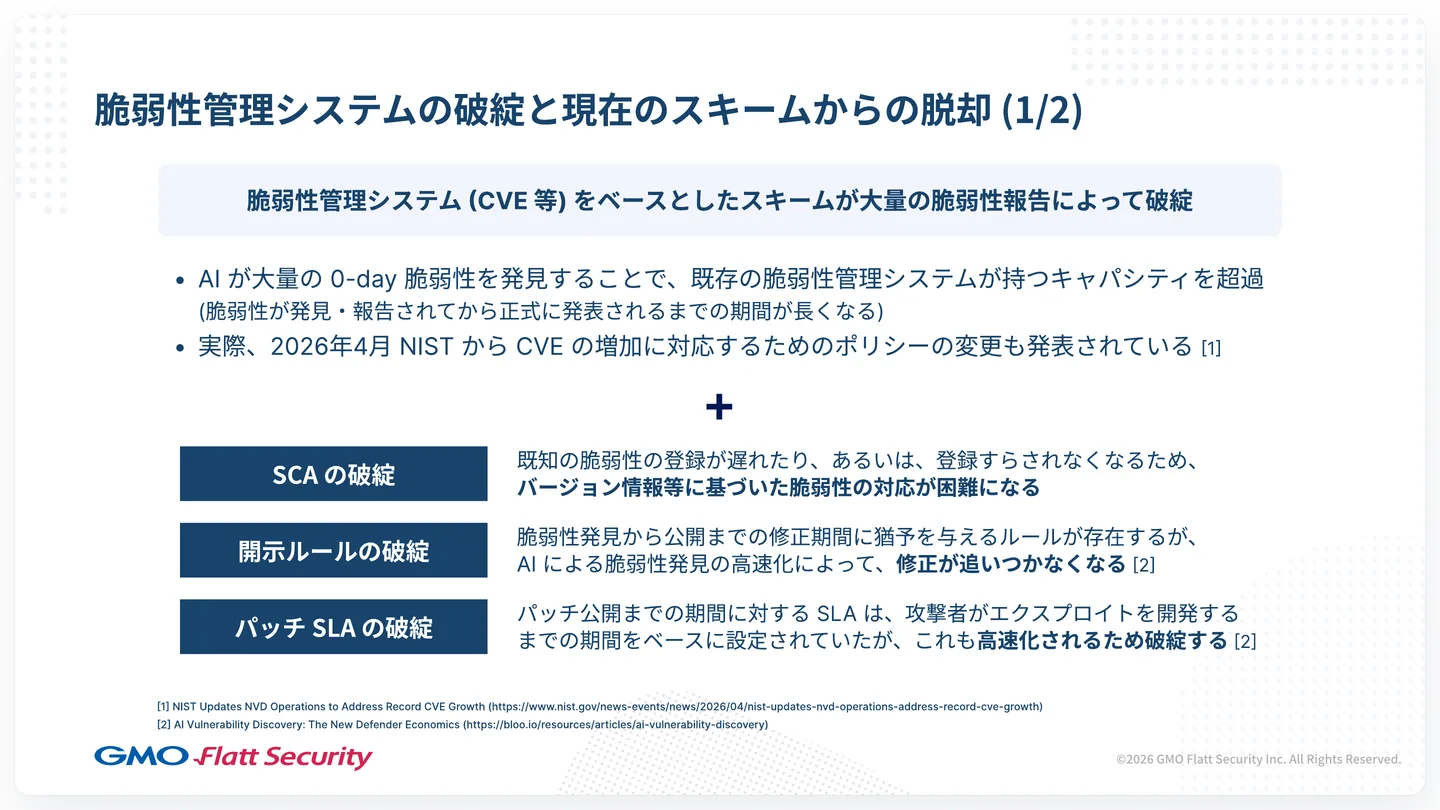
CVE などの既存の脆弱性管理の仕組みに基づくやり方は、大量の脆弱性報告がキャパシティを超えることで破綻すると考えられています。AI が大量のゼロデイの脆弱性を見つけることで、脆弱性を受け入れて検証し管理する既存の仕組みが持つキャパシティを完全に超えてしまいます。実際に、脆弱性を報告しても正式に公表されるまでの期間が非常に長くなったり、完全に無視されたりする事態が、すでに起きています。2026年4月には、脆弱性のデータベース NVD(National Vulnerability Database)を運営する米国国立標準技術研究所(NIST)が、CVE の報告の増加に対応するためのポリシーの変更を発表しています。
脆弱性の管理の仕組みが破綻すると、それに関連するルールやツールも破綻すると考えられます。
- SCA(ソフトウェア構成分析): 特定のソフトウェアのバージョンに特定の脆弱性があるので更新しましょう、という情報をもとに問題を抽出するツールです。既知の脆弱性の登録が遅れたり、登録すらされなくなったりすると、バージョンの情報をもとにした脆弱性の対応は難しくなります
- 開示のルールとパッチの適用期限: 多くの企業が採用している脆弱性の開示のルールや、パッチの適用までの期間の取り決めは、攻撃者が脆弱性の発見から攻撃の達成までに、エクスプロイトを書くなどの時間を要するだろうという予測をもとに設定されていました。最近のモデルはエクスプロイトの生成が非常に得意で、攻撃までの時間も短くなるので、一定の期間を置くというやり方が成り立たなくなります
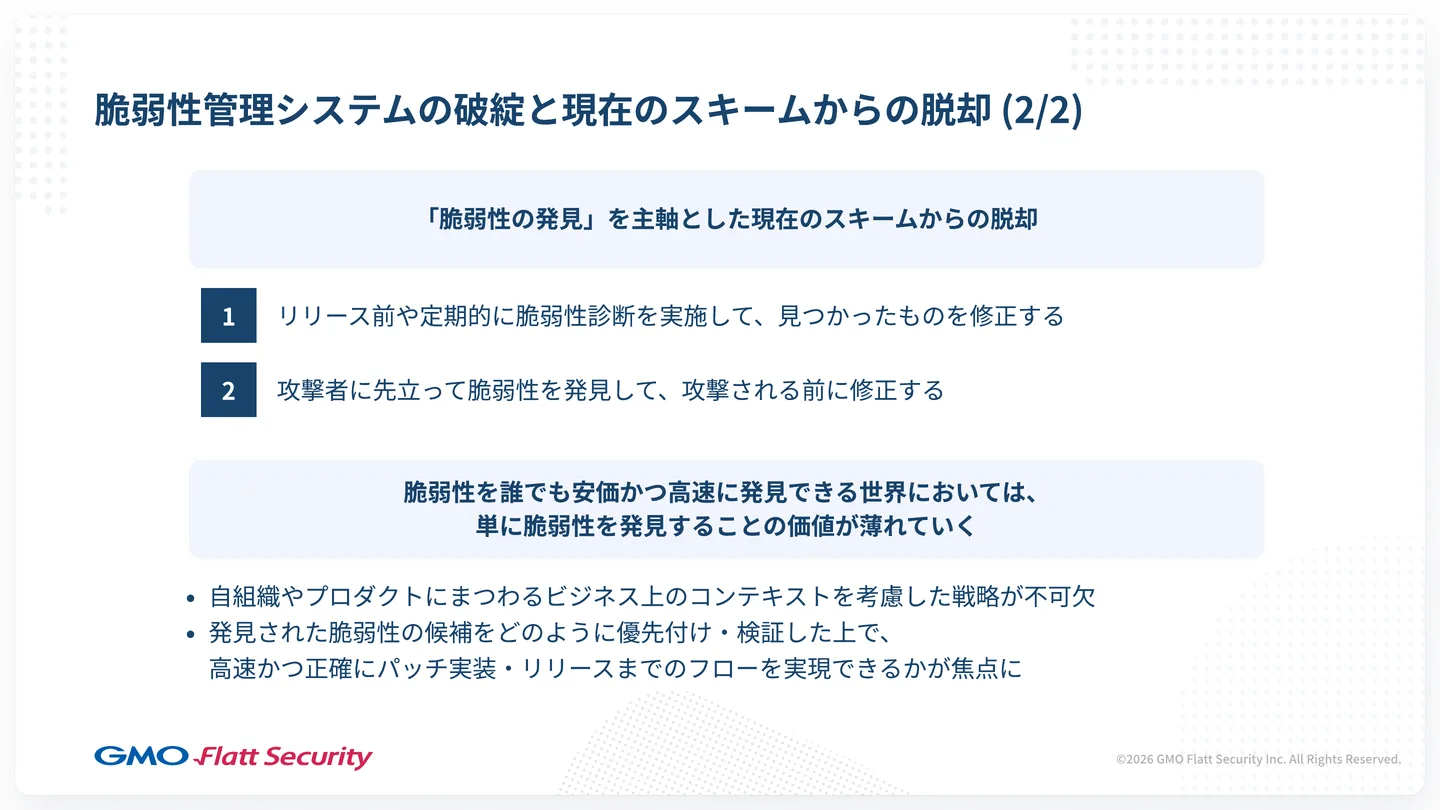
これに伴って、「脆弱性の発見」を主軸にした今のやり方からの脱却が起こると考えられます。今は、リリース前や定期的に脆弱性診断をして見つかった問題を直す、攻撃者に先立って脆弱性を見つけて攻撃される前に直す、というスタンスが一般的です。しかし、先進的な AI モデルによって脆弱性を誰でも安価かつ高速に見つけられる可能性のある世界では、単に事前に脆弱性を見つけることの価値は薄れていきます。自社の組織やプロダクトにまつわるビジネス上のコンテキストを考慮した戦略が不可欠になり、見つかった脆弱性をどう優先づけて検証し、パッチの実装からリリースまでの流れをどれだけ高速かつ正確に回せるかが、主な焦点になります。
5年ほど先までにセキュリティエンジニアの役割の重心が脆弱性の発見から意思決定へ移る
AI が脆弱性の発見や対応のパイプラインに組み込まれていくにつれて、AI を中心とするセキュリティ管理の決まりと体制が確立していきます。セキュリティエンジニアの役割も、脆弱性を見つけることから、見つかったレポートをどうトリアージするか、ビジネス上の戦略を踏まえてどんなセキュリティの戦略を練るか、といった意思決定へと重心が移ると予測されています。
攻撃者の目的は変わらなくても人数は増える可能性がある
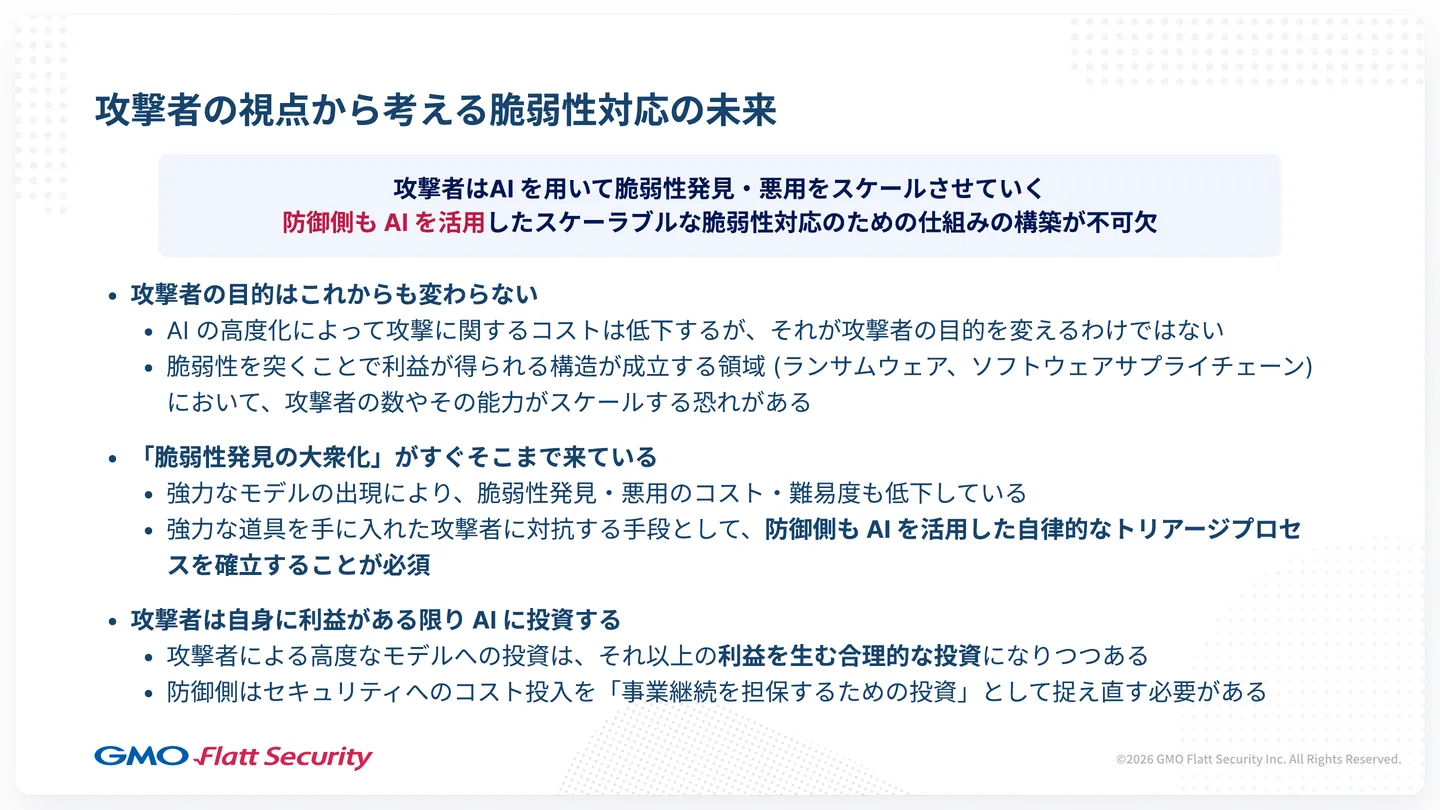
攻撃者はすでに、AI を用いて脆弱性の発見や悪用をスケールさせています。AI の高度化で、攻撃にかかる経済的・時間的なコストは下がりますが、攻撃者の目的そのものは、これからも変わりません。ただし、ランサムウェアやソフトウェアサプライチェーンのように、脆弱性を突くことで利益が得られ、スケールできる領域では、攻撃者の数や新たな参入者が増える可能性があります。
攻撃者は、自分に利益がある限り AI に投資すると考えられます。先進的なモデルはトークンあたりの単価も高いのですが、攻撃でそれ以上の利益が得られるなら、ビジネスとして成立し、合理的な投資になりつつあります。
脆弱性の発見は、誰にでもできるものになりつつあります。強力なモデルの出現で、脆弱性を見つけて悪用するためのコストと難易度は下がり続けています。強力な道具を手に入れた攻撃者に対抗する手段として、防御側も、AI を活用した自律的なトリアージを確立することが必須です。
AI 時代の脆弱性対応の3つの課題は脆弱性の増加・対応速度・優先づけ
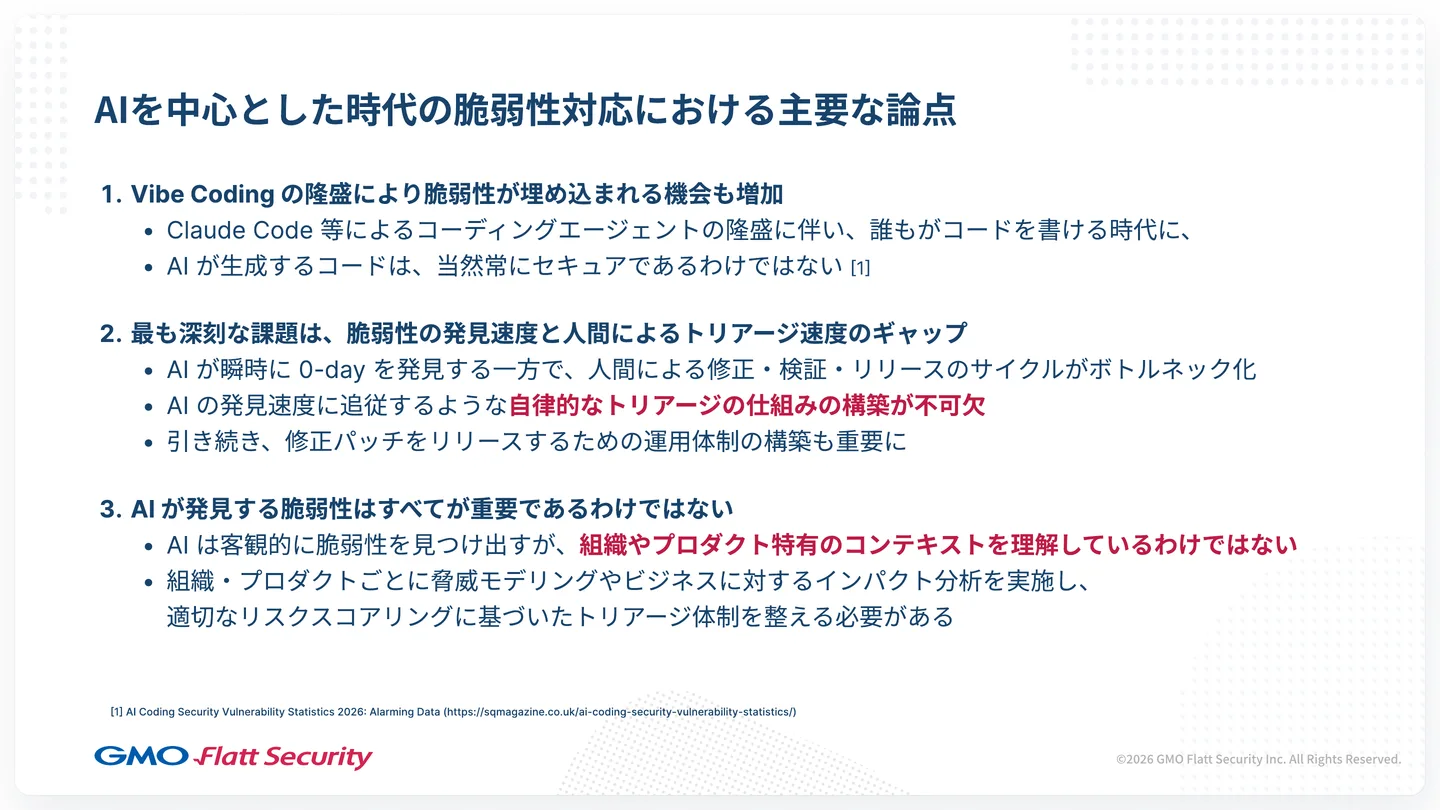
AI を中心にした時代の脆弱性の対応には、主に3つの論点があります。
1つ目は、AI に指示するだけでコードを書く Vibe Coding が広がり、脆弱性が埋め込まれる機会も増えることです。Claude Code などのコーディングエージェントによって、誰でもコードを書いてリリースできる時代になりました。しかし、AI が生成するコードが常にセキュアなわけではなく、一定の確率で脆弱性が含まれうるというリサーチもあります。
2つ目は、最も深刻な課題である、脆弱性の発見の速さと、人によるトリアージの速さのギャップです。AI が瞬時にゼロデイを見つける一方で、人が修正し、検証し、リリースするサイクルにはどうしても時間がかかり、そこがボトルネックになります。AI の発見の速さに追従する自律的なトリアージの仕組みを作ることと、修正のパッチを高速にリリースするための運用の体制を作ることが、ますます重要になります。
3つ目は、AI が見つける脆弱性が、すべて自社にとって重要なわけではないことです。AI は客観的な基準で脆弱性を見つけ出すことが大半です。そのため、組織やプロダクトごとに、ビジネスへのインパクトを踏まえてリスクを評価しておき、それに基づいてトリアージの体制をとる必要があります。
人が脆弱性を確認して直す流れのままでは手遅れになる可能性がある
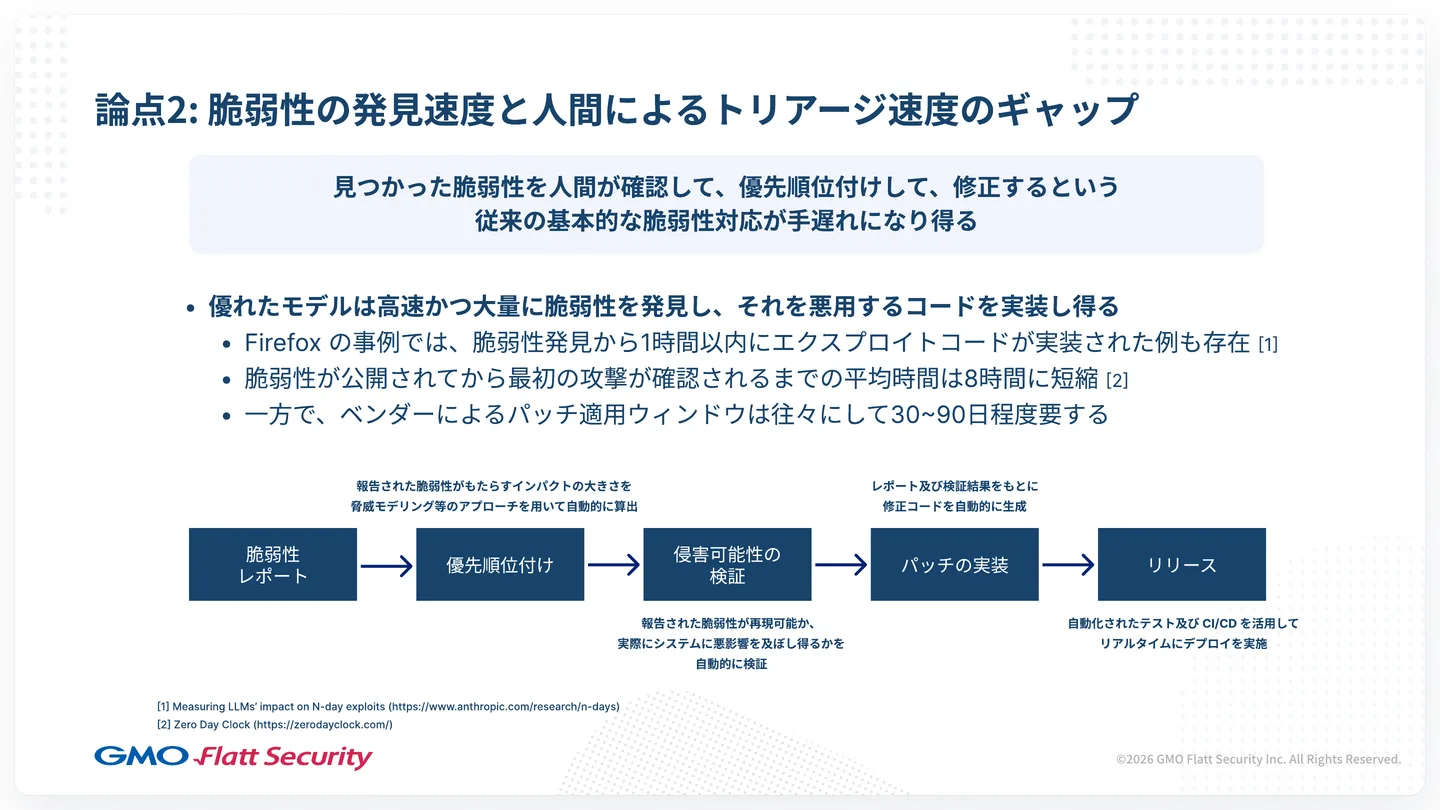
優れたモデルは、高速かつ大量に脆弱性を見つけ、それを悪用するコードまで実装できます。Firefox の事例では、脆弱性が見つかってから1時間以内にエクスプロイトのコードが実装された例もあります。脆弱性が公開されてから最初の攻撃が確認されるまでの平均の時間は、8時間に短縮されたというリサーチもあります。一方で、ベンダーがパッチを適用するまでの期間は、1か月から3か月ほどかかることが大半です。見つかった脆弱性を人が確認し、優先づけし、修正するという従来の基本的な対応では、手遅れになりえます。
そのため、ボトルネックになりうる優先順位づけ、侵害の可能性の検証、それに基づくパッチの実装とリリースを、可能な限り高速かつ正確にどう成立させるかが、今後の重要な論点になると考えています。
脆弱性対応の優先順位は自社の重要資産と侵害シナリオを踏まえて決める
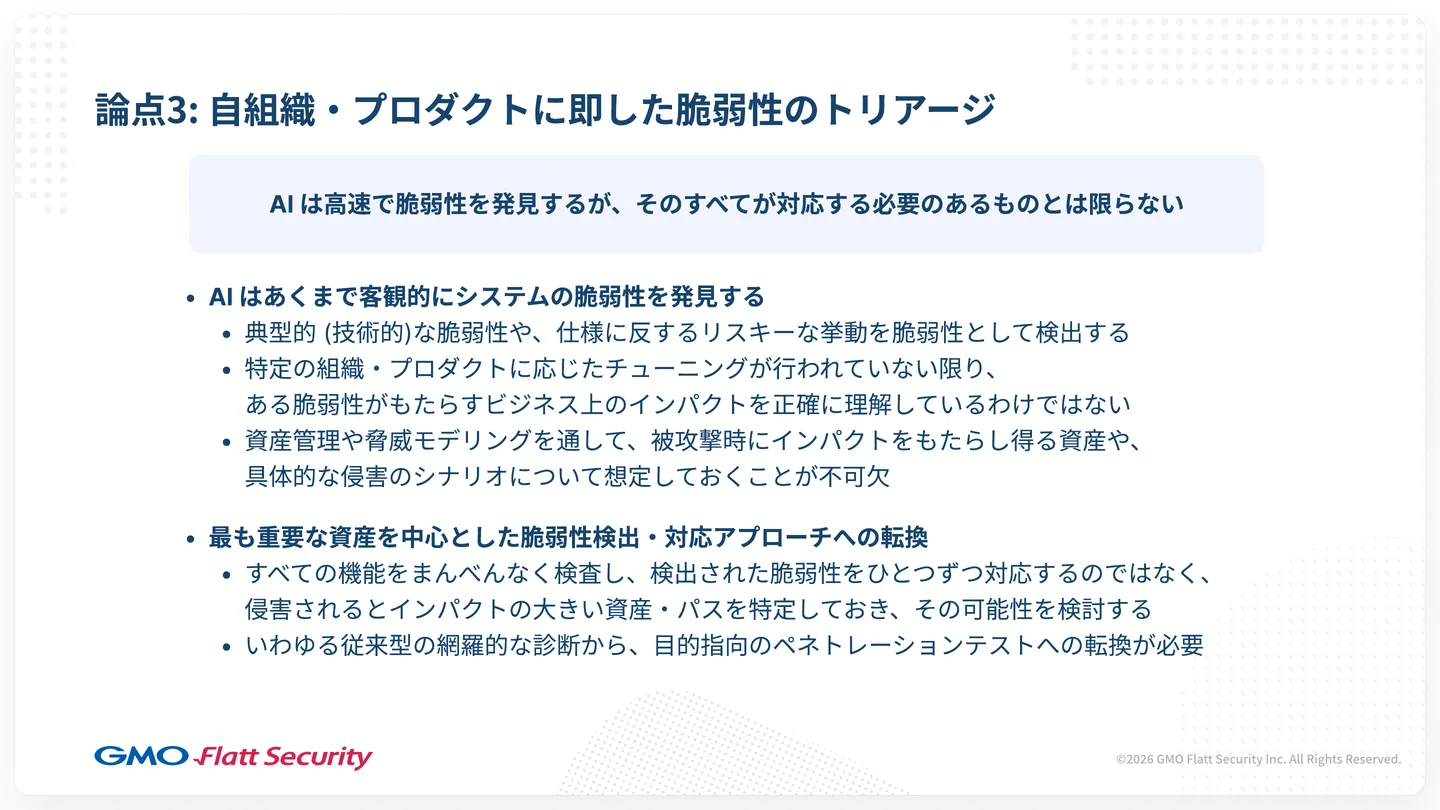
AI は、典型的で技術的な脆弱性の発見や、仕様に反するリスクのある挙動の検出が得意です。しかし、診断のために特別にチューニングされていない限り、組織やプロダクト特有のコンテキストや戦略、特定の脆弱性がもたらすビジネス上のインパクトを、正確に理解しているわけではありません。そのため、事前に資産管理や、起こりうる脅威を洗い出す脅威モデリングを通して、ある攻撃がもたらしうるインパクト、そのインパクトをもたらす対象の資産、具体的な侵害のシナリオを想定しておくことが不可欠です。
このような状況では、最も重要な資産を中心にした脆弱性の検出と対応のアプローチへの転換も有効だと考えています。すべての機能をまんべんなく検査して網羅的に1つずつ対応するのではなく、侵害されるとインパクトの大きい資産や経路を特定しておき、その可能性を重点的に検討する、というものです。従来型の網羅的な診断も重要ですが、そこから一歩踏み出して、重要な資産に届く攻撃が成り立つかを確かめる、目的指向のペネトレーションテストへ転換することが重要になると考えています。
防御側は AI を取り入れ、継続的な検証と被害の封じ込めを進める
技術面では継続的な検証と被害の封じ込めへ移行する
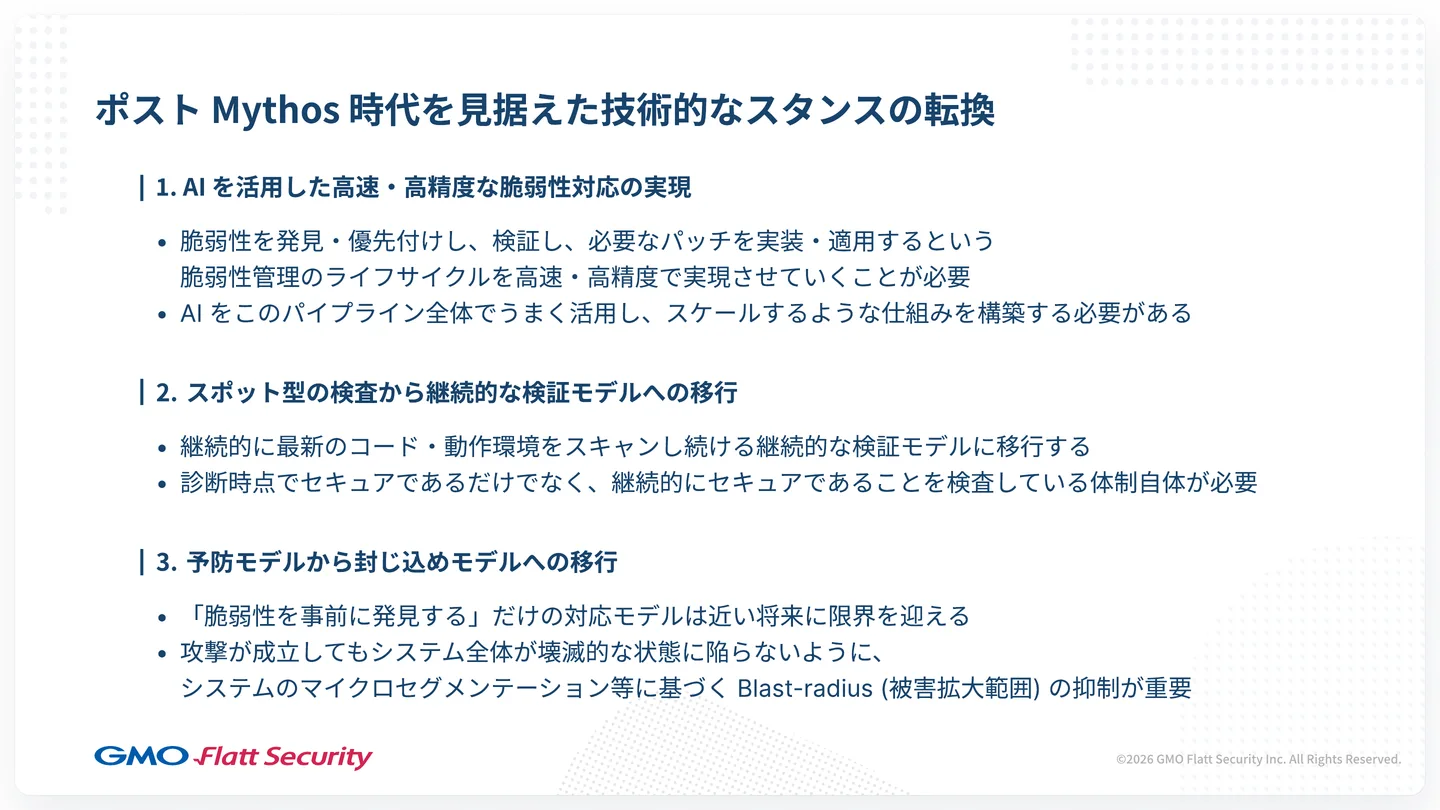
技術的なスタンスの転換には、大きく3つのトピックがあります。
- AI を活用した、高速・高精度な脆弱性対応の実現: 脆弱性を発見し、優先づけして検証し、必要なパッチを実装して適用するというライフサイクル全体を、高速かつ高精度に回していくことが必要です。人の手による対応にはやはり限界があるので、AI をはじめとする仕組みをパイプライン全体でうまく活用し、脆弱性の数が増えても回せるようにすることが必要になります。
- 定期的な検査から、継続的な検証モデルへの移行: 高性能なモデルによって、いつでも脆弱性を簡単に見つけられる状況が訪れると、定期的な診断の時点でセキュアだと保証するだけでは足りません。セキュアな状態が続いていることを、継続して検査する体制そのものが必要になります。最新のコードと動作環境をスキャンし続ける、継続的な検証モデルへ移ることが重要になると考えています。
- 予防モデルから、封じ込めモデルへの移行: 脆弱性を事前に見つけるだけの対応モデルは、近い将来に限界を迎えると考えられます。攻撃が成立しても、システム全体が壊滅的な状態に陥らないように、ネットワークのセグメントを小さく分ける、システム間の疎通を分割するといったマイクロセグメンテーションに基づいて、被害が広がる範囲を抑えることが重要です。
組織としてセキュリティ投資・人材の要件・対応体制を見直す
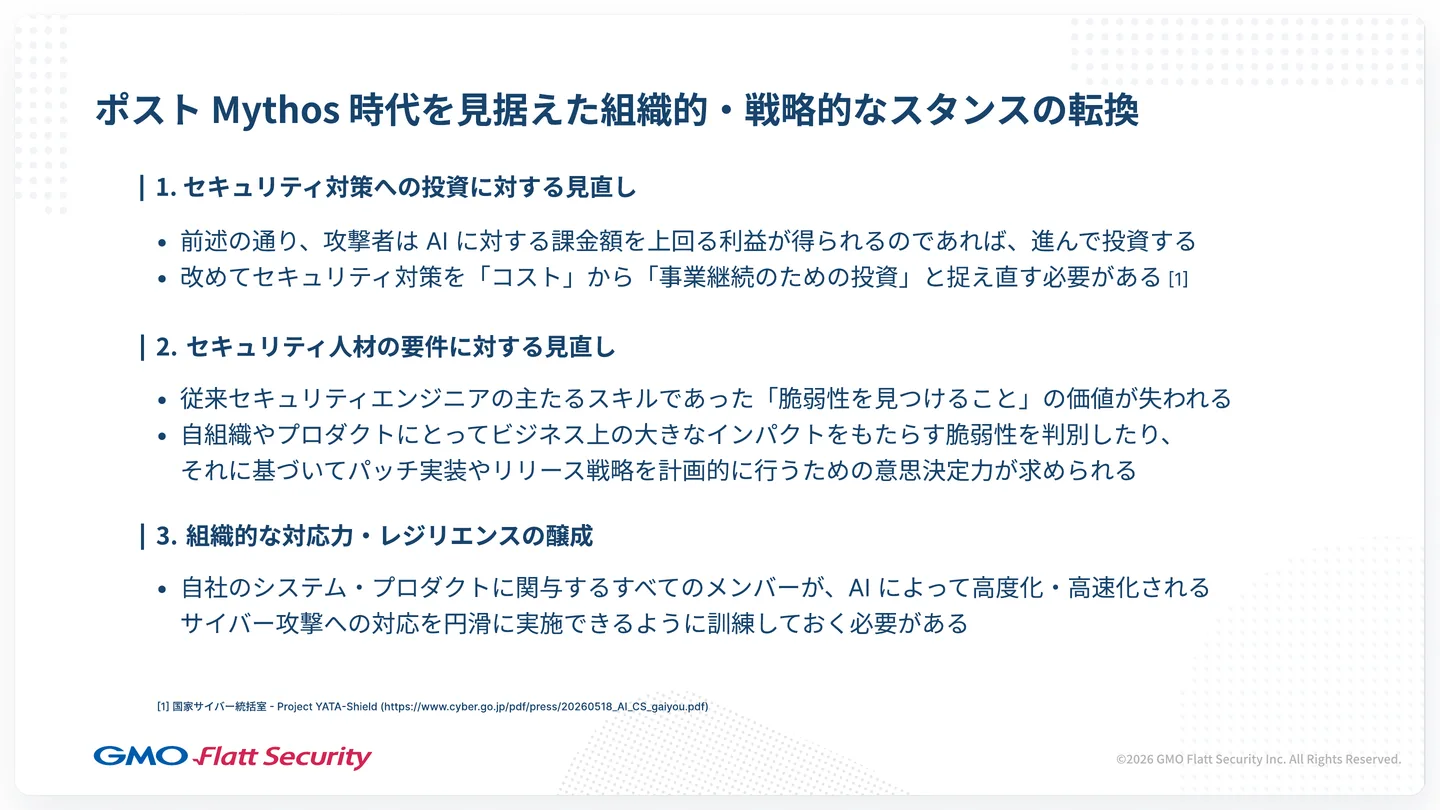
技術以外にも、組織的・戦略的なスタンスの転換が3つあります。
- セキュリティへの投資の見直し: 攻撃者が AI に進んで投資する一方で、防御側は、セキュリティへの支出をコストと捉えがちです。改めて、セキュリティ対策を「コスト」から「事業継続のための投資」と捉え直す必要があると考えています。
- セキュリティ人材の要件の見直し: 従来、セキュリティエンジニアの主なスキルは、脆弱性を見つけることや、それをどう直せばよいかを考えることでした。そうしたことの価値は失われつつあります。代わりに、自社の組織やプロダクトにとってビジネス上の大きなインパクトをもたらす脆弱性がどういうものかを事前に判別し、それに基づいてパッチの実装やリリースを高速かつ計画的に行うための、意思決定のスキルや能力が、今後大きく求められると考えています。
- 組織的な対応力(レジリエンス)の醸成: 攻撃が発生しても問題なくインシデントレスポンスができるように、事前に対応の体制を整え、戦略を組織の中で決めておくことが重要です。
Takumi byGMO で脆弱性の発見から検証・修正まで対応する
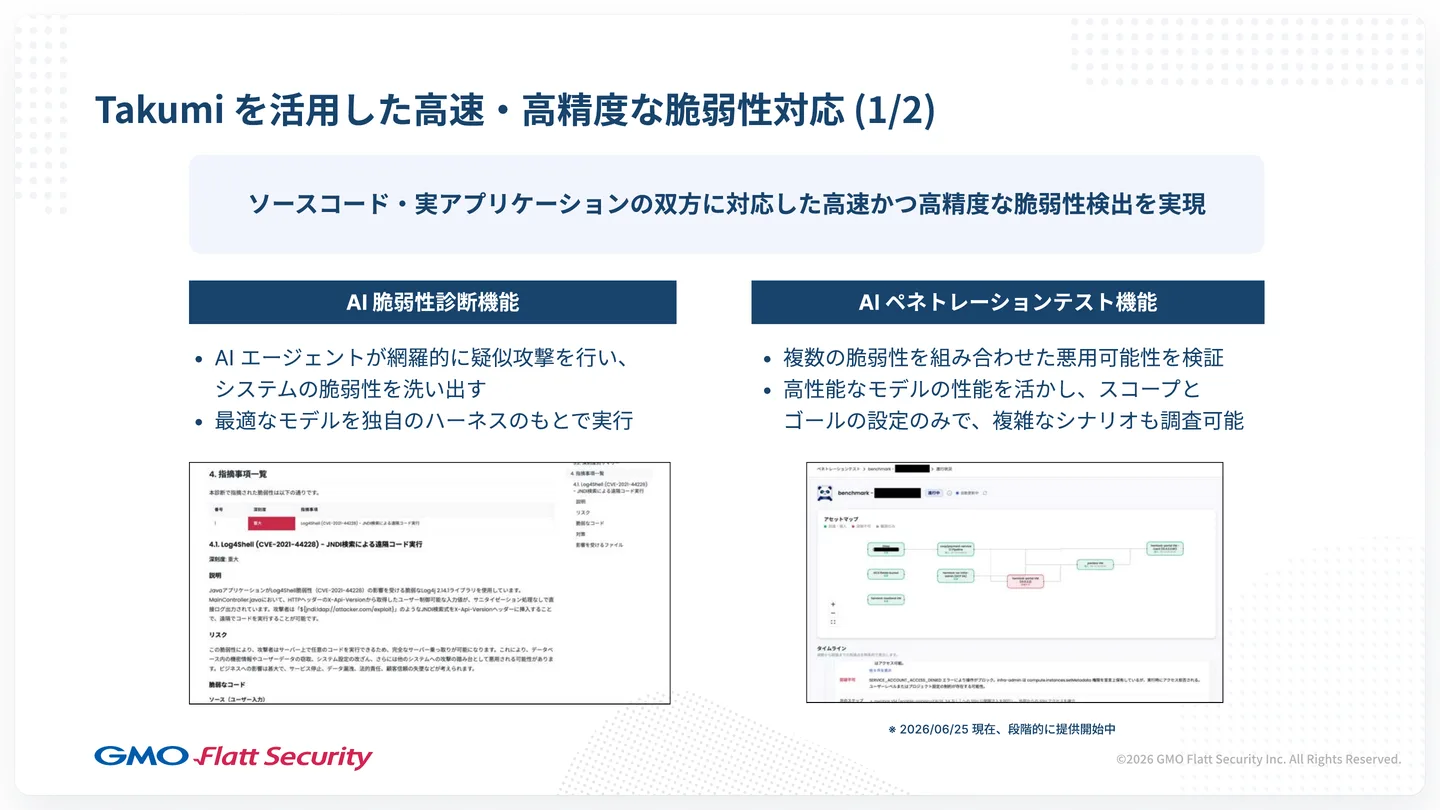
これからの脆弱性の対応には、発見から優先づけ、検証、修正までのライフサイクル全体を AI で高速かつ高精度に回し、継続的に検証し続ける体制が要ります。弊社が、脆弱性の検出と修正を高精度かつ高速に行うセキュリティ特化の AI エージェント Takumi byGMO を提供しているのは、そのためです。Takumi は、ソースコードと実際のアプリケーションの双方に対応した、高速かつ高精度の脆弱性の検出を実現しています。
- AI 脆弱性診断: AI エージェントが、アプリケーションやソースコードに網羅的に疑似的な攻撃を行い、システムの脆弱性を洗い出します。弊社が選んだ最適なモデルを、独自に構築したハーネス、サンドボックス、エージェントの構成のもとで実行しています
- AI ペネトレーションテスト: 複数の脆弱性を組み合わせた悪用の可能性を検証します。最先端のモデルの性能を活かし、どの範囲を攻撃してよいかというスコープと、「このデータベースの情報を攻撃者が取得できないか」といった抽象的なゴールを設定するだけで、複雑なシナリオを自動で調査します。段階的に提供を始めています
注: 2026年10月7日から、AI ペネトレーションテストはすべての組織で、事前の申し込みなしに使えるようになりました。
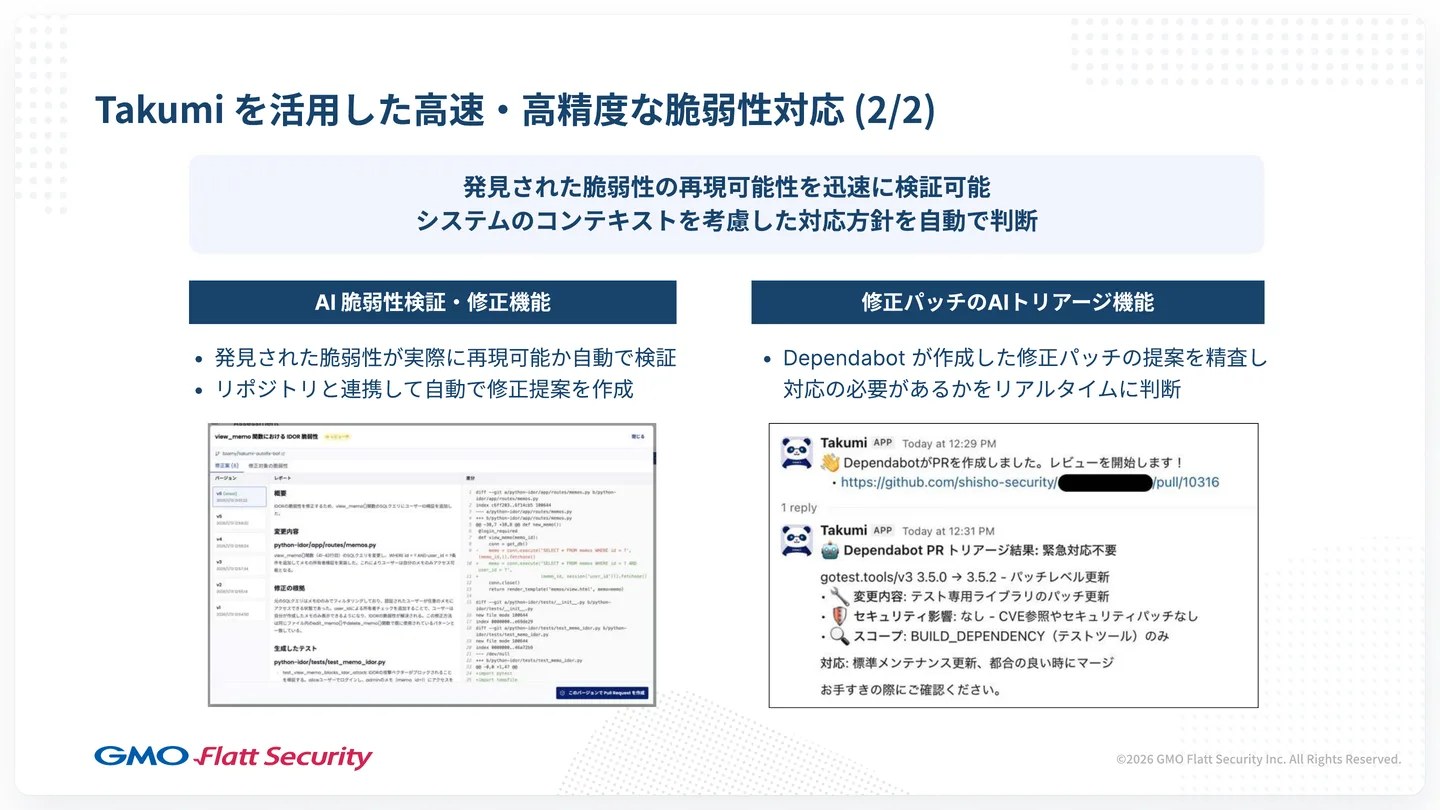
- AI 脆弱性検証・修正: 見つかった脆弱性が、実際の動作環境で再現できるかを自動で検証します。検証できた脆弱性については、リポジトリと連携して自動で修正の提案を作るところまで、一気通貫で行えます
- 修正パッチの AI トリアージ: Dependabot などが脆弱なパッケージを検出してプルリクエストを作ることはよくありますが、その修正パッチがアプリケーションにどの程度影響しうるか、そもそもその脆弱性がアプリケーションで再現しうるかを含めて判断し、リアルタイムに対応します
専門エンジニアが開発初期から支援するセキュア開発コンサルティング
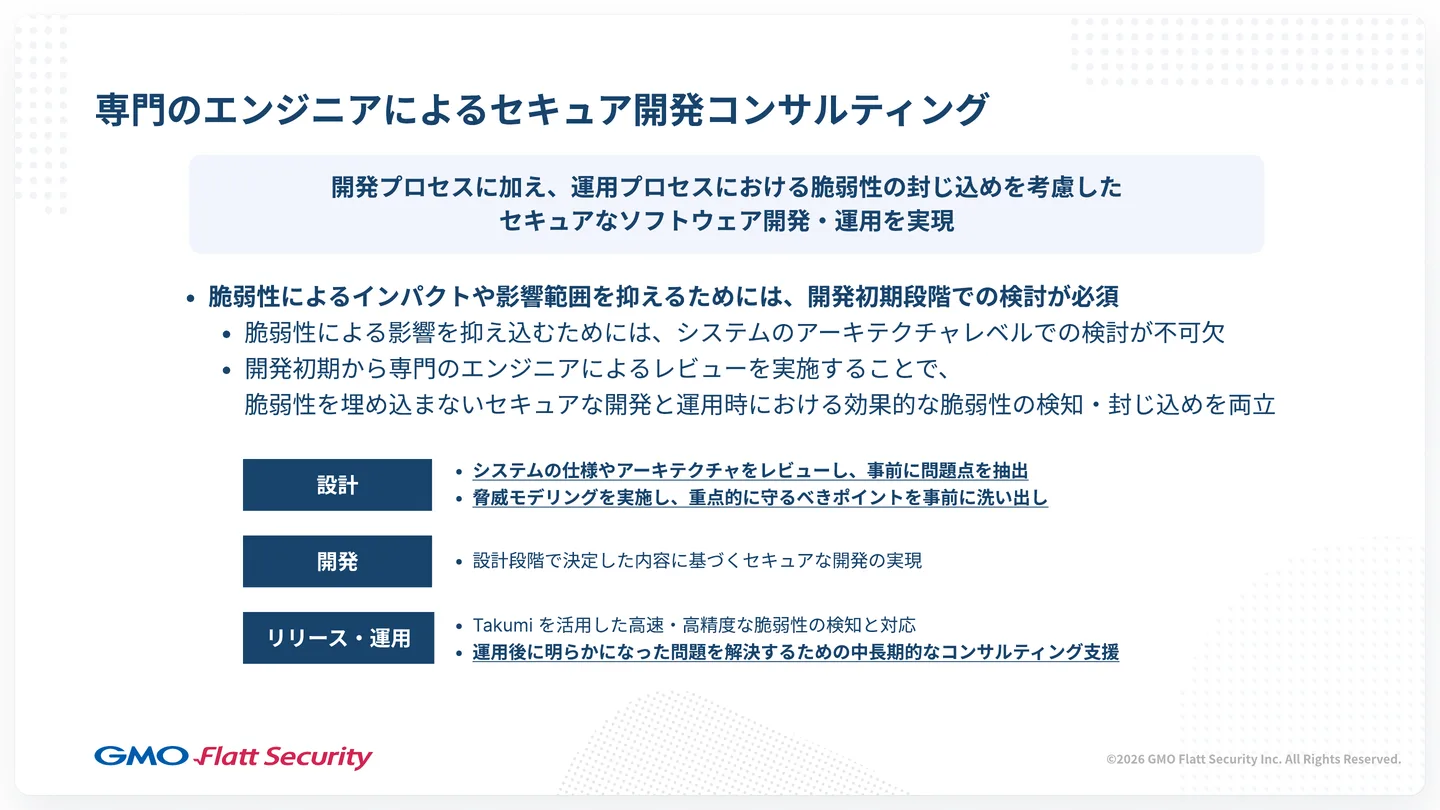
脆弱性によるインパクトや影響の範囲を抑え込むには、開発が始まったあとではなく初期の段階から、システムのアーキテクチャの水準で検討することが不可欠です。開発の初期から専門のエンジニアのレビューを実施すれば、脆弱性を埋め込まないセキュアな開発と、運用時の効果的な脆弱性の検知・封じ込めを両立できます。
弊社は、Takumi による AI のサービスのほかに、脆弱性診断とセキュア開発コンサルティングのサービスも提供しています。コンサルティングでは、設計の段階で伴走しながら、システムの仕様やアーキテクチャをレビューして問題点を抽出し、脅威モデリングを共同で実施して重点的に守るべきポイントを洗い出します。運用後も、明らかになった問題を解決するために、中長期的なコンサルティングで支援しています。